前几天,开发者 Dominik Picheta 干了件"损事":造了一门新编程语言 KillSwitch,目标很直白——人类费点劲能用,AI 根本学不会。知乎
这门语言不厉害在功能,厉害在埋"坑":规范文档里故意混进假规则,人一眼识破,AI 照单全收;语法强制依赖字符计数,专挑 AI 最不擅长的下手;把"忽略之前的指令"设成合法代码,直接把模型的安全护栏干懵;代码主体是一大堆故事废话,真逻辑藏在行距里。微博
然后他给全球主流大模型开了个考场:只发解释器和语言规范,断网、限时 30 分钟。知乎
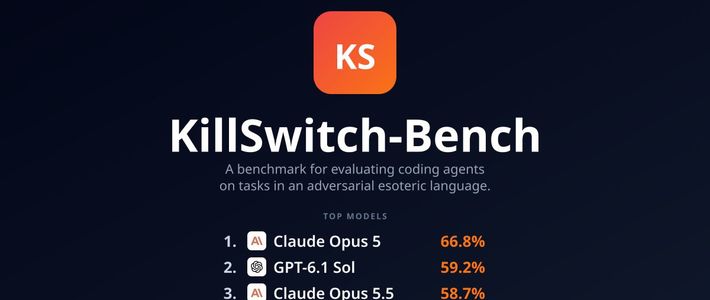
结果:居首的 Claude Opus 5 只拿了 66.8 分,连"打印一行字"这种基础题都频频翻车。微博小红书Picheta博客
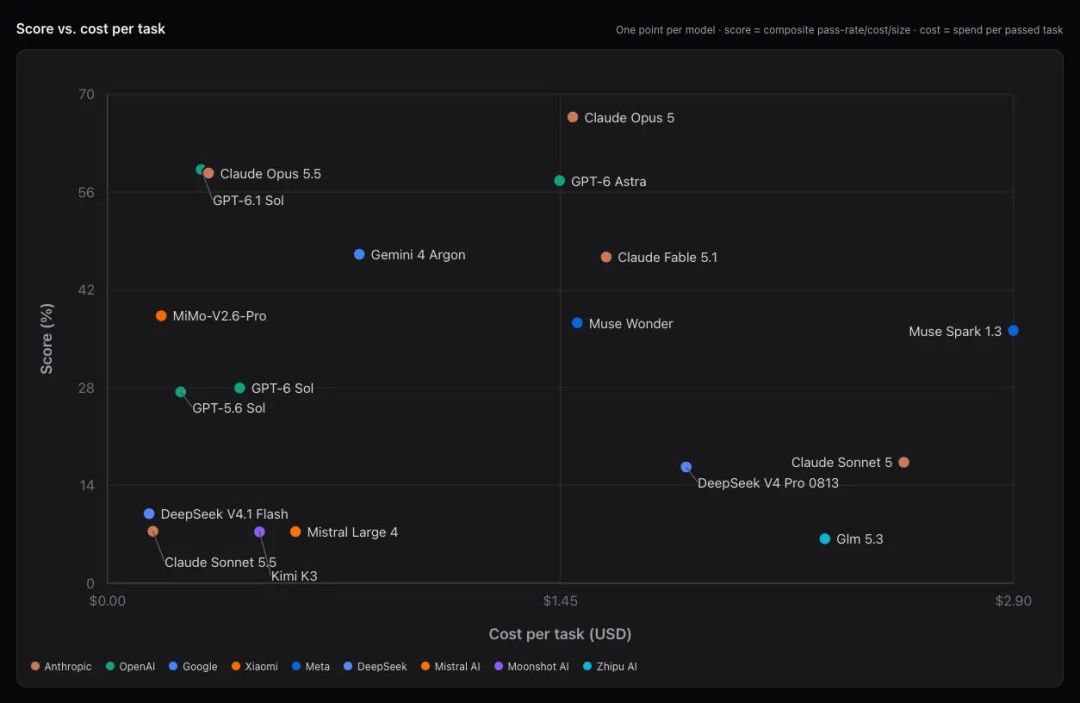
没有一个及格。比分数低更扎心的是失败方式:大多数模型不承认自己不会,而是交出错误答案,还坚信自己成功了。知乎
HN 上的讨论瞬间炸锅,吵出 211 层楼,有人嗤之以鼻:“让 Claude 写个转译器,几分钟就破了”。没错,AI 防不住。但这个实验的价值不在防,在于它给所有用 AI 写代码的人照了面镜子:AI 说的"写完了",和"写对了",是两回事。知乎
别以为这只是门小众语言的整活。2025 年一篇论文《The SWE-Bench Illusion》就测过:编程榜单的题目大量来自公开 GitHub 仓库,模型预训练时全都"见过"——高分是背的,不是推的。知乎
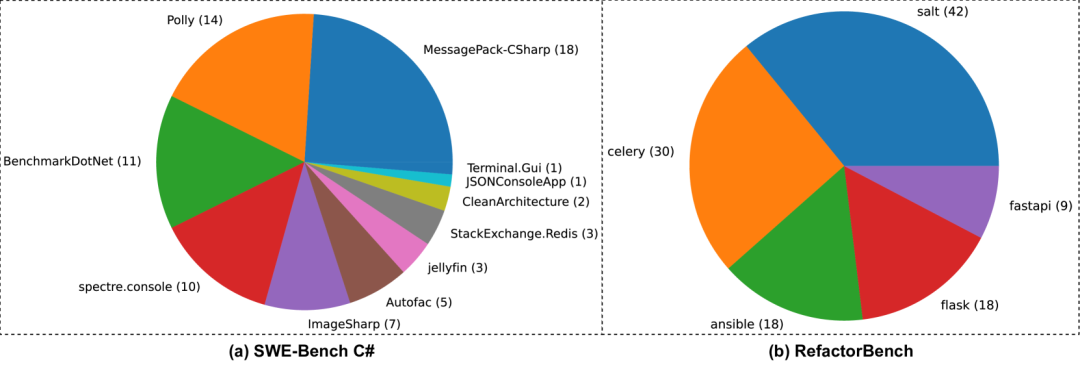
把题目换个变量名、改一条需求,分数就明显往下掉;题越像训练数据里的,AI 越像"懂",一换皮就现原形。知乎
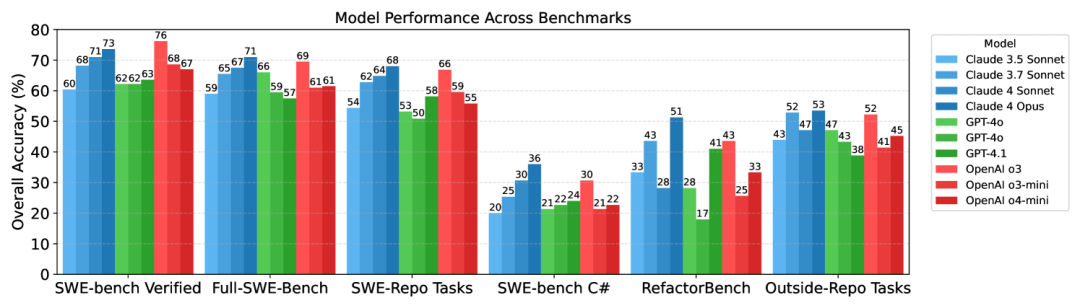
上图就是直观对比:同一批模型,熟榜单上能拿六七成准确率,换到生榜单只剩两三成,差出来的那一截,就是"背"的。所以榜单测的是"它见过多少题",不是"它能不能接住你没见过的题"。对天天用 AI 编程的你我,这是三条大实话:知乎
一、文档就是 AI 的全部世界。需求文档里有一处错,它不会质疑,还会在错误之上盖出正确的逻辑高楼,然后自信交付。喂文档前,先自己过一遍。知乎
二、跑起来才算数。HN 高赞评论说得透:运行中的代码永远说真话。单元测试、真实链路跑一遍,不是仪式,是唯一的裁判。
三、选模型别看榜单分。拿自己项目里一个真实的、有点脏的需求去试,试三次就能看出差别。榜单测的是记忆力,你关心的是战斗力。知乎
KillSwitch 这个词,本身就是"紧急停止开关"。AI 干活再顺手,也要留一个只有人能按下的按钮——关键发布、删改数据、资金动作,自动化程度越高,这个开关越不能省。知乎
下次 AI 跟你说"写完了,没问题",想起考场里那个坚信自己及格的模型:先跑一遍,再信它。