今天上午,一个提问冲上了知乎的讨论热区:工程师吐槽 Claude Code 让人沦为按回车工具人,你怎么看?
描述说得很扎心——有些团队里,从产品规格、PRD、测试,到工单、代码、Bug 修复和报告,几乎所有东西都由 Claude Code 生成,工程师每天干 12~13 个小时,核心动作只有一个:按回车。从 L1 到 L7,大家做的似乎是同一件事:和 Claude 对话,然后按回车。知乎
评论区立刻分成两派:一派感同身受,觉得"灵魂被榨干";另一派反唇相讥——拿着高薪按一天回车,这买卖哪里亏了。知乎
吵归吵,两边谁都没有数据。巧的是,Anthropic 恰好发布了一份大规模研究:约 40 万次 Claude Code 会话、约 23.5 万名用户,覆盖 2025 年 10 月到 2026 年 4 月。它正面回答了这场争论绕开的问题:当你坐在屏幕前"按回车"的时候,你到底在干什么,值多少钱。知乎
一、先看数据:你仍然拥有 70% 的规划决策
研究团队把一次完整会话当成一个协作单元,把其中的决策拆成两类:规划决策(做什么、用什么方案、什么算完成)和执行决策(改哪些文件、写什么代码、跑哪些命令)。
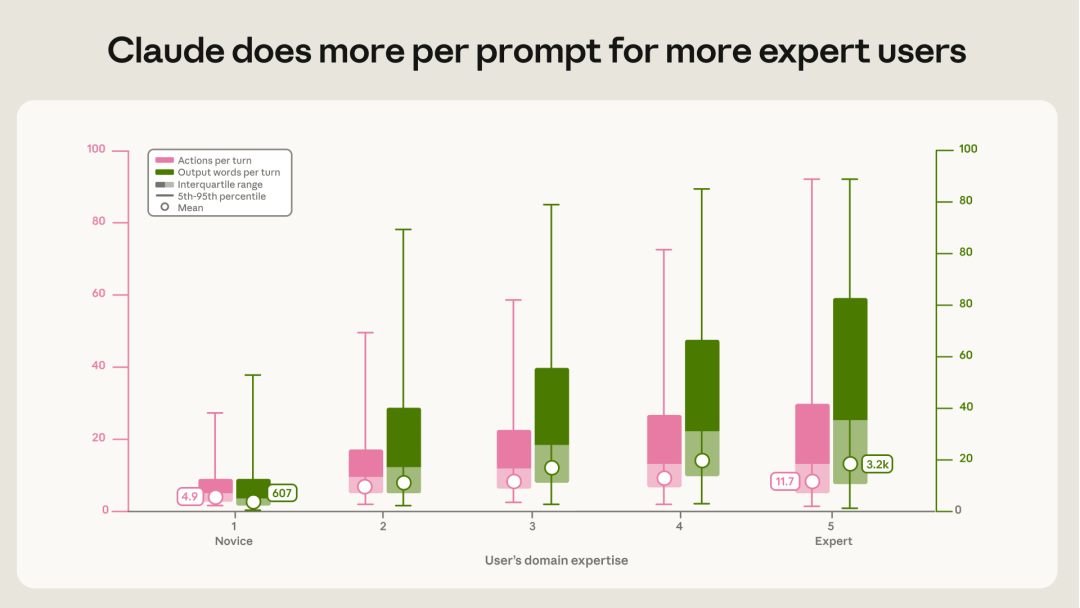
结果是:人做了约 70% 的规划决策,Claude 做了约 80% 的执行决策。典型会话大约 4 个来回,你每次提示平均触发 10 个 Claude 行动,多的时候超过 100 个——读文件、改代码、跑命令、测结果,每回合输出约 2400 词。知乎
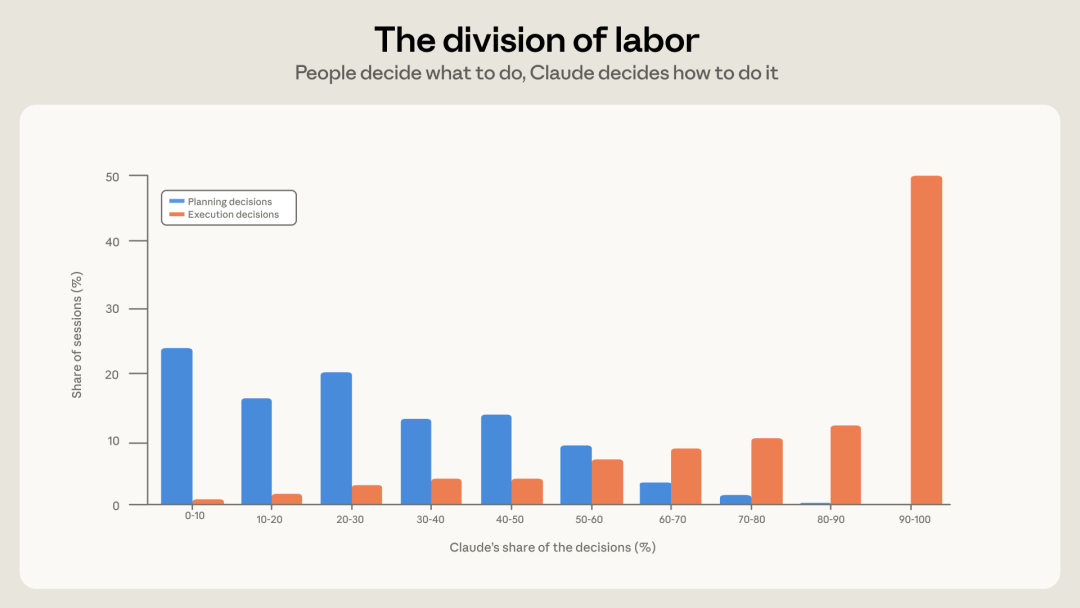
翻译成圈层语言:"按回车的人"的真实画像不是方向盘后面摸鱼的乘客,而是调度员——你说四句话定方向,它替你跑几十步实现。如果一个人感觉自己只剩按回车,问题大概率不是模型太强,而是那四句话你也懒得自己说了。
数据里还藏着一个提醒:当 Claude 同时接管更多规划决策时,每回合行动量会从约 8 个涨到约 16 个。自动化确实能加速,但哪些任务该踩油门、哪些该留刹车,是个需要自己拍板的问题(第四节会回来讲)。
二、真正拉开差距的:专家一句话触发 2.4 倍于新手的行动链
这份研究最反常识的部分,是它给"使用者专长"做的分级——注意,评的不是职位,是你对当前任务所在领域的理解:能不能准确描述问题、知不知道该验证什么、能不能发现 Agent 的错误、能不能提前指出设计取舍。一个懂财务对账规则但没写过 Python 的会计,在财务脚本任务上可以是高专长;一个资深工程师第一次接手陌生 Rust 仓库,一样是新手。
会话者 | 一次提示触发的行动 | 单次提示输出 | 严格验证成功率 | 困难会话验证成功率 | 困难会话放弃率 |
|---|---|---|---|---|---|
新手 | 约 5 次 | 约 600 词 | 约 15% | 约 4% | 约 19% |
中级 | — | — | 约 28% | — | 5%~7% |
专家 | 12 次以上 | 约 3200 词 | 约 33% | 约 15% | 5%~7% |
两个要点:
第一,最大的收益台阶在"新手→中级"这一跳(15%→28%),而不是中级→专家。也就是说,知道如何验证、能识别明显错误,比掌握高级技巧更先决定你能不能把 Agent 用起来。想"让两个不同公司的 Agent 互相检查"当然好,但先学会自己验收。
第二,专家不是 Prompt 写得花,而是能让模型跑更长、更对的动作链。5 次到 12 次的差距,本质是任务建模能力的差距——知道怎么切需求、怎么给约束、结果应该长什么样。知乎
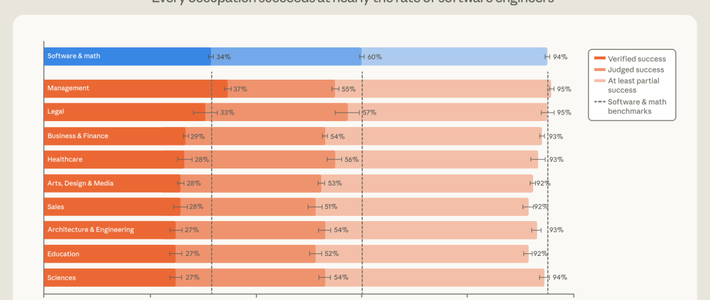
也别拿职业身份吓自己:软件与数学类职业的会话整体验证成功率约 30%,其他职业约 26%;只看真正产生代码变化的会话,是 34% 对 29%。研究的结论下得很谨慎:非软件职业并没有被系统性挡在门外,起作用的不是工牌上的职位名称,而是领域理解。知乎
三、半年时间,Agent 干的活已经变了
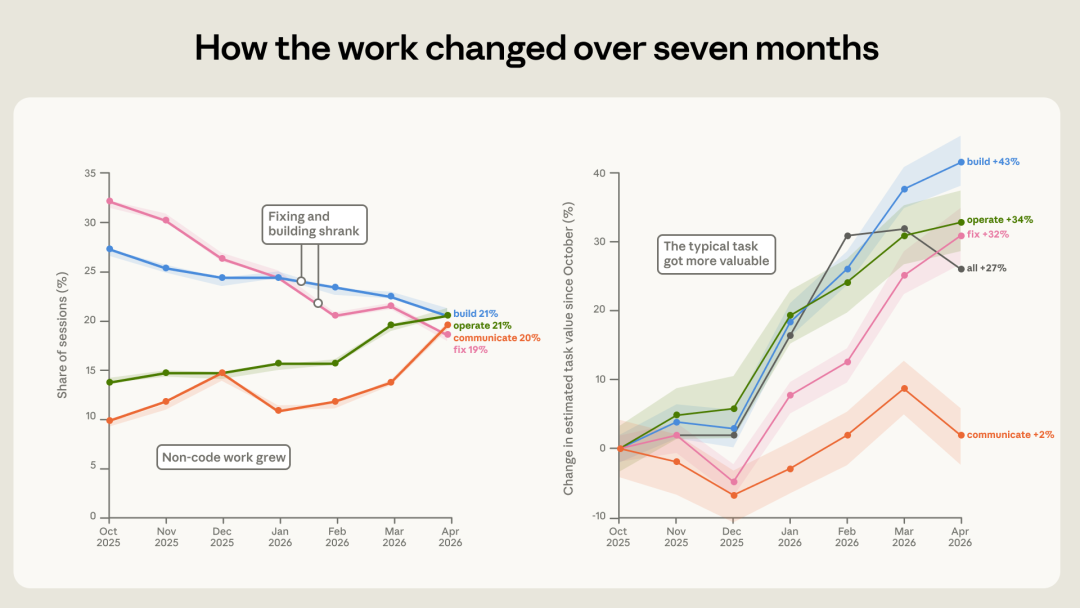
比快照更有意思的是时间对比:从 2025 年 10 月到 2026 年 4 月,调试型会话占比从 33% 掉到 19%,运行软件、写文档、数据分析的占比在上升。知乎
九类工作模式的全景是:修故障 26%、构建新东西 25%、运行软件 17%、写文档和演示文稿 10%、理解系统与规划改动各 7%、编排 Agent 与分析数据各 3%、测试代码 2%。
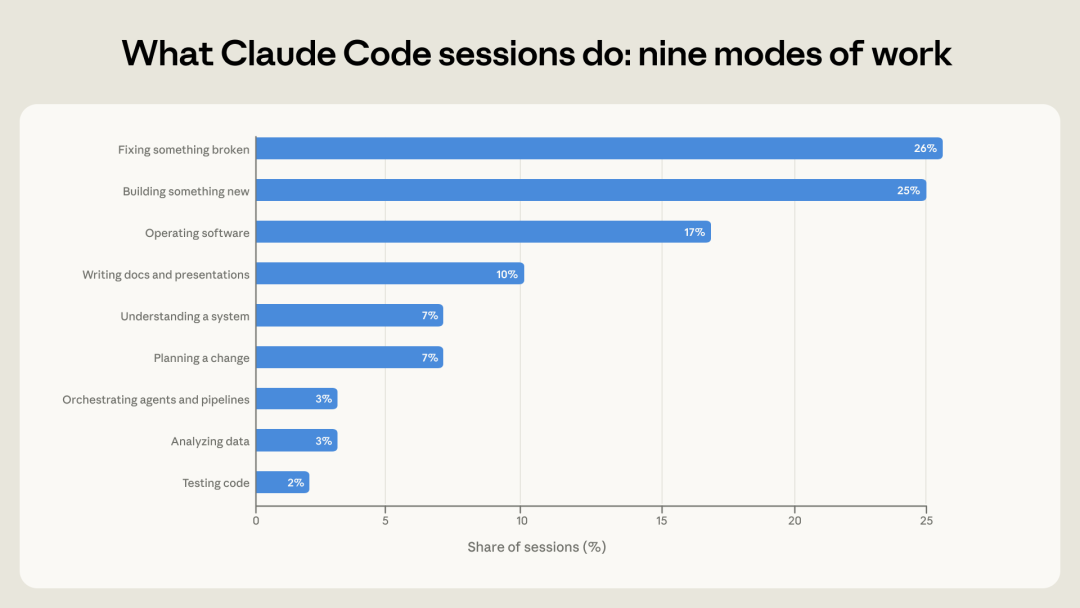
也就是说,“编码 Agent"早就在干比写函数更宽泛的活:部署服务、配环境、读懂旧系统、写汇报材料,都在同一个会话窗口里发生。一边是社区里"AI 写的代码能跑、一上线就炸”"写代码更快了、排错更慢了"的吐槽帖持续刷屏,一边是调试会话占比半年掉了近一半——这两件事并不矛盾:模型生成的 bug 正在被更多自动化消化,但"这功能到底能不能活过生产环境"的验收,依然压在人身上,而多数人恰好没在这上面升级。
四、别把数据读过头
Anthropic 给自己的研究划了边界,这些限制值得原样传达:
会话级"成功"不等于代码最终被采用、过了上线评审,更不是业务结果;
任务价值估算(分组均值约 +27%,摘要口径约 +25%)是按自由职业市场岗位做的近似,不等于真实收入;
任务、专长、结果的分类都依赖模型读取会话文本推断,虽然用了遥测交叉核验,分类器仍然可能出错。知乎
所以这份数据能回答"人和 Agent 怎么分工、差距出在哪",回答不了"程序员会不会被替代"。后一个判断,目前的证据还不够格下结论。
五、所以,"按回车工具人"该不该焦虑?
给每天在用 agentic coding 干活的人三个能落地的判断:
拿"规划决策占比"照镜子。 如果你还答得出"做什么、怎么算完成",按数据口径你不是工具人,只是工作方式换了;如果答不出,换更贵的模型也救不了你——那是领域问题,不是工具问题。
把钱投给验收,而不是 Prompt 技巧。 15%→28% 的那一跳是眼下性价比最高的升级:开工前先写完成标准,验收时要求 Agent 给证据(变更文件、命令输出、测试结果、待确认项),而不是一段看起来合理的总结。社区里那篇《别把 Claude Code 当聊天框:一套「确定性工程」落地手册》说的其实是同一件事:让约束变硬,比让模型变聪明见效快。
权限按任务风险分层,别一刀切。 低风险的格式化、测试、批处理可以放开自动跑;碰生产发布、财务数据、隐私材料、不可逆变更的,保留人工确认。这也是研究给出的产品建议。
值得继续盯的信号有三个:专长带来的成功率差距是否在缩小、非软件职业的代码会话是否继续增长、Agent 是否开始补足本该由人提供的关键判断。如果第一个差距真开始抹平,"工具人"的争论才立得住——到时候再换问题也不迟。