折腾圈这两天的话题从NAS换成了“Token自由”。知乎上“很多人认为本地部署一个大模型,就实现token自由,就可以干活了,真的吗”这个问题挂出来几天,浏览量就到了161万。小红书上的两篇装机实测帖也在持续升温。大家做的事一样:把开源模型装进自己的机器,从API计费和限流里解放出来。知乎小红书小红书
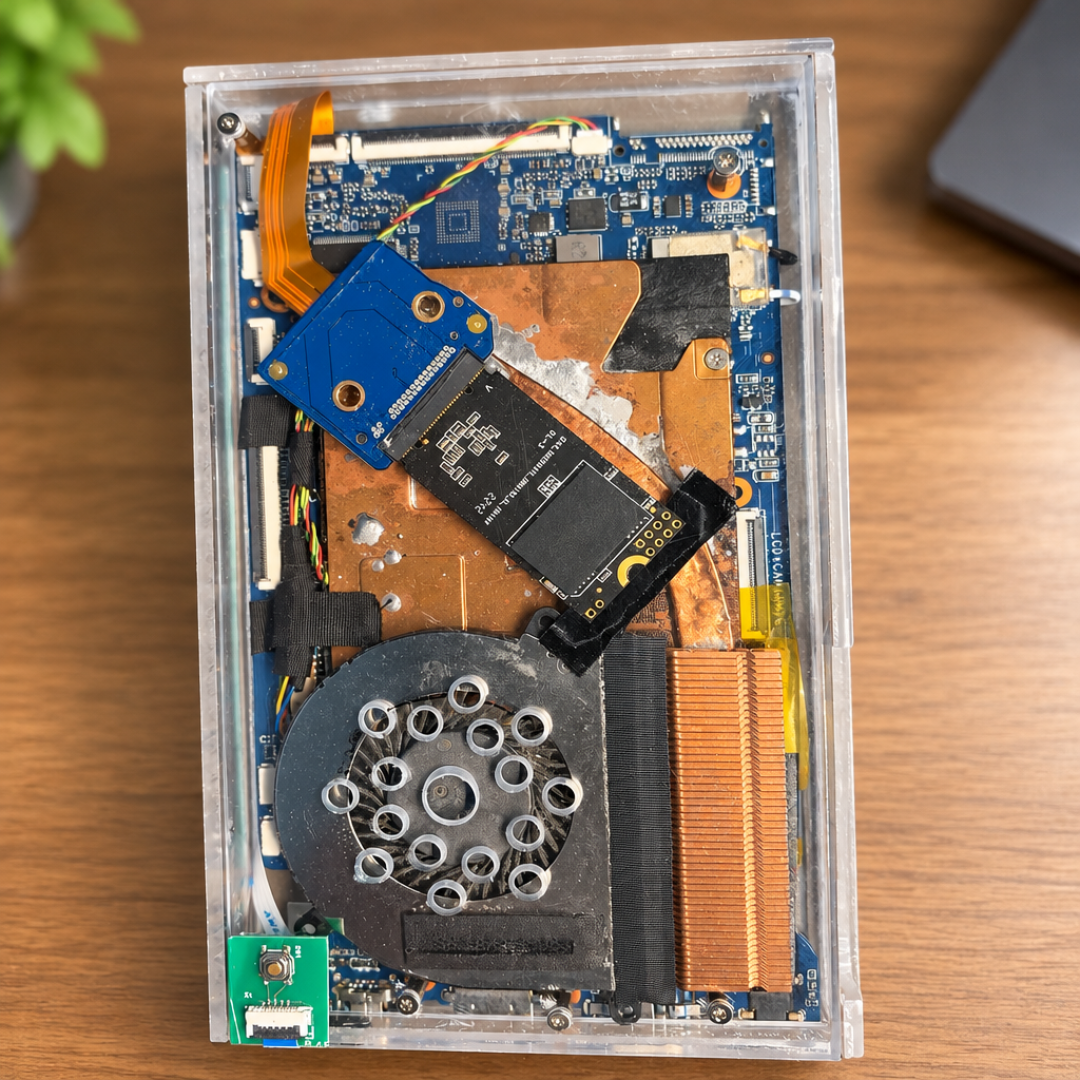
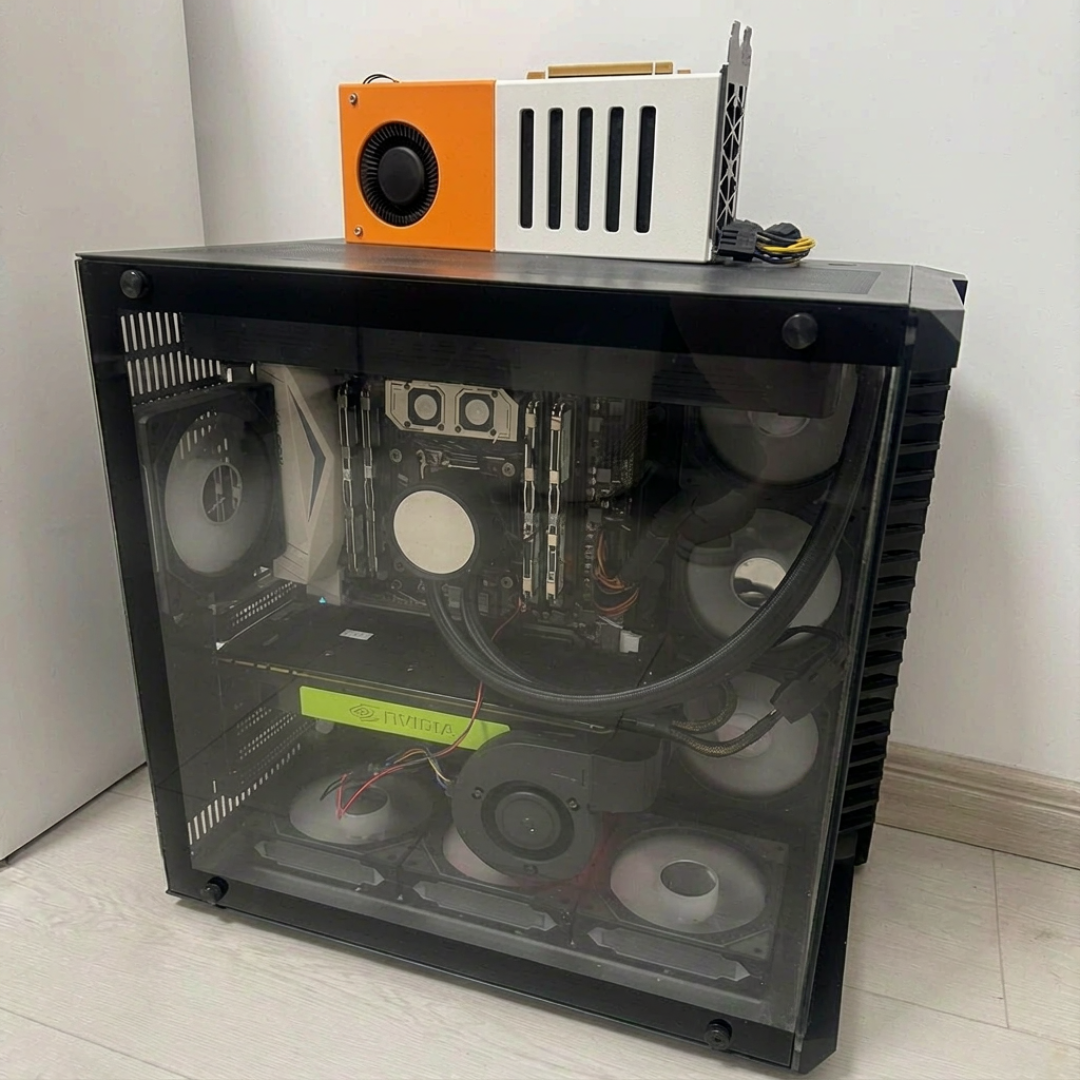
晒得最狠的是洋垃圾方案:一位用户全套两千块出头,E5 2673 v3处理器、笔记本版RTX 3060、四根32G DDR3内存,输出平均55-65 tokens/s,CPU加显卡功耗一百二十瓦,正干着生成前端页面代码的活。知乎
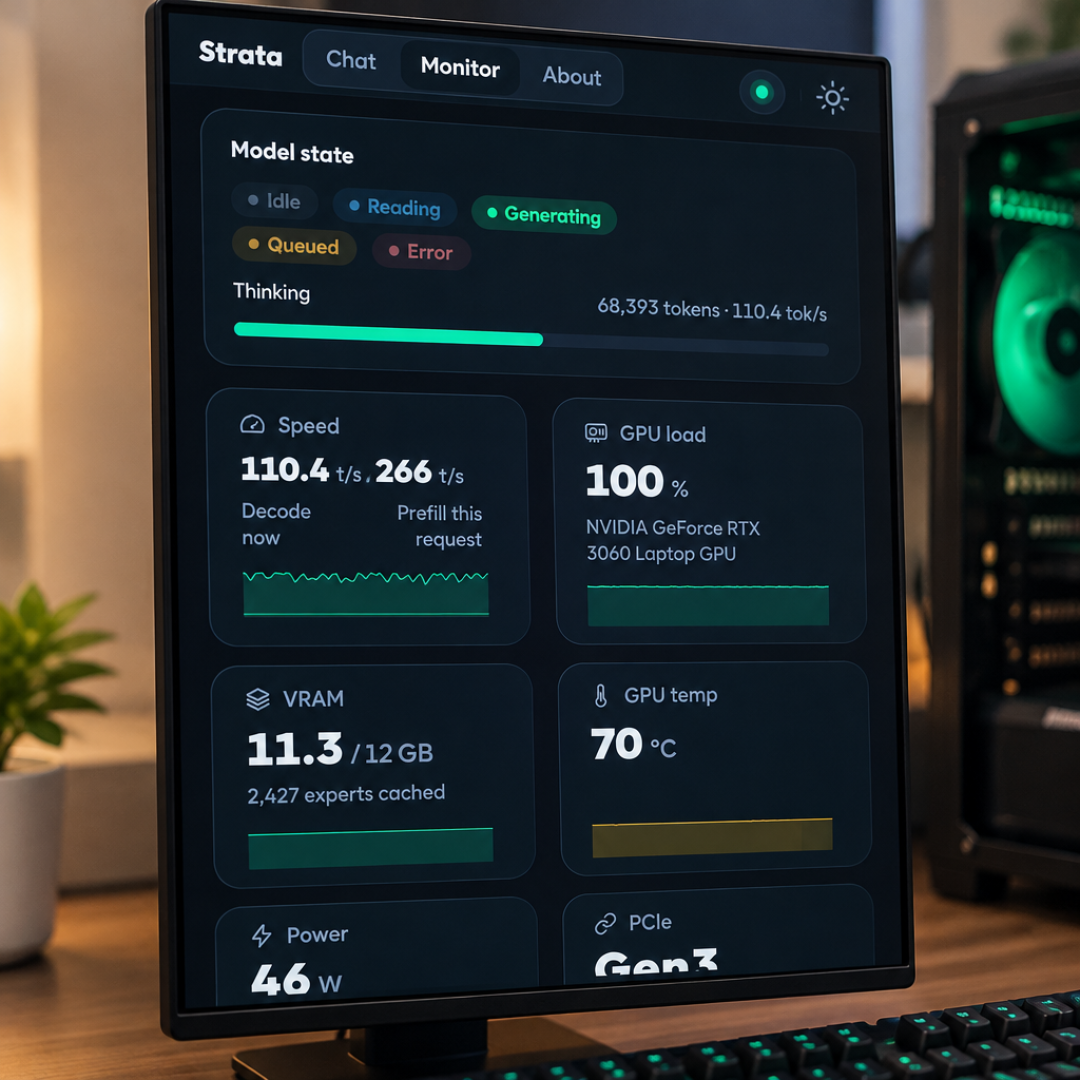
小红书上有人把价压得更低:实际装机2900元,理论低价方案只要1420元,256K上下文下decode仍有每秒40个token。但短板也露得直白:prefill不到400 tokens/s,256K输入一灌进去会撞上300秒超时限制,只能手动把配置改到3600秒。满速涡轮扇的噪音,他也没回避。小红书
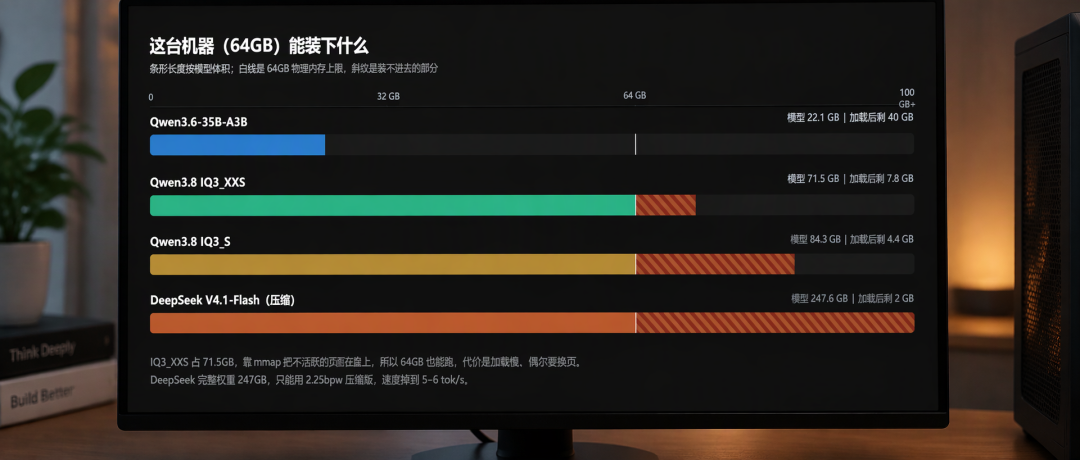
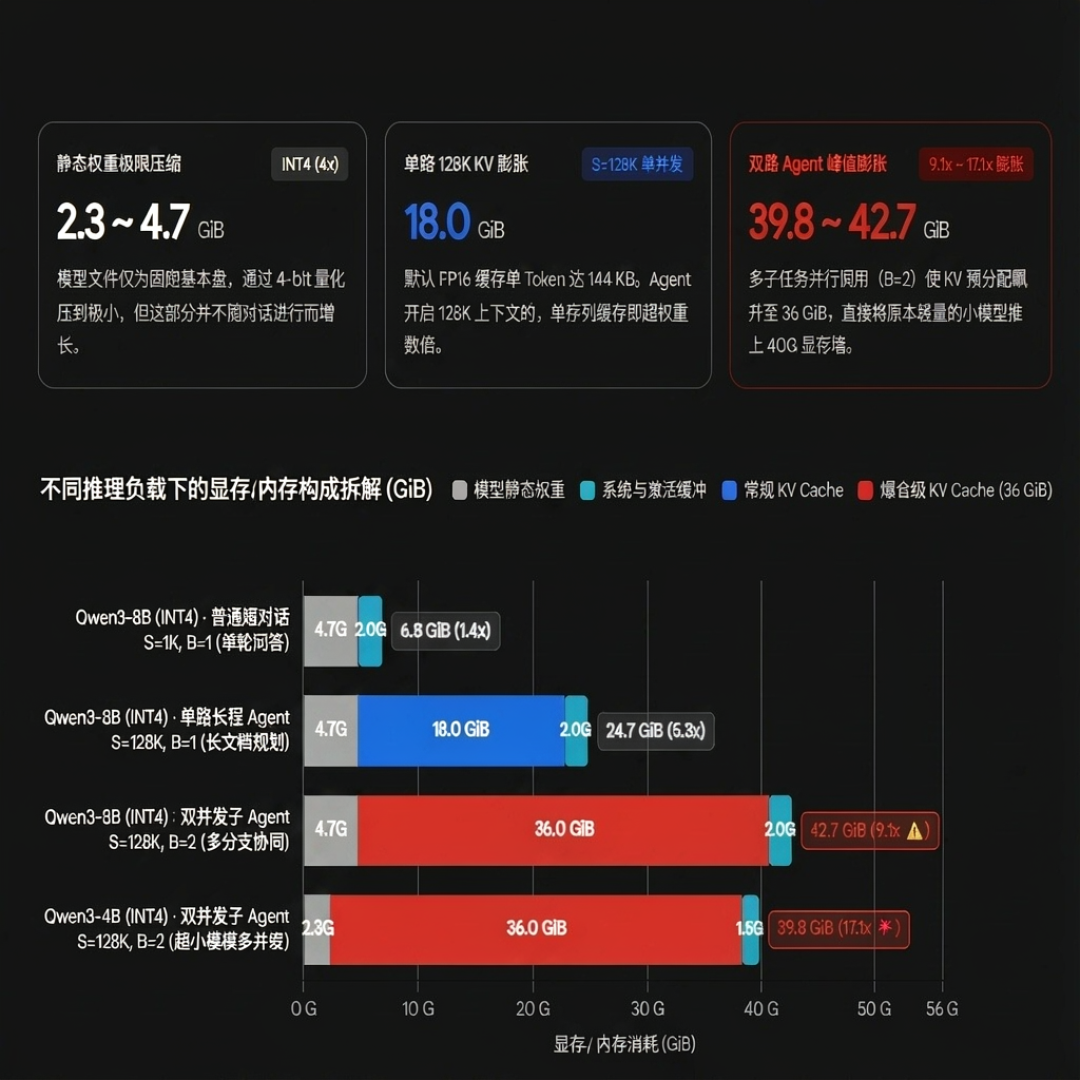
第一笔账是内存。64GB DDR5配RTX 5060 Ti 16GB跑了两个月的人实测:84.3GB的模型加载完只剩4.4GB内存余量,浏览器标签多开几个就触发换页,速度从40 tokens/s掉到个位数。他的结论是16GB显存跑100B级MoE够用,真正卡住你的是内存。更隐蔽的坑在Agent场景:一个2.2GB的模型文件,光记住128K上下文的历史就要吃掉约18GB,内存原地膨胀近九倍。知乎知乎
第二笔账是盘的位置。同一份98GB的权重,本机NVMe冷读18.3秒,放NAS要15.6分钟,差51倍。卡点是千兆链路,这类模型把专家库放内存、词表放SSD,赌的是命中率,网络盘补不上。他算过:一块2TB企业级NVMe一千出头,比换交换机加网卡升2.5G的两千块起便宜一半。知乎
第三笔账是时间。那台64GB的机器写一段1794个token的输出,花了317秒。256GB统一内存的Mac Studio日常能跑到60~130 tokens/s。但256K输入、缓存零命中的最差场景,首token也要等近六分钟。这位Mac用户还跑了笔账:4bit量化连续干24小时,折成API价格大约60块。他自己说,重点在掌控数据和定制参数,省钱“在其次的其次”。知乎小红书
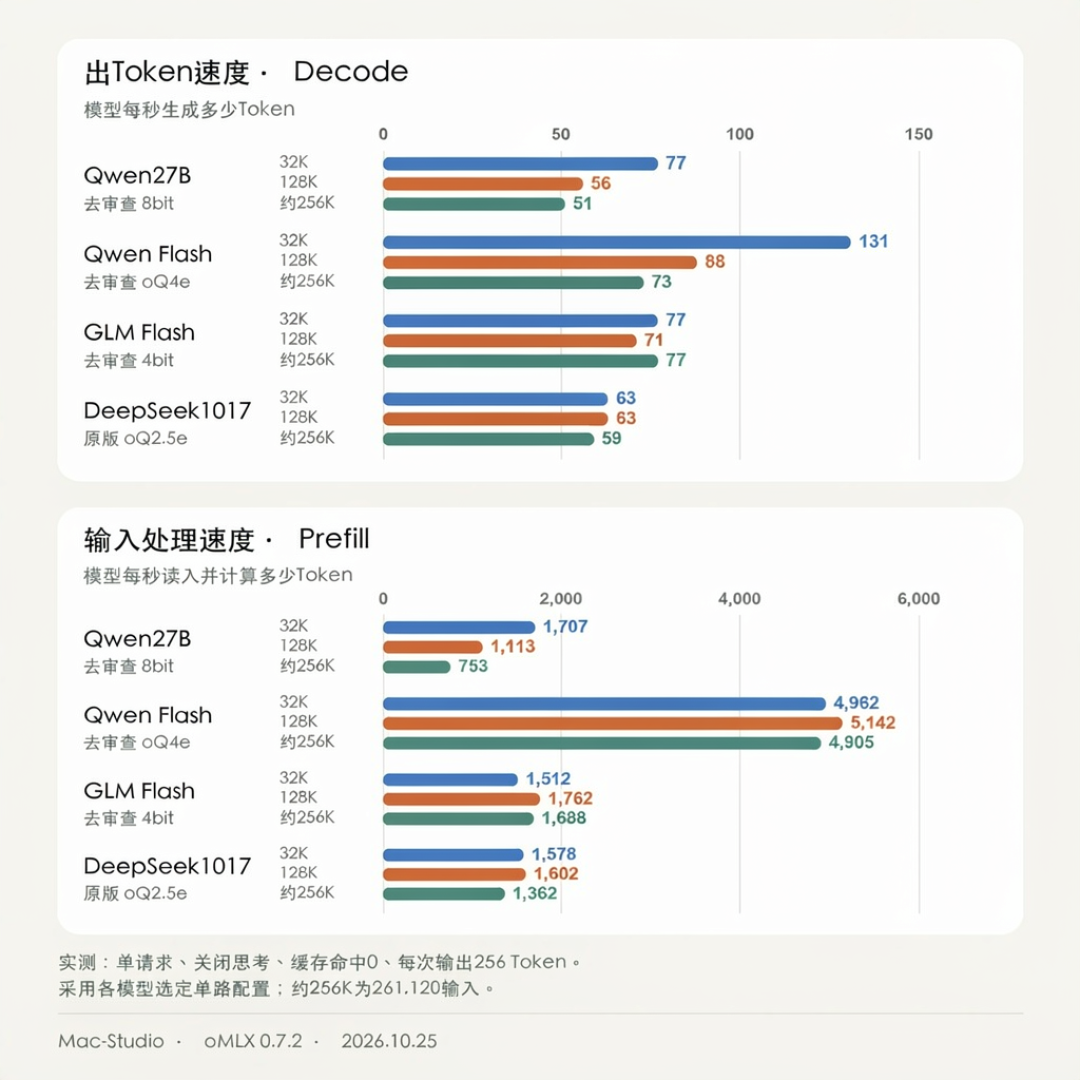
值不值得上车,标准很具体。跑过几个月的人给出的共识:单文件代码生成、文档改写、批量脚本、离线分析,本地模型已经够用;需要一次做对的复杂任务,还是交给云端。适合折腾的是有离线长任务、数据不方便出门、或者就想自己攒机器的人;偶尔用AI干活的,现阶段的云端额度更省事。另外内存行情还没停涨,板载内存的魔改机器反而越卖越多。预算和耐心,最好都按三笔账算完再定。知乎知乎