















30
50
语音克隆 TTS:短视频解说配音工具的技术取舍与边界
2026-11-13 11:59:22
0点赞
0收藏
0评论
前言:本文为独立技术科普,无商业合作,不做种草推荐。我们聚焦短视频创作里经常用到的短视频解说配音克隆工具,从 TTS 声纹复刻的底层逻辑出发,聊聊四款主流方案的设计思路、能力上限与固有短板。
很多做短视频解说的创作者都会接触 AI 语音克隆。不少人只关注 “克隆出来像不像”,却很少意识到:不同工具听感上的差别,本质是模型在训练目标、数据分布、工程落地路线上做出的取舍。语音克隆不是简单的 “复制声音”,它是在文本转语音模型之上,增加了声纹条件控制模块,主流架构分为声纹编码器 + 声学模型 + 声码器三段式链路。
基础概念:少样本语音克隆的实现逻辑
当下面向普通创作者的短视频解说配音克隆工具,绝大多数都属于少样本(Few-shot)声纹条件 TTS,区别于全参数微调、预训练专属 TTS。 完整链路拆解:
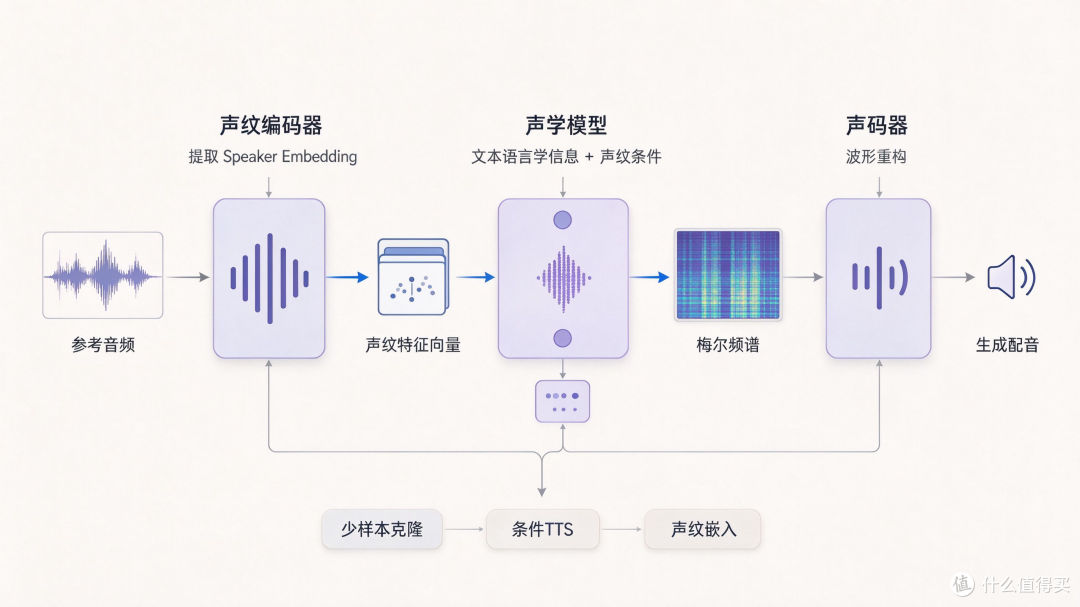 技术原理图
参考音频送入声纹编码器(Speaker Encoder),提取固定维度的说话人嵌入向量(speaker embedding),编码基频 F0、频谱包络、共振峰、语速韵律习惯等声学特征;
将 speaker embedding 作为条件输入声学模型,结合文本前端语言学解析(分词、多音字、韵律标记),生成梅尔频谱(Mel-spectrogram);
声码器(Vocoder)把梅尔频谱还原为时域波形,再经过后处理做增益、降噪、相位修复,输出最终配音。
这里有一个关键区分:少样本克隆 ≠ 高保真定制 TTS。 少样本方案优势是样本短、训练快、推理算力需求低,适合个人创作者快速上手;代价是 speaker embedding 携带信息有限,跨情绪、跨语速泛化弱。而专业定制 TTS 需要几十小时标注语料,做全参数微调,属于域内定制,成本极高,基本不会面向短视频创作者开放。
四款工具的技术定位拆解
剪映:剪辑链路内嵌的轻量化条件 TTS,基于离散韵律 + 轻量声码器
剪映内置的语音克隆,不是独立语音引擎,而是集成在剪辑流水线中的轻量分支。它采用预训练基座 TTS + 对比学习声纹编码器,声码器偏向轻量化 GAN 类声码器,推理速度优先,方便在移动端、网页端实时生成。 工程上的核心优化点是对齐剪辑时间轴:生成音频自带时间戳,直接关联字幕轨道,省去音频对齐、格式转码的额外开销。 技术短板来自模型轻量化约束:它的韵律建模是离散韵律 token,可选停顿、重音模式是有限集合,不是连续韵律空间。长篇叙事解说时,很容易出现韵律模板化,F0 曲线变化单一,缺少自然人声里的微起伏,悬疑、递进类文案机器感会比较明显。 它的设计目标,不是极致拟人,而是在低算力设备上快速完成短视频配音生产闭环。
悄然声色:面向中文叙事优化的少样本 TTS,侧重韵律 prompt 对齐
悄然声色的基座模型针对中文叙事口语做了专项调优,声纹编码器采用 Metric Learning 度量学习方案,在短样本(10–30s)条件下,speaker embedding 的区分度更高,对日常口语、闲聊式解说的共振峰特征捕捉更友好。 它额外加入了韵律控制 prompt 模块,可以单独调节 F0 均值、语速、停顿时长、呼吸音密度,这也是影视解说、故事类创作者常用它微调语气的原因。 但它的缺陷也是少样本方案典型缺陷:编码器对信噪比 SNR 非常敏感。如果样本混响 RT60 过长、底噪高,噪声频谱会被嵌入向量一并编码,生成波形会伴随周期性毛刺、频谱畸变;当目标情绪和参考样本 F0 分布差距过大时,会出现韵律崩坏、断音、音色漂移,这种情况只能靠逐句参数补偿,无法由模型自主推理。
讯飞配音:工业级前端语言学 + 可控声纹复刻,基于成熟端到端 TTS 工程体系
讯飞配音的声纹复刻,搭建在工业化 TTS 基座之上,最强的模块是语言学前端(Text Frontend):包含分词、词性标注、多音字消歧、韵律边界预测、专有名词库匹配,是国内较早落地大规模语言学规则 + 预训练联合消歧的方案。 它的声纹复刻走受限克隆通道,声纹采集、身份核验和生成链路绑定风控,对齐深度合成管理的合规要求。声学模型偏向自回归 TTS,声码器为高保真线性预测声码器,波形稳定性强,读专业术语、长技术文稿错读、漏读概率低。 对应的取舍:模型的韵律空间是偏向播音腔的规整分布,优先保证可懂度、清晰度,对非标准口语、随性的叙事语调的建模权重低。想要松弛、带有个人口语习惯的解说声线,因为语言学前端会强制规整韵律边界,可调空间会被压缩。
ElevenLabs:以韵律动态建模为核心的非自回归 TTS,连续 F0 建模优势突出
ElevenLabs 的核心技术亮点是连续韵律建模,它的声学模型不依赖离散韵律 token,直接学习连续 F0 轨迹、能量曲线、时长分布,对轻重音转折、呼吸间隙、语调滑变的表现力在英文数据集上表现很强,这也是它情绪表现力出圈的根本原因。 但它的瓶颈来自训练数据分布:基座预训练语料以印欧语系为主,中文是声调语言,声调是区分语义的核心,模型缺少足够中文声调域数据,声调归一化、变调(上声变调、轻声)建模不足。中文长句、网络口语、连读变调场景,容易出现调型错位、语感违和。同时它的推理链路在境外,计费以 token 为单位,高保真模式推理开销显著高于普通少样本克隆。它更适合多语种内容本地化,而不是中文解说的最优选择。
所有短视频解说配音克隆工具共有的技术瓶颈
这些瓶颈是当前阶段少样本条件 TTS 的共性问题,不属于某一款工具的缺陷:
模型没有上层语义理解。声学模型只学习文本→梅尔频谱的映射,不理解语义、情绪。它不会根据文案语义自动调整 F0 和能量,情绪变化只能局限在参考样本的韵律分布内;
声纹嵌入向量的分布局限性:speaker embedding 是一个固定向量,不是动态说话人模型。样本里没有出现的情绪、响度区间,属于分布外 OOD(Out-of-Distribution),生成稳定性大幅下降;
样本信噪比 SNR 与混响是强约束:带 BGM、压缩失真、长混响的音频,频谱被污染,编码器提取的嵌入向量是噪声 + 人声混合特征,生成音频会持续带有畸变;
合成音频存在声学指纹:AI 生成波形在高阶频谱、相位结构上存在和真人不同的特征,可通过声纹检测、伪影检测模型识别,也是平台风控识别合成音频的依据。
合规边界:技术可行不等于使用合法
技术上可以提取声纹、复刻音色,不代表拥有使用权限。自然人的声音属于人格权益,按照《深度合成管理规定》,深度合成人声需要标注、核验声源授权。从技术层面补充一点:声纹本身属于生物特征,平台存储、调用声纹向量也受数据合规约束。 无论使用哪一款短视频解说配音克隆工具,未经许可克隆他人声纹用于解说、变现,都存在侵权风险。另外商用授权独立于技术能力,免费推理额度一般只开放测试,不代表授予商用授权。
收尾总结
四款工具的差异,本质是研发团队在不同技术指标之间做权衡:有的优先移动端低延迟推理、剪辑链路集成;有的优化短样本下中文叙事韵律可控性;有的强化语言学前端、波形稳定性与合规流程;有的主打连续韵律动态建模,在多语种情绪表现力上做突破。不存在一款在信噪比、泛化、推理速度、语言学准确率全部拉满的全能方案。
语音克隆只是条件 TTS 的一类应用,它解决的是反复录音的体力成本,解说视频的叙事节奏、文案信息密度依然是内容核心。工具只是创作者的音频生成辅助,不能替代内容本身。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~





