














 深耕数码兴趣领域






28
35
极摩客 EVO-X5 Pro 亮相 :192GB 端侧超算,本地跑 320B 大模型
2026-10-23 17:09:23
2点赞
0收藏
2评论
Hello,大家好,我是漫画!
极摩客 EVO-X5 Pro 亮相北美 PyTorch 大会:192GB 内存端侧超算,本地跑通 320B 大模型
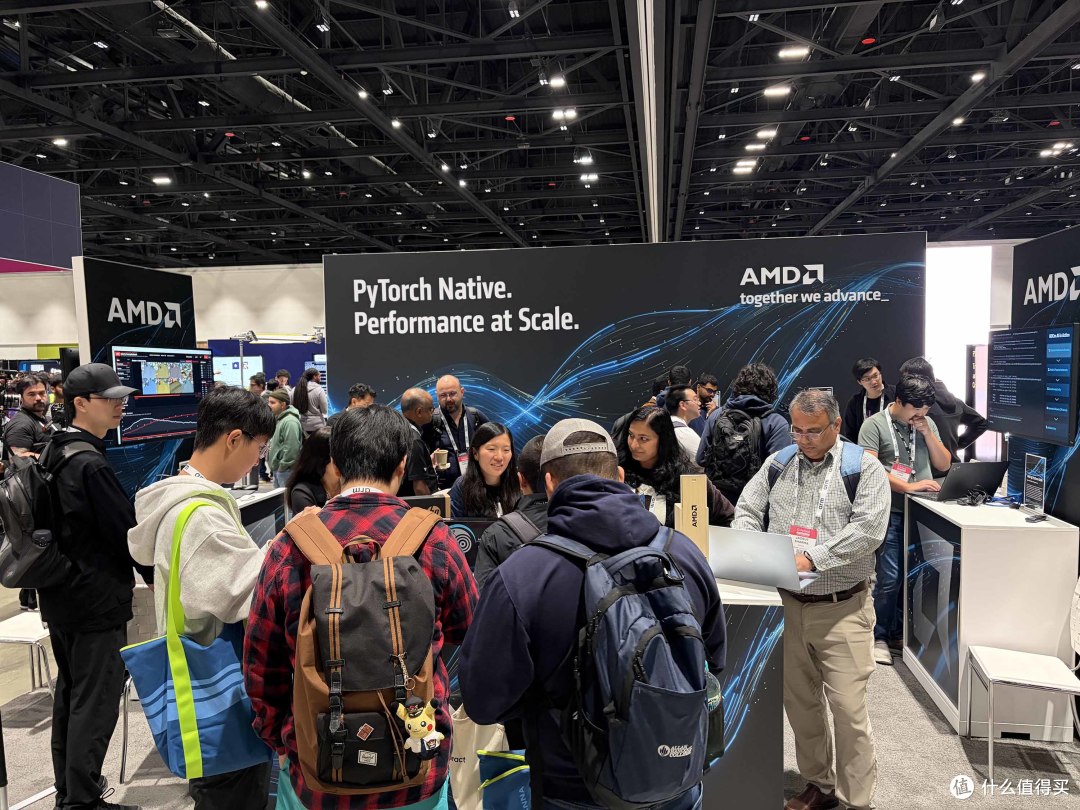
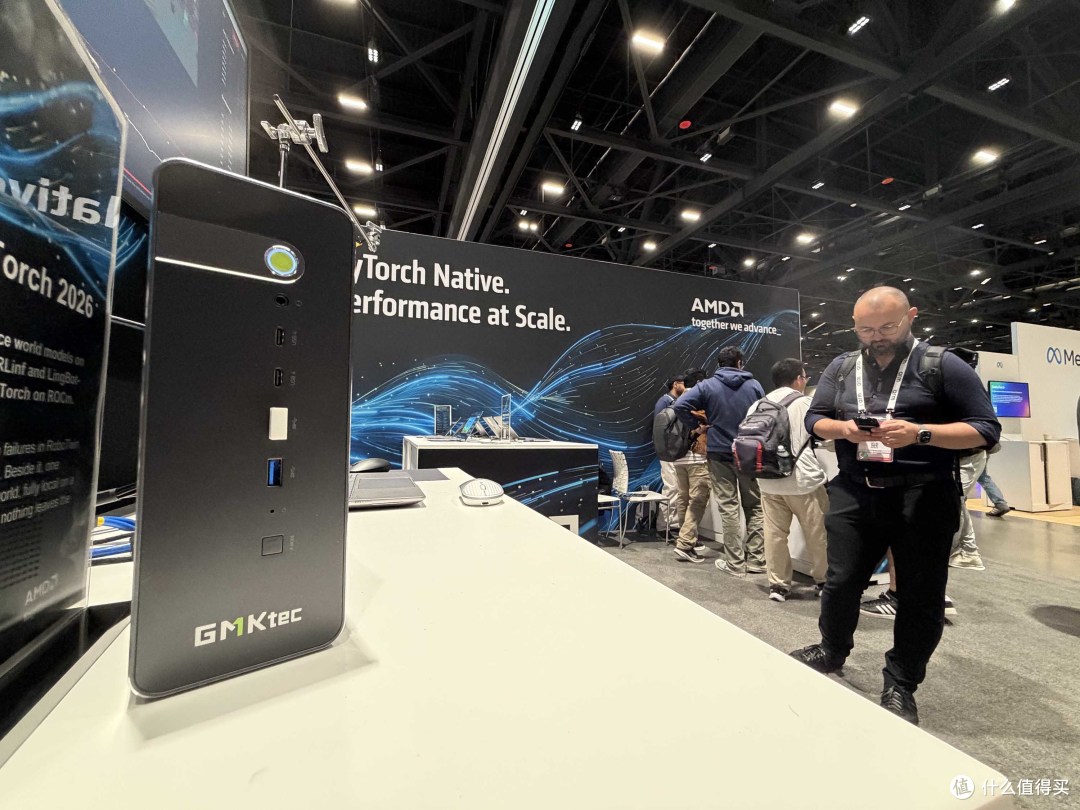
加州圣何塞,2026 年 10 月 21 日 —— 桌面AI超算品牌极摩客(GMKtec),旗下旗舰新品 “EVO-X5 Pro”于 10 月 20 日至 21 日登陆在加州圣何塞举办的 “北美 PyTorch 大会(PyTorch Conference 2026)“,面向全球开源 AI 开发者现场展示端侧大模型推理与世界模型迭代的完整算力方案。
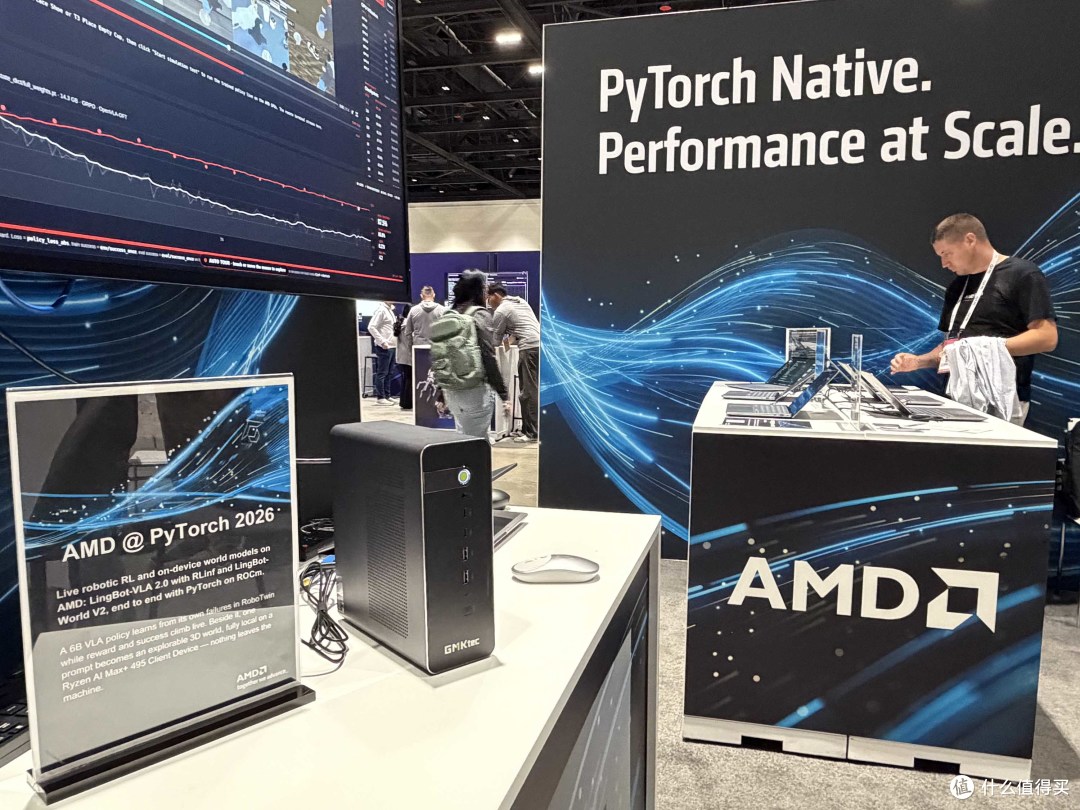
现场直击:把 "本地 AI 超算" 搬上开发者桌面
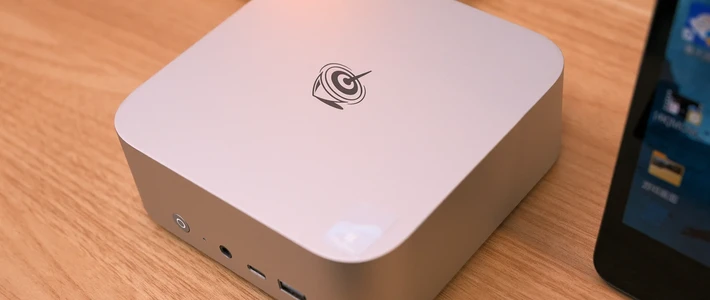
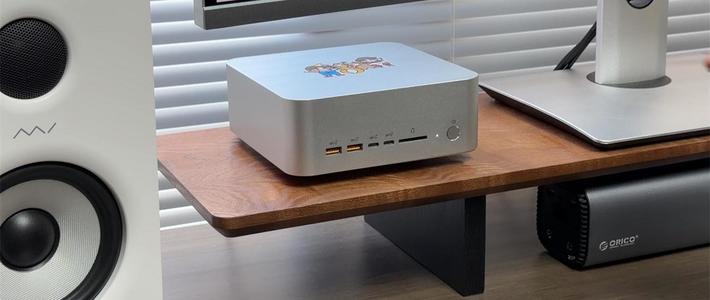
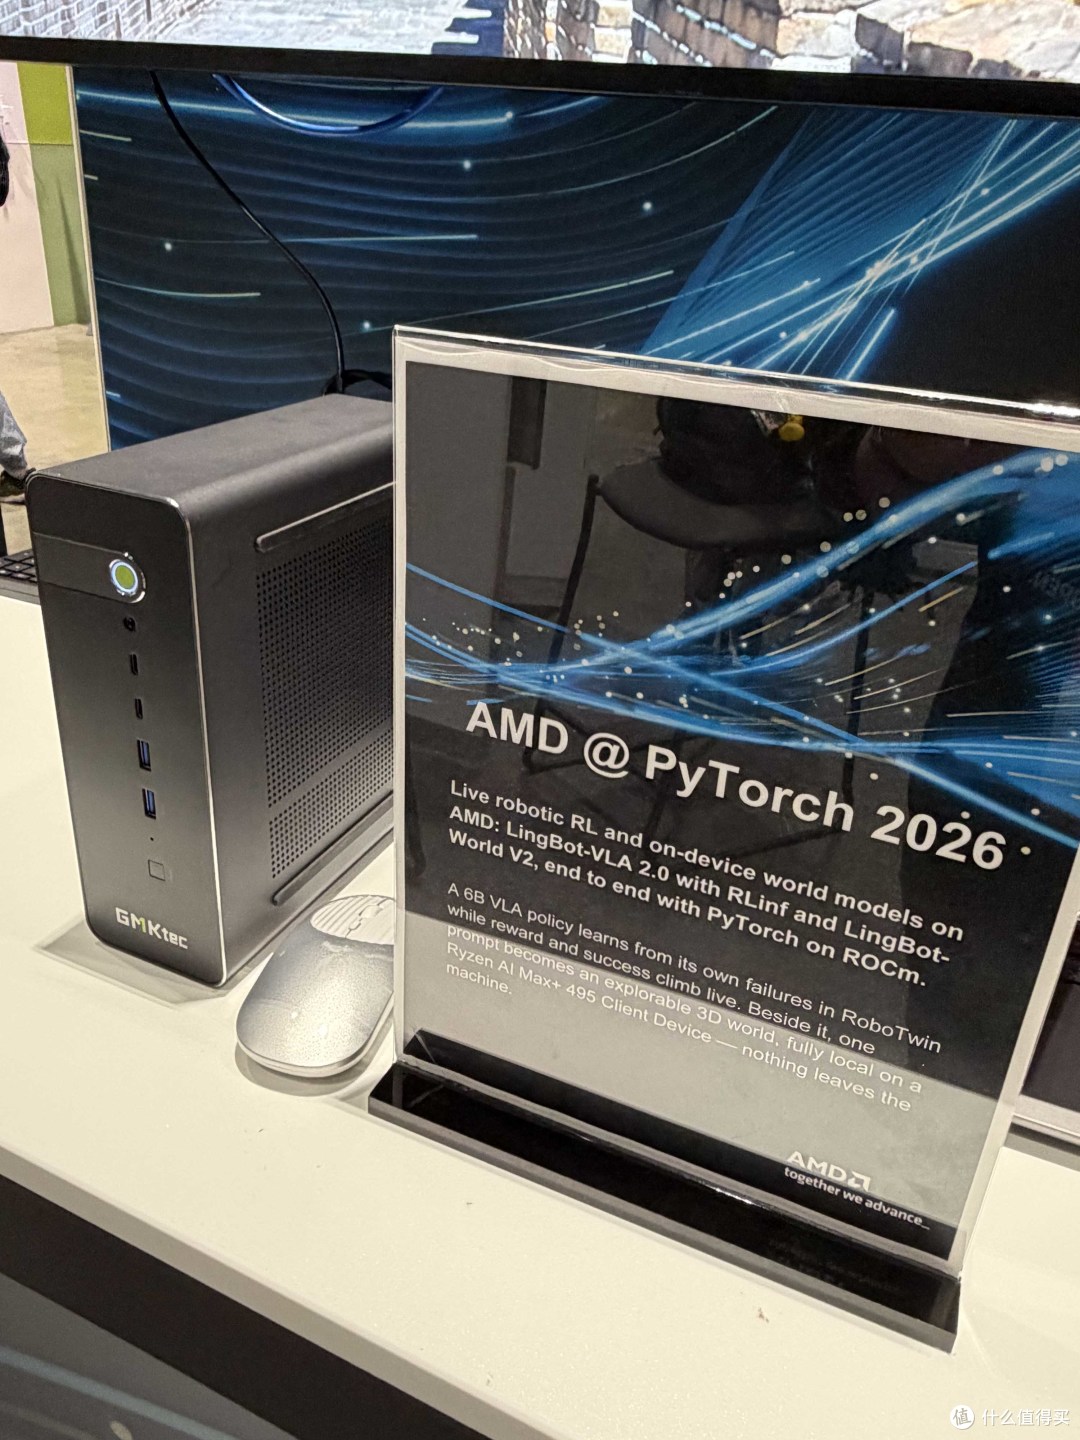
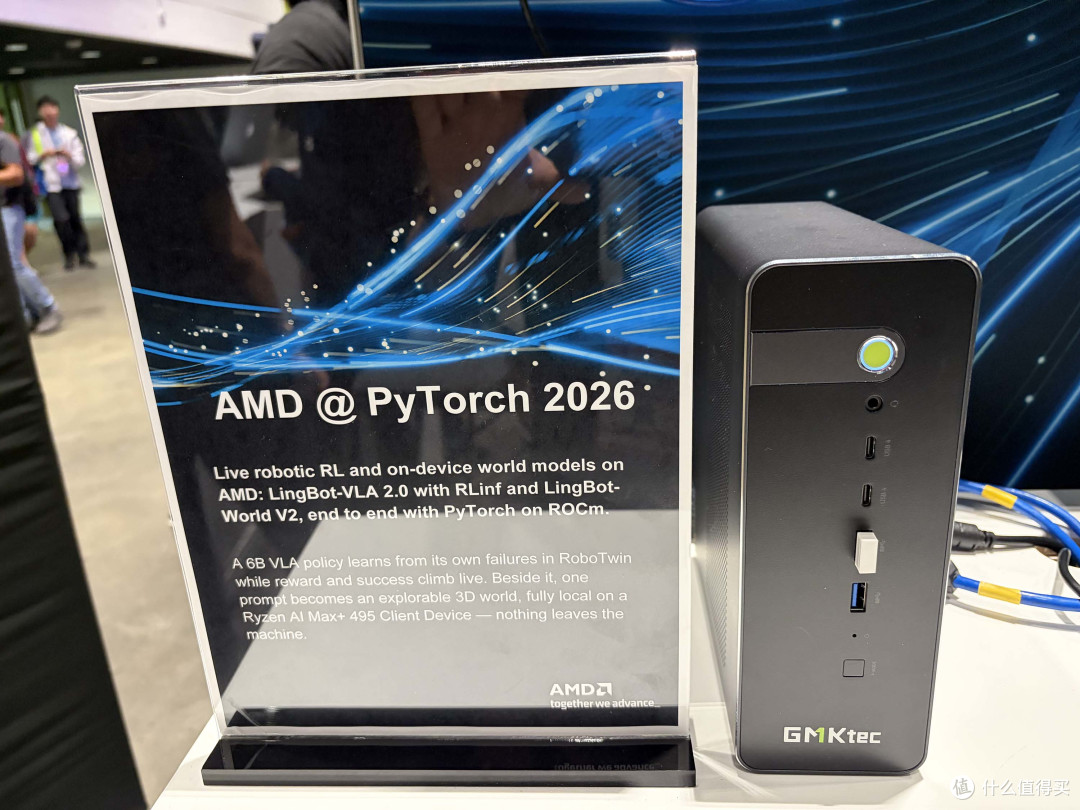
本届 PyTorch 大会汇聚了 PyTorch 核心维护者、大模型研究者与全球一线 AI 工程团队。极摩客展台核心展示区,一台 “EVO-X5 Pro“成为现场焦点 —— 该机搭载 “AMD 锐龙 AI Max+ PRO 495 处理器“,配备最高 “192GB 统一大内存“,在无云端依赖的情况下,现场演示了 ”320B 参数级大模型的本地推理”,流畅度与响应速度获得与会开发者的密集驻足与实测体验。
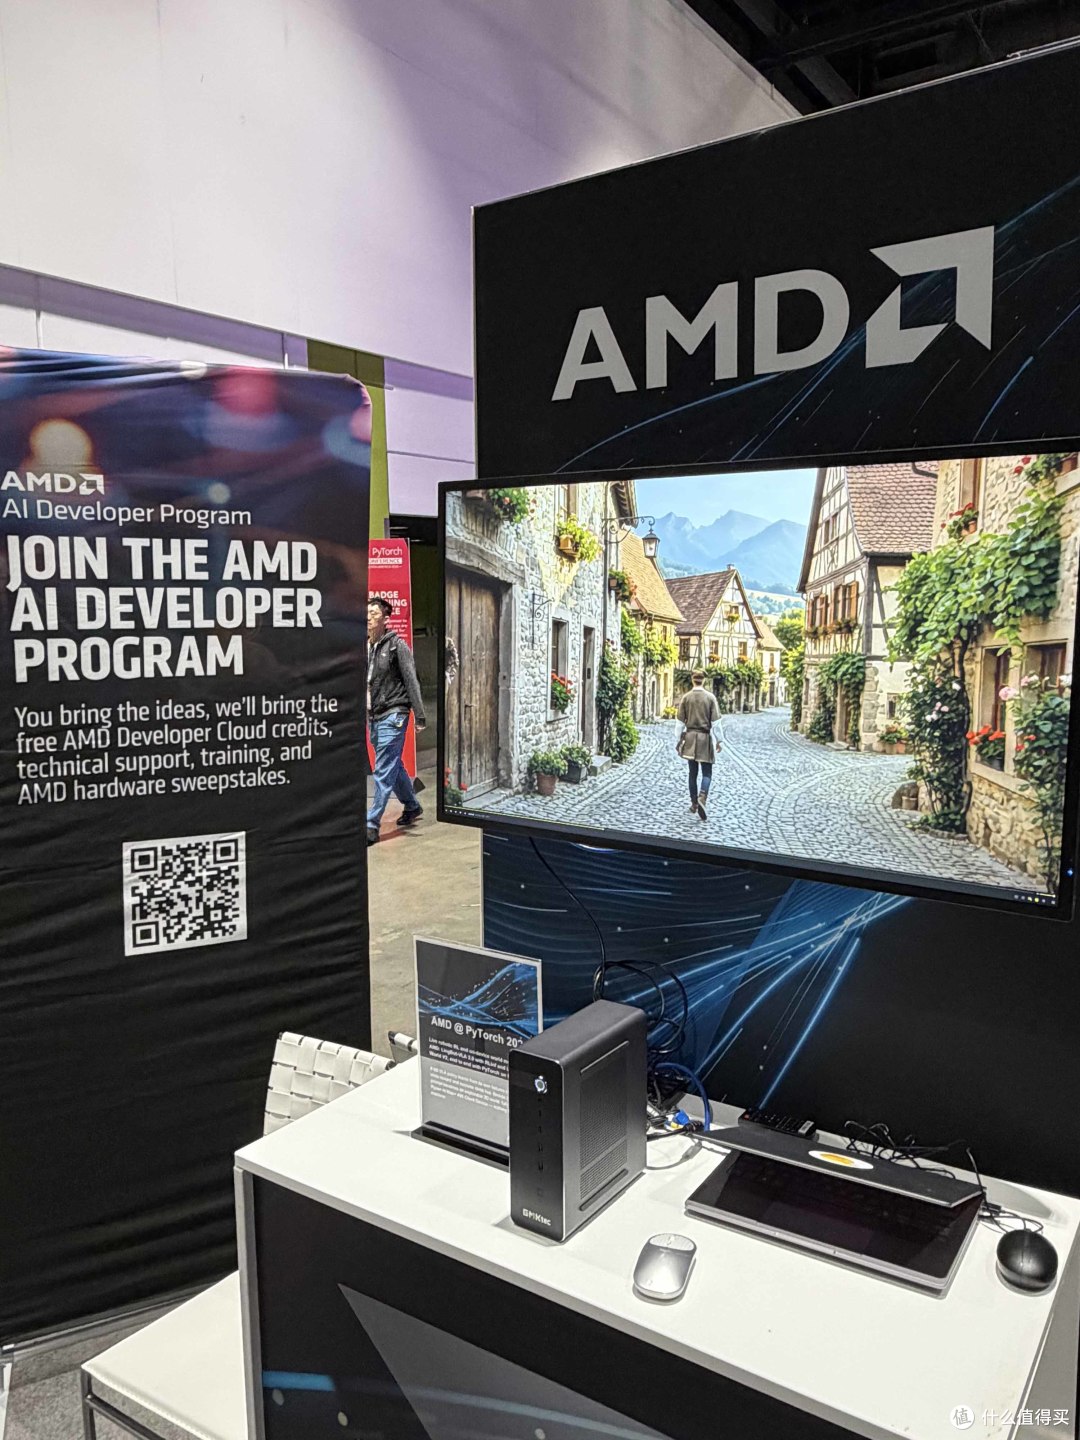
"我们一直认为,下一代 AI 开发不应被绑在机房里。" 极摩客负责人表示,"EVO-X5 Pro 的目标,是让研究者在工位上、在实验室里、在差旅途中,都能拥有一台足以承载前沿模型迭代的本地超算。"
性能解读:为什么 192GB 内存是端侧跑大模型的关键
端侧运行大模型的核心瓶颈,长期不在于峰值算力,而在于 “内存容量与带宽”—— 参数权重需要完整驻留显存 / 统一内存才能避免频繁换页。EVO-X5 Pro 凭借 AMD 锐龙 AI Max+ PRO 平台的高带宽统一内存架构,将 ”192GB” 容量带入桌面级迷你机身,使 320B 量级模型(INT4 / 量化部署)的本地加载、推理与微调成为可能。
这意味着开发者可以在单机上完成:
- 大模型本地推理:隐私数据不出设备,适合企业敏感场景与离线研发;
- 世界模型训练与迭代:高吞吐、低延迟的端侧算力,支撑具身智能、仿真世界模型的快速实验闭环;
- PyTorch 全流程开发:从数据预处理、模型训练到推理部署,一台机器覆盖研发链路。
从云端到端侧:极摩客押注 "本地 AI 算力" 新范式
随着大模型参数规模膨胀与隐私合规要求收紧,“端侧 AI(On-device AI)” 正成为继云计算之后的又一主战场。极摩客此前已推出 EVO 系列多款高性能迷你工作站,服务全球开发者、内容创作者与企业用户。本次在 PyTorch 大会这一全球开源 AI 核心阵地亮相,标志着极摩客正式将品牌叙事从 "迷你 PC" 升级为 "本地桌面 AI 超算平台"。
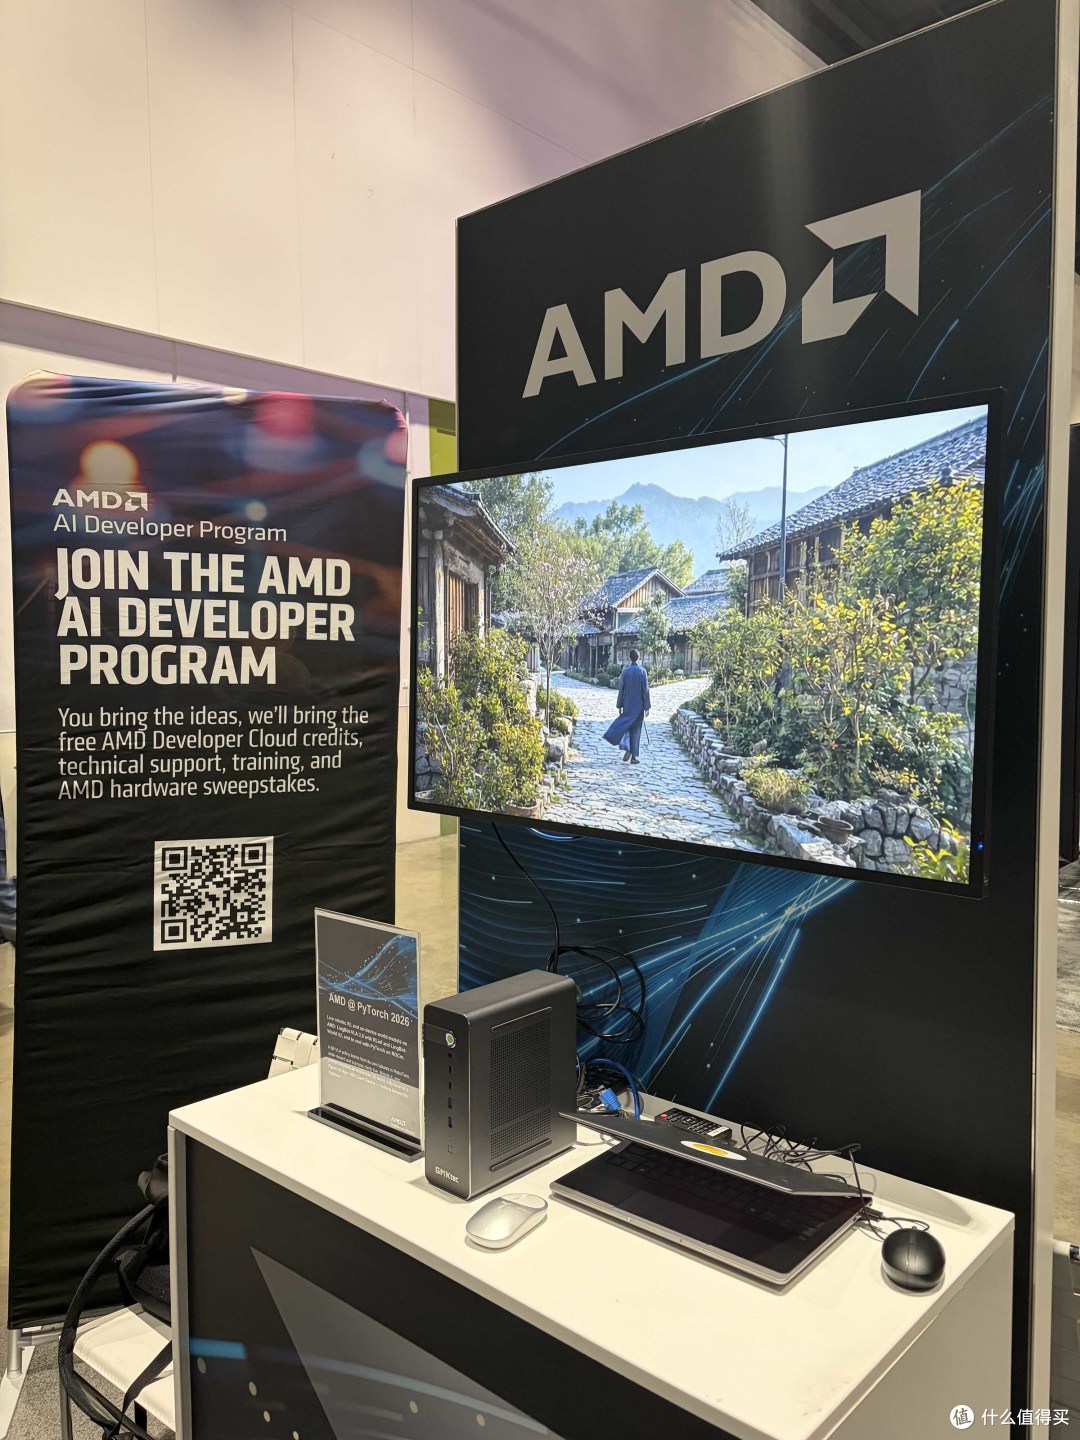
面向未来,极摩客表示将持续与 AMD 等上游芯片厂商深度协同,围绕主流推理框架做软硬件协同优化,让更高参数规模的模型,在越来越小的机身里跑起来、跑得快、跑得稳。











校验提示文案
校验提示文案
校验提示文案
校验提示文案