10月17日,DeepSeek发布新模型,全称DeepSeek-V4.1-Flash-1017。两天后,一个名为「史上最差AI模型名称排行榜」的盘点在社区刷屏,这串名字真的"登顶"了。但榜单的画风很快反转:一条三千多赞的回答直言,这种工科式命名是"最简洁明了直达问题核心没有歧义的",比很多看不出代际关系的名字清楚得多。真正值得关注的,是这个名字背后更新了什么:官方网页端、APP与API已同步切换为新模型,能力变强,跑任务和花钱反而变少,价格没动。知乎量子位
“最差的名字”,其实给的信息最多
这串名字拆开是四个信息:DeepSeek是厂牌,V4.1是版本号,Flash标明轻量档位,1017对应发布日期——"1017"正好对应10月17日,符合DeepSeek用日期标记模型快照的一贯方式。被嘲的原因很单纯:和Nano Banana这类自带传播度的名字比,它毫无营销感。但社区的共鸣在另一头——大家真正受不了的,是那些连新旧和档位都说不清的名字:选模型最烦的就是猜名字,有些名字一眼看不出新旧和档位,得翻文档对时间线。这类抱怨在社区里比比皆是,而把发布日期直接写进名字,恰好踩在痛点的反方向。量子位微博
名字底下,硬货不少
跑分上,1017版本在AI编程基准DeepSWE上从上一版的74.2涨到77.0,超过了Claude Opus 5的74.0;考察终端编程的Terminal-Bench 4.0从31.2涨到42.3,一口气涨了11分。这个77分也得到了另一家媒体评测数据的交叉印证:MiniMax同日亮相的M3.1 Flash在DeepSWE上拿到74分,仅次于这一版1017的77分。程序员鱼皮凤凰网科技
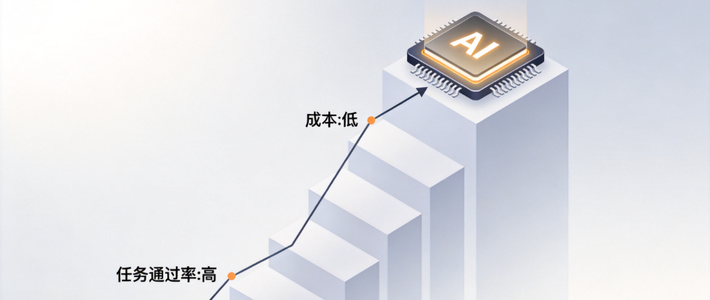
更少见的是方向:能力上涨的同时,任务运行时间、输出长度和token消耗被一起压了下来,官方的说法是"性能—费用的帕累托改进"。实测数据显示,在MAX推理档位下,DeepSWE每个任务的平均费用只要1块多,旧版V4.1 Flash在同一档位要3块多。量子位程序员鱼皮
官方还给这代模型准备了新展示:“许愿式编程”——一句话说清需求,模型自己规划、写码、运行、检查、修改,官方演示直接搭出了可交互的3D故宫。同期开放的自研Search/Fetch搜索接口按成功请求计费,每千次5元,搜不到或超时不收费。量子位
也要说清边界:在公开的11项基准总表里,这一版对Claude Opus 5是4胜7负,旗舰仍有明显领先的科目——所谓"帕累托改进",改进的是它自己的上一版,而不是全面追平顶级闭源模型。程序员鱼皮
真正会让人选错的,是这三类名字
第一类是"撞档"的名字:10月17日DeepSeek更新V4.1 Flash-1017,几乎前后脚,MiniMax也把M3.1 Flash推了出来,各家轻量档都挂着同一个后缀,同一个Flash远不等于同一个产品。第二类更隐蔽:名字没变,里面的模型换了。这次官宣之前,就有网友发现"deepseek-flash"接口返回的系统指纹已经变化,而指纹变化通常意味着后台模型版本或部署配置更新了。第三类,是"最差"这个词本身的歧义:今年7月谷歌发布Gemini 3.6 Flash时,早期实测中该模型在前端生成与空间推理上表现不佳,被用户戏称为「史上最差」——那次说的是能力,跟名字无关。所以看到"最差榜",先分清嘲的是包装还是内容:这一次,是包装。凤凰网科技量子位新智元
别破译名字的含义,去核对三个信号
第一,优先挑"说人话"的版本号:带代际和日期的名字,能直接查到是哪一次快照;只剩形容词的名字,要多花时间去翻文档。第二,比跑分先对场景:DeepSWE考的是Agent编程,Terminal-Bench考终端操作,同一个名字在不同榜单上可以差出几名,对不上使用场景的分数没有意义。第三,把账算在自己的任务上:这次价格与上一版持平、权重照常开源,"费用少一半"要在自己的真实任务里跑过,才是你的数字。程序员鱼皮
名字是标签,不是产品。DeepSeek这串"最难念"的名字登顶最差榜是个玩笑;不被名字吓退、也不被名字忽悠,才是普通人选AI工具的真本事。