
国庆前后,AI Infra 圈最值得看的事件不是发了什么模型,而是 GitHub 上安静挂出来的六个仓库。
2026 年 9 月 30 日,DeepSeek 官宣开源面向华为昇腾算力平台的基础设施组件:TileLang 昇腾后端、DeepGEMM-Ascend、DeepEP-Ascend、TileKernels、FlashMLA、DeepSelect。官方的表述相当硬——每个组件都与此前面向英伟达平台开源的库"一一对应"。知乎界面新闻36氪
社区反应立刻撕裂。知乎相关问题几天内浏览超 400 万、赞 191 的长评在争"历史性机遇";B 站快讯视频 2000 多赞、450 多条评论在吵"CUDA 是不是完蛋了";也有媒体把这轮叙事和手机芯片麒麟 9050 缝在一起,做成了"反攻辉达护城河"的头条。哔哩哔哩
热闹归热闹,作为真要动键盘的人,你需要的是把三层信息拆开:这六个件各自对位什么、CUDA 的墙到底被动了哪一块、以及你自己今年要不要上手。这篇替你按仓库和公开口径把这三件事捋一遍。
一、六件套对照表:对位发生在"写 kernel"这一层,不是"调库"那一层
先把六个仓库是干什么的摊开:
昇腾新仓库 | 对位的 NVIDIA 版组件 | 管的层 | 一句话定位 |
|---|---|---|---|
TileLang(昇腾后端) | TileLang CUDA 后端 | 语言/编译 | Python 嵌入式 DSL,同一份 tile 级源码 lower 成 CUDA C++ 或 Ascend C |
DeepGEMM-Ascend | DeepGEMM | 计算 | 大模型最底层的 GEMM 矩阵乘 kernel 库,新建独立仓库、接口兼容 |
DeepEP-Ascend | DeepEP | 通信 | MoE 训练里几百卡互递数据的通信库,对标 NCCL 生态位 |
TileKernels | TileKernels | 算子 | 常用算子集合 |
FlashMLA | FlashMLA | 注意力 | MLA 稀疏注意力,长文本推理的关键件 |
DeepSelect | DeepSelect | 数据 | 数据筛选/采样算子 |
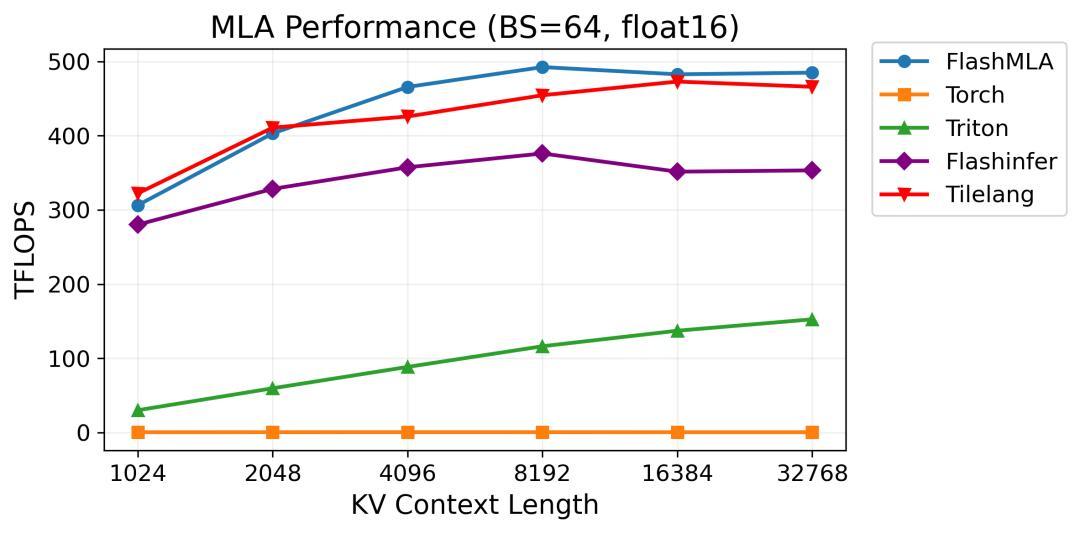
注意这个"一一对应"发生在哪一层:kernel 源码层。过去几年"某某模型适配了昇腾"的新闻不少,但"适配"是让模型跑起来,这次是把训练 DeepSeek 自己验证过的算子实现连源码一起放出来——后来者可以站在它肩膀上改,而不是从零重趟雷。TileLang 本身是北大、帝国理工、微软研究院联合开源的项目,论文拿了 ICLR 2026 Oral;按论文口径,FlashAttention 的 TileLang 实现约 80 行 Python,性能达到手写 CUDA 的 95% 以上。DeepSeek 官方声明,训练中使用的全部 TileLang 算子已在昇腾 950 上达到高性能实现,计算与通信性能"接近硬件上限"——这句是厂商自述口径,后文会泼冷水。知乎知乎
二、把"CUDA 护城河"拆成三层,这次只动了最难啃的一层,墙最厚的那层还很厚
很多争论源于把"生态"当一块铁板。拆开看:
应用/框架层:torch.matmul、.cuda()、cuBLAS/cuDNN 的二进制调用。这层今年一直在塌:TorchNPU 成了首个登上 PyTorch 官网的中国芯片后端,Triton Ascend 被 Triton 官方社区接纳,本月同周还出现了 TorchTPU、TorchNeuron 这类"改一行换芯片"的开源。这一层迁移成本确实被砍掉了大半。
Kernel 层:手写调优的算子、通信库。这是此前真正"在墙上"的一块,六件套动的就是这块砖。
生态习惯层:教程、问答帖、Stack Overflow 高赞、招聘 JD、"新算法第一版永远 CUDA 优先"的循环。这层几乎没被动。
量级对比要直接摆:按英伟达 FY2025 财报口径,全球已有超 590 万开发者在用 CUDA 及其工具链。 DeepSeek 工程师徐瑞帆的原话比双方营销号冷静得多——CUDA 生态并不是护城河,会写 CUDA 的人转 Ascend C 也不难,用的人多了,软硬件一起迭代,后来者才有机会追赶。 前半句是士气,后半句才是工作量。知乎新浪微博
CANN 侧 2025 年底完成开源、昇腾 950 系列"上市即开源",9 月中旬公开数据是社区月活开发者 6230 名、代码仓下载超 6000 万次,CANN 算子库约 1500+。 中间隔着三个数量级的用户惯性和一整层长尾算子。知乎

三、真正难的不是接口,是并行心智模型:昇腾不是一颗"慢一点的 GPU"
为什么开发者普遍觉得国产卡"难用"?不是 API 难背,是硬件把 GPU 替你自动做的事,交给了软件显式做。 按社区对 tilelang 仓库 Ascend 950 后端源码的梳理(src/ascend/、tilelang/ascend/):知乎
GPU 是同构 SIMT:一堆 warp 靠人海隐藏延迟,L1/L2 隐式缓存,shared memory 统一一块,数据布局全程 ND 行主序。
昇腾是 Cube+Vector 异构双核加指令 PIPE 异步队列:UB 248KB、L1 512KB、L0A/L0B 各 64KB、L0C 256KB 多级存储,Cube 链路私有;手排流水要同时决定"用哪个引擎搬、ND 转成 16×16 分形(NZ)什么布局、由哪种核访问",软件流水是必修基础设施,不是热点可选优化。
裸写 Ascend C 比 CUDA 难,难的性质就在这。而 TileLang 的价值也恰好打在这:后端把一多半代码砸在自动调度上(光 insert_sync.cc 就 2572 行、estimate_latency.cc 2275 行),用 T.copy、T.gemm 描述"数据放哪层、从哪搬到哪",引擎选择、布局转换、流水编排交给编译器。社区梳理的原话口径是:人来排(裸 Ascend C)比 GPU 难,编译器来排(TileLang)就和 GPU 差不多。 这才是六件套值得押注的原因——它押的不是"多了一套库",而是"算子从厂商私产变成可移植资产"这个路线。知乎

四、冷水部分:三件事没被一次开源补上
"接近硬件上限"暂无第三方复现。 目前所有性能数字都来自 DeepSeek 自己的口径,没有公开同口径(同模型、同精度、同 workload)的 H100/GB300 对照复现。做集群采购决策前,这一条必须等。
训练侧的验证还没发生。 训练是最难啃的骨头,英伟达在训练侧的份额长期超过九成,前沿库几乎全是 CUDA 优先。 国产生态真正站稳的标志,不是推理跑通,而是下一次前沿大模型预训练由谁的芯片扛下来。DeepSeek 与智谱均已声明将在下半年大规模使用昇腾 950 超节点。 硬件侧,昇腾 950DT 千卡超节点已落地中国移动北京节点,单节点 1024 卡算力达 1EFLOPS(FP8)、支持 256TB 统一内存编址。 这会是最近的一次真刀真枪验证。知乎知乎界面新闻
供货与周期。 社区 9 月初即有讨论称 950DT 刚陆续发货、供货紧张,DeepSeek 当时都还没拿到超节点;个人和小团队现在排队大概率排在采购单后面。知乎
五、噪声过滤:这轮传播里,哪些不是同一件事
麒麟 9050/9050Pro:是手机 SoC 的逻辑折叠工艺,和数据中心的昇腾 950 超节点不是一条产品线,被多家视频缝进"反攻 CUDA"叙事属于张冠李戴。哔哩哔哩
“超节点算力反超 60%、代价 5 倍功耗”:B 站这类标题视频评论区 115 条吵成一片,但口径基本都是纸面聚合数字混比(集群对单卡、FP4 对 FP8),没有标准化 benchmark 支撑,别当结论用。哔哩哔哩
DeepInfer 的硬件支持范围:10 月 20 日开源的推理引擎,社区对"支持英伟达+昇腾"还是"仅支持昇腾 950"口径不一致,README 为准,别信二手转述。36氪
“CUDA 护城河是假命题”:更早的微博技术讨论其实说得很具体:ROCm/HIP 接口和 CUDA 几乎一样、人工移植也不算难,只是慢一点,而 CUDA 的真正护城河不在上层 API,而在 PTX 中间表示、工具链和十几年沉淀的库。 被简化成"CUDA 完蛋了"属于断章。新浪微博
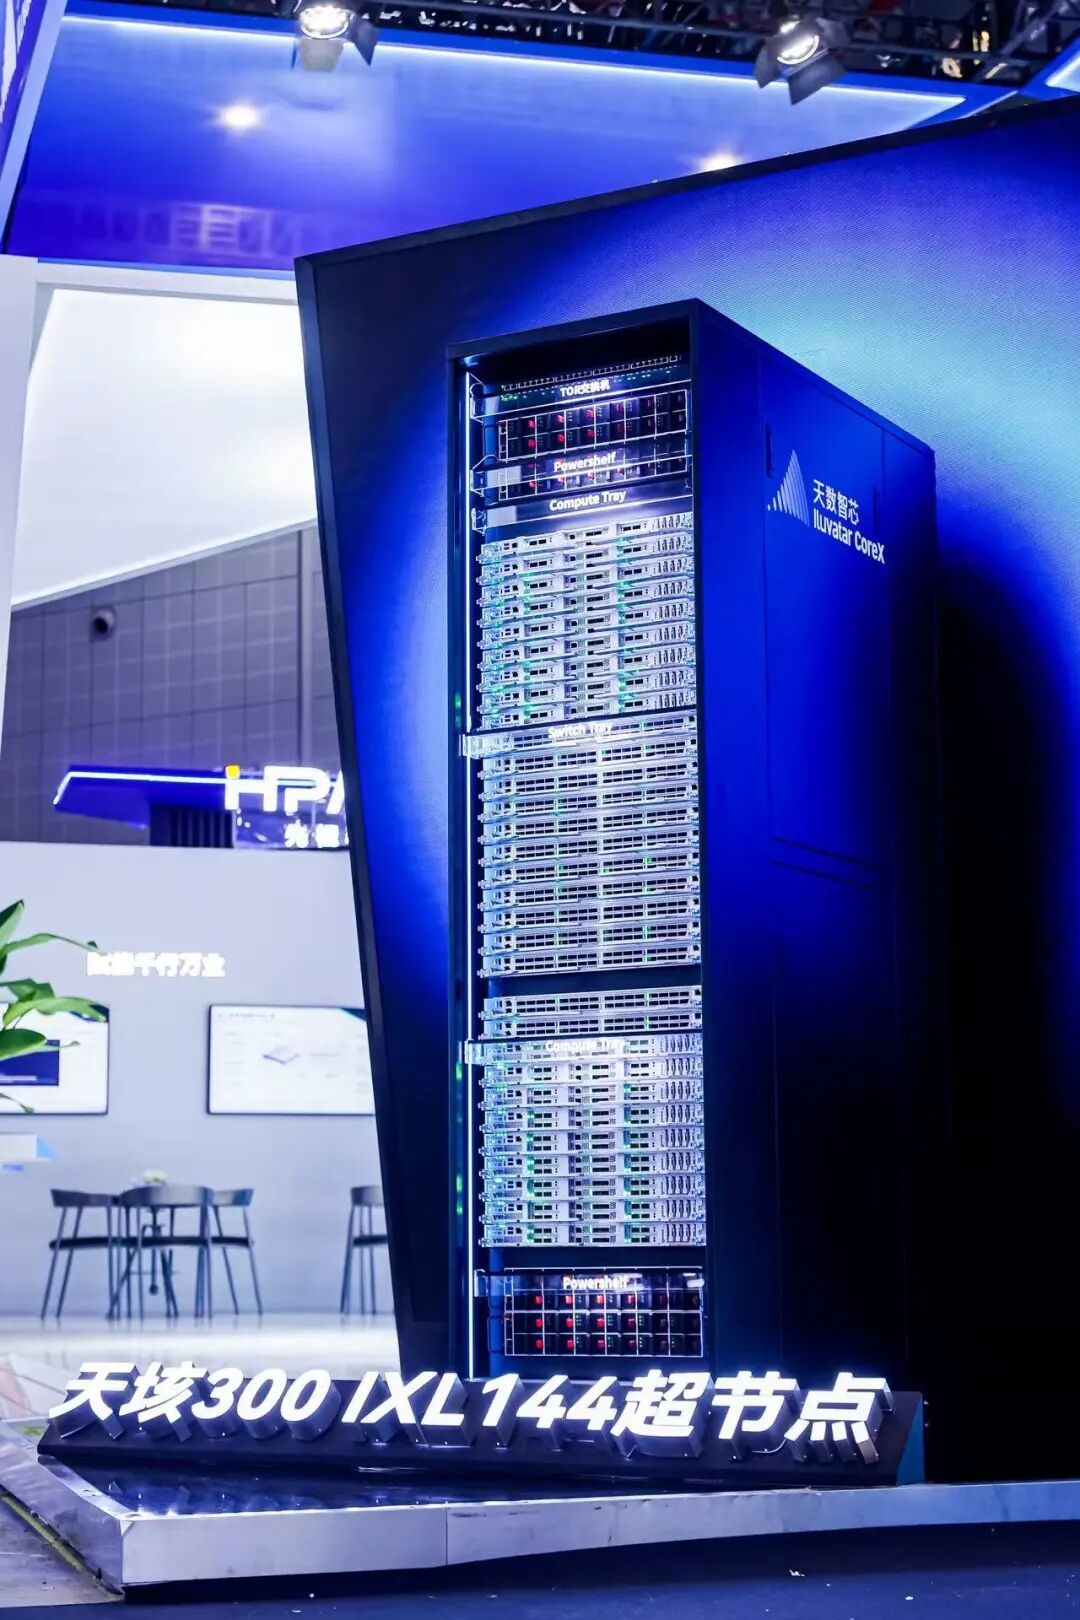
超节点这条线同样需要把口径分清。今年 10 月 12 日开幕的工博会上,国产 GPU 厂商不约而同把展台主角换成了整机柜:沐曦摆出单柜 64 卡全互联的曦景 S600,燧原展出云燧 ESL64-O,天数智芯把 144 颗 GPU 集成进一台机柜。方向是真热,但"单柜多少卡"和"跑你的模型时卡间利用率多少"是两回事,纸面聚合数字替不了同口径压测。36氪
六、分人群决策卡:今年该不该上手
手写 CUDA kernel / 算子优化方向:现在就上手,成本最低收益最高。不用买昇腾卡——TileLang 在你自己的 N 卡上就能编译 CUDA 后端,拿你最熟的 1~2 个 kernel 用 TileLang 重写,验证"80 行 FlashAttention 达到手写 CUDA 95%+"在你场景下是否成立。成立,你的 kernel 就从"绑死一家"变成可移植资产。
推理部署工程师:小流量试。挑生态适配列表(90+ 项目)里你栈上现成的框架,用云上昇腾实例跑一遍自家模型的离线推理,重点盯首 token 延迟和吞吐衰减曲线,别在没第三方复现前承诺线上切换。
准备买/租国产算力的团队:两个"一一对应"和"接近硬件上限"都别全信。等两样东西:第三方同口径复现数据,以及 DeepSeek/智谱下半年超节点大规模使用的实际结果。
CUDA/HPC 学习者:主线继续 CUDA,副线加一门 tile 级 DSL(TileLang 或 Triton)。面试和实际工作里吃香的是"跨后端心智模型",不是背第二套 API。
七、下一步盯什么
六件套是否出现同模型同精度的第三方基准复现;
下一次前沿模型预训练是否真正跑在 128/1024 卡超节点上;
CANN 月活(当前 6230)和华为之外贡献占比的增长曲线;
TileLang 新增后端的接入文档与社区第三方后端出现速度;
昇腾 950 租赁市场的供给与价格是否企稳。
护城河的真正定义不是"写了多少代码",而是"还有多少人默认在它上面写代码"。这次六件套的意义,是国产阵营第一次把 kernel 层的"默认选项"从空白写成了对位物——但写出来不等于长出来。生态只能一行一行长,墙真拆没拆,不看今天的掌声和檄文,看明年此时新算法的第一版发布在谁上面。















