国庆假期这几天,你大概率在小红书刷到过那条《Prompt玄学》。
帖子9月28日发出,现在点赞2.5万、收藏近2万。楼主的困惑很实在:他试了一条"万能提示词",发现AI真的变聪明了——但他分不清这是科学,还是又一轮玄学传播,于是把问题原样丢进了评论区。结果234条评论打成三派:小红书
玄学派:有人一句"你明白我的疑惑吗?“从2022年用到现在,自称百试不爽(1370赞);有人在需求末尾加"理解后复述我的需求”,说能稳定纠偏(1111赞)。
本质派:最高赞评论一句话点破(2941赞):“意思是AI的检索和分类能力大于推理能力”——咒语不神,只是恰好把活派给了模型的强项。
不屑派:嘲讽说25年的Prompt有点过时了,现在AI能理解需求,如果它理解不了,那记得付费。小红书
你站哪派?先别急着站。我把这一年多来刷屏的语气实验、官方说法和民间实测都翻了出来,逐条核验这些"咒语"。结论放前面:语气类的确实是玄学,连研究都在互相打架;但少数"结构类咒语"有实打实的依据,值得背下来。
一、骂它还是夸它?研究者自己先打起来了
"语气影响AI发挥"这件事,这两年至少有三轮证据刷屏,方向完全不同。
第一轮,宾夕法尼亚州立大学团队把同50道选择题改写成从极礼貌到粗鲁的5种语气喂给ChatGPT:礼貌提问准确率80.8%,粗鲁提问84.8%,语气越直接,分越高。这研究去年10月冲上热搜 #研究发现对AI越凶正确率越高#,今年9月26日又以 #我对豆包说过最难听的话# 的话题翻红了一波。微博
第二轮,同年稍早,一支有沃顿商学院教授参与的跨国团队测了11个主流模型,结论几乎相反:奉承式提示(先夸模型)普遍提升表现,辱骂式全面拉低。
第三轮最有意思:Altman亲自下场算账——去年4月他透露,用户对ChatGPT说"请"“谢谢”,让OpenAI每年多承担数千万美元算力成本。他的态度是:值得,你们继续说。微博

三轮证据,三个方向,看似罗生门,其实掰开实验设计能看懂:宾州测的是"直接命令 vs 礼貌绕弯",本质是信息密度——废话少了,指令清楚了,分自然高;沃顿测的是"夸奖 vs 辱骂",本质是情绪效价——极端负面语言会拖累输出。两拨研究合起来恰恰说明:语气层操作的收益是个位数百分点级别、方向不稳定、还随模型换代缩水。至于"给AI 200美元小费""威胁举报它"那批GPT-4时代的都市传说,在新模型上基本只剩自我安慰。
所以第一条判断:别在语气上花功夫。礼貌点多花点电费,粗鲁点可能多拿几分,都不值得专门研究。
二、那些"真有用"的咒语,赢在把活派对地方
回到原帖。楼主实测有效的那条咒语,大意是:
“我遇到的这个问题,是哪个经典问题的变体?有什么成熟解法?”
它没有让AI直接答题,而是先让AI做"模式识别"——把你乱七八糟的问题归类到一个经典问题里,再去找解法。为什么灵?本质派那条2941赞的评论已经说破了:当下大模型的分类、检索能力强,现场推理能力弱。这句咒语把任务从模型的弱区(开放式推理)挪进了强区(归类+检索)。
同理,“你明白我的疑惑吗”"理解后复述我的需求"这两条高赞咒语也不是魔法——它们是在流程里强行插了一步对齐检查,让误解提前暴露,而不是等你看到错误答案才发现。小红书
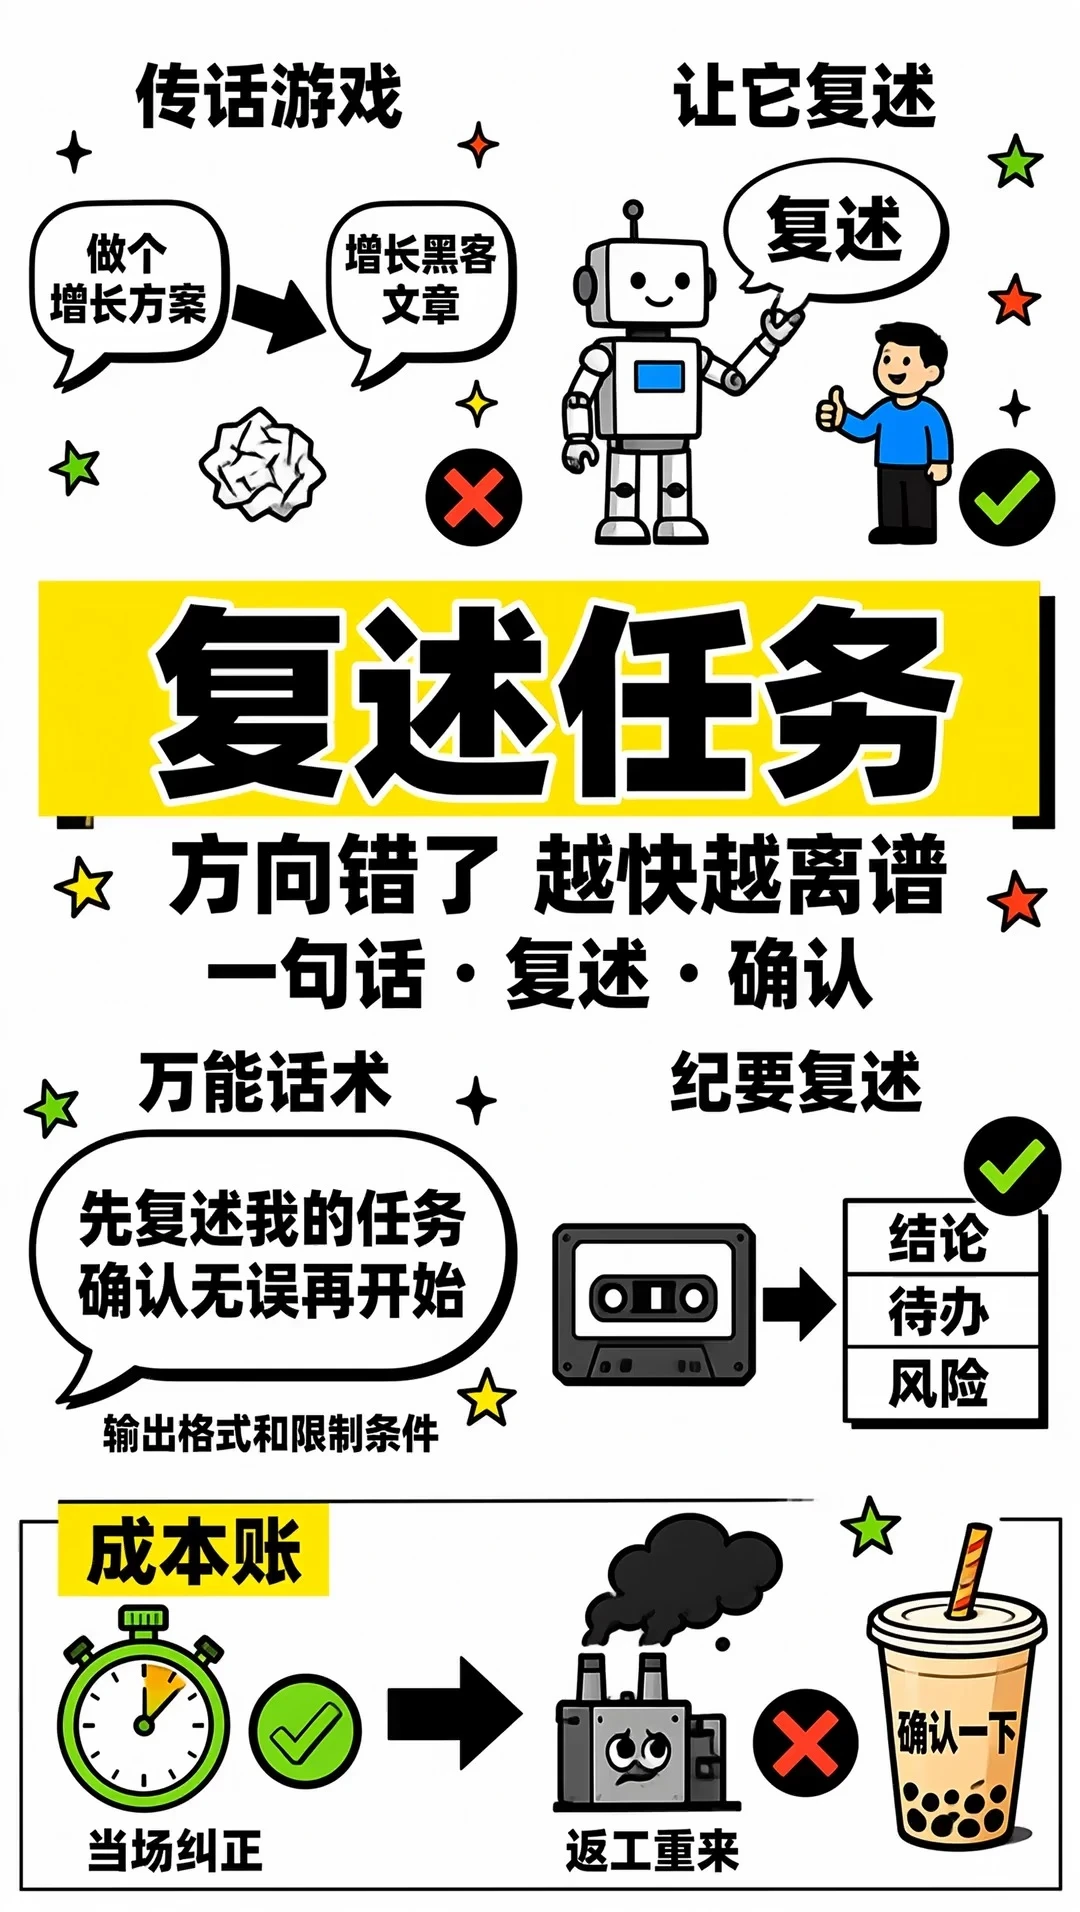
OpenAI官方的提示词指南翻来覆去讲的也是同一件事:任务描述越具体,输出越稳定。但注意后半句——“具体"不等于"长”,一句定位准确的话,比十句格式要求管用。小红书
收拢一下,可靠杠杆就三根:归类定位、给例子、插验证步骤。你以后刷到的任何"显灵咒语",拆开看几乎全是这三样东西的变体。
三、不想背模板?有人替你做了实测:两句口令
9月30日,一位知乎用户做了个挺硬核的实验,专治"不想背几十套模板"的人。他拿一道太空光伏电站论证题(要求同时处理航天、能源、经济、法规问题,很难靠漂亮话混过去),实测了六种用法,请独立评审打分:
直接把需求丢给AI:4.10分
只加一句口令——“按需求生成执行提示词,别执行”,拿到提示词后开新对话执行:5.60分
让AI生成"全阶段提示词包"、分阶段执行:得分最高
再叠一层——“以最挑剔的反驳者攻击这个提示词,找出歧义、遗漏、不可验证假设,只输出修改版,别执行”:6.25分,但代价是多用0.55个单位的Token、37次调用和约半小时。
翻译成人话:让AI先写"作业说明",再挑说明的毛病,最后才开工,比直接要作业可靠得多。作者自己把边界划得很清楚:单题单次、不是统计实验——复杂、出错代价高的任务值得这么搞,日常小问题别折腾。知乎
顺带一个反面教材:他还试了"先问关键问题;我不懂的部分请自行假设",结果翻车。因为"请自行假设"给了模型逃逸通道——真正影响结论的关键问题,被它一句"假设"就跳过去了。让AI反问你是好的,但同时给它假设权,等于白问。知乎
四、做图做视频,逻辑要反过来:“改”,不是"写"
上面说的都是文字任务。如果你国庆这几天的计划是做AI图、AI视频,提示词的答案完全不同。
10月4日知乎有人拆解了社区里刷屏的案例:博主探路AI(@TanLuAI)一条"女侠御剑飞行"AI短片,18小时点赞4万+,搬运到海外又跑了60万+播放。他的流程核心就一句话:拿别人验证过的提示词,换上自己的角色和剧情。四步:知乎
角色图:去AI绘画广场灵感区找现成提示词,喂给Seedream、GPT Image或Midjourney,出一张上半身近景就够,不用三视图。
提示词:搜罗大神开源的提示词,或对着爆款成片反推拆解,让GPT/Gemini/豆包照着你的剧情改一版。
选模型:按场景配、不迷信最贵——Seedance 2.0/2.5、Minimax H3(可本地部署)都支持"只喂一张角色参考图"的全能参考模式。
后期只做三件事:变速裁剪掉穿帮、调色统一风格,不为小瑕疵重新生成。
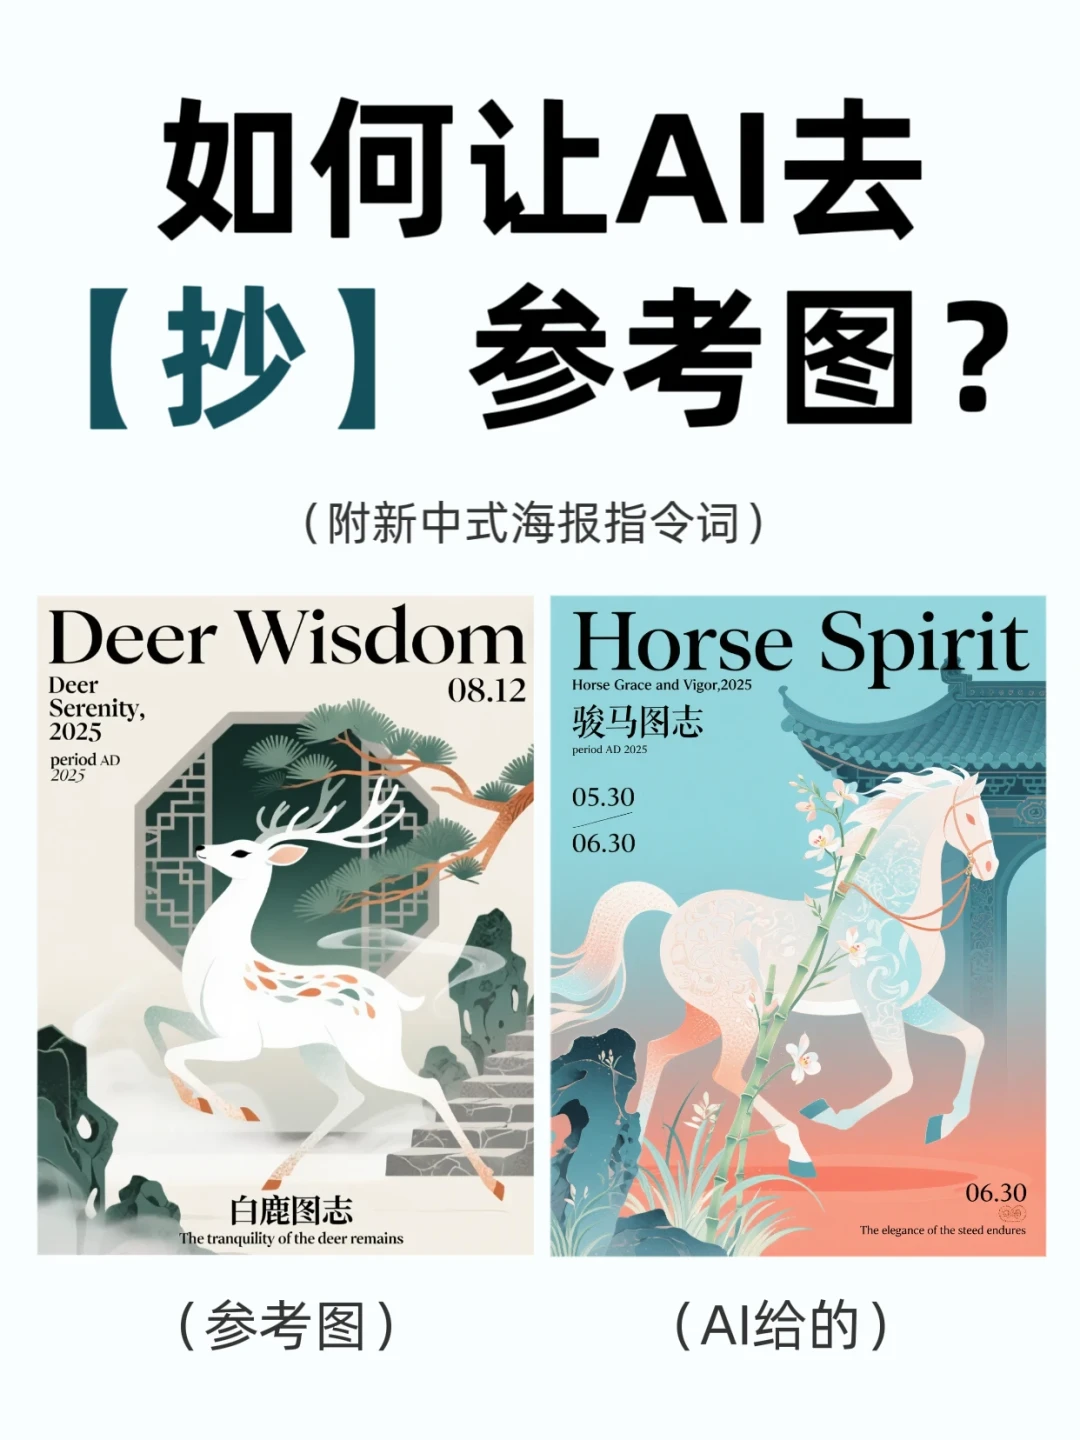
成本账也替你想好了:用有免费额度的模型(Minimax H3、Seedance 2.0 Fast),一天3-5条零成本;豆包每天约1条。另有一个真实用户刚踩过的坑:国产模型的提示词请用中文写——有人给即梦喂纯英文提示词,底层中文语料会先"本地化翻译"一遍,词不达意,越改越歪。知乎微博
五、分级表:什么值得背,什么纯浪费钱
把上面全部核验结果收成一张表。以后再刷到"万能咒语",直接对号入座:
A档 · 可靠收益,值得形成肌肉记忆
具体的任务描述+一个例子(官方推荐,跨代有效)
归类定位:“这是哪个经典问题的变体?有什么成熟解法?”
对齐检查:“理解后复述我的需求”
生图/生视频:找验证过的提示词"改",不从零"写"
复杂任务:先让AI生成执行提示词,再让它挑剔这份提示词
B档 · 条件有效,看场合用
角色设定(“你是20年资深××”):能调语气文风,但不少实测显示它并不稳定提升准确率
“一步步思考”:老模型上有用,新一代推理模型收益有限
C档 · 玄学区,别专门研究
礼貌/粗鲁/奉承:研究互相打架,收益个位数且随换代缩水
小费承诺、威胁话术:GPT-4时代轶事,现在基本无效
D档 · 智商税区,捂紧钱包
付费"万能咒语"课程和模板包。两个理由:模板贬值极快——不屑派那句"过时了"没说完的是,模型每换代一次,B档以下的咒语就集体作废一轮;职业端也不认——招聘平台上AI营销相关岗位的JD,几乎没有把"会写提示词"单列为核心技能,真正标价的是你对问题的判断和对结果的验收。知乎
假期还剩三天,能带走的三个动作
清理收藏夹里吃灰的模板包,只留A档那三根杠杆:归类、例子、验证。
下次问AI复杂问题,先试两句口令:“按需求生成执行提示词,别执行”→“以最挑剔的反驳者攻击这个提示词,只输出修改版”。知乎
想做一条AI视频的话,别写提示词——先去找一条爆款,改它。
值得持续盯的信号只有一个:模型每次大版本更新,回头重测你手里的旧咒语——"一步步思考"的贬值已经演示过,这张分级表本身也会被改写。而免费的东西永远比付费课可靠:各家官方提示词指南全部公开,更新比任何课程都快。
你最常用的一句咒语是什么?有没有骂AI骂出好结果的经历?评论区聊聊,点赞高的我补进分级表。