最近大模型圈最抓眼球的,是一套"垃圾佬"配置:老旧至强服务器CPU + GTX 1060 6G显卡 + 16G内存 + 256G固态,整机约500元,就这套配置本地跑千亿参数级的开源模型,生成速度能到 19-21 tokens/s。功臣不是新显卡,而是这两周爆火开源的推理引擎 Strata。知乎
老卡凭什么"逆天改命"
Strata 的思路一句话讲完:别把模型塞进显存,把显卡、CPU、内存、SSD 全用上。MoE 大模型每次只激活一小撮专家,它就按这个特性做分层缓存调度,12G 显存起步的游戏电脑也能跑总参数 125B 的开源模型,装完本机就提供 OpenAI 兼容接口,Claude Code、Codex 这类编程智能体可以直接接。知乎
GitHub 上这个开源项目已经攒下数万 star。发版节奏也快得离谱:内置推理引擎已经迭代到 0.1.47,官方最新发行 v0.2.2 刚在 10 月 22 日放出。知乎知乎
这波其实是整个开源大潮的缩影:10 月 17 日 DeepSeek 放出的 V4.1-Flash 新版的权重已经公开,HuggingFace 上连量化版本都有人做了。但它仍然是个 500GB 级的大家伙,个人电脑本地部署基本扛不动,普通人想尝鲜,直接用官方 API 是更现实的路线。知乎知乎
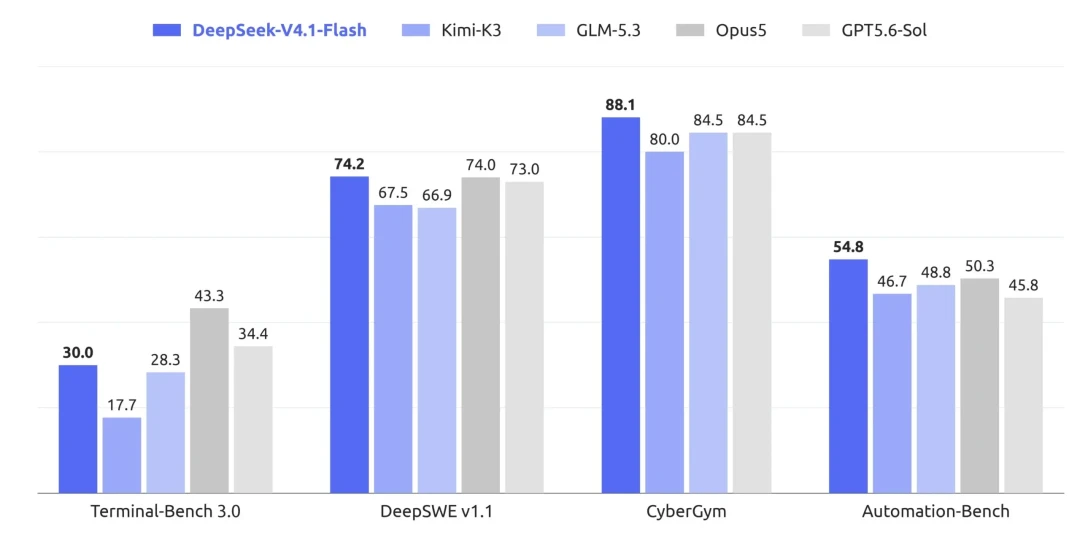
而到了 20 日,DeepSeek 干脆把自家生产在用的推理框架 DeepInfer 也全面开源,兼容英伟达和华为昇腾,把"推理"这个词彻底推上了热搜。36氪知乎
门槛没吹的那么低:显存只是门票
评论区被问得最多的就一件事:到底要什么硬件?真实答案是——
12G 显存只是入场券,内存建议 32G 起步,跑大一点的量化档甚至要 64G。
模型权重体积摆在那,IQ1_M 量化档全套下载约 231GB,硬盘装不是一切白搭。小红书
SSD 带宽才是隐形瓶颈,社区流传的经验是"想上车的先按一半速度估"。哔哩哔哩
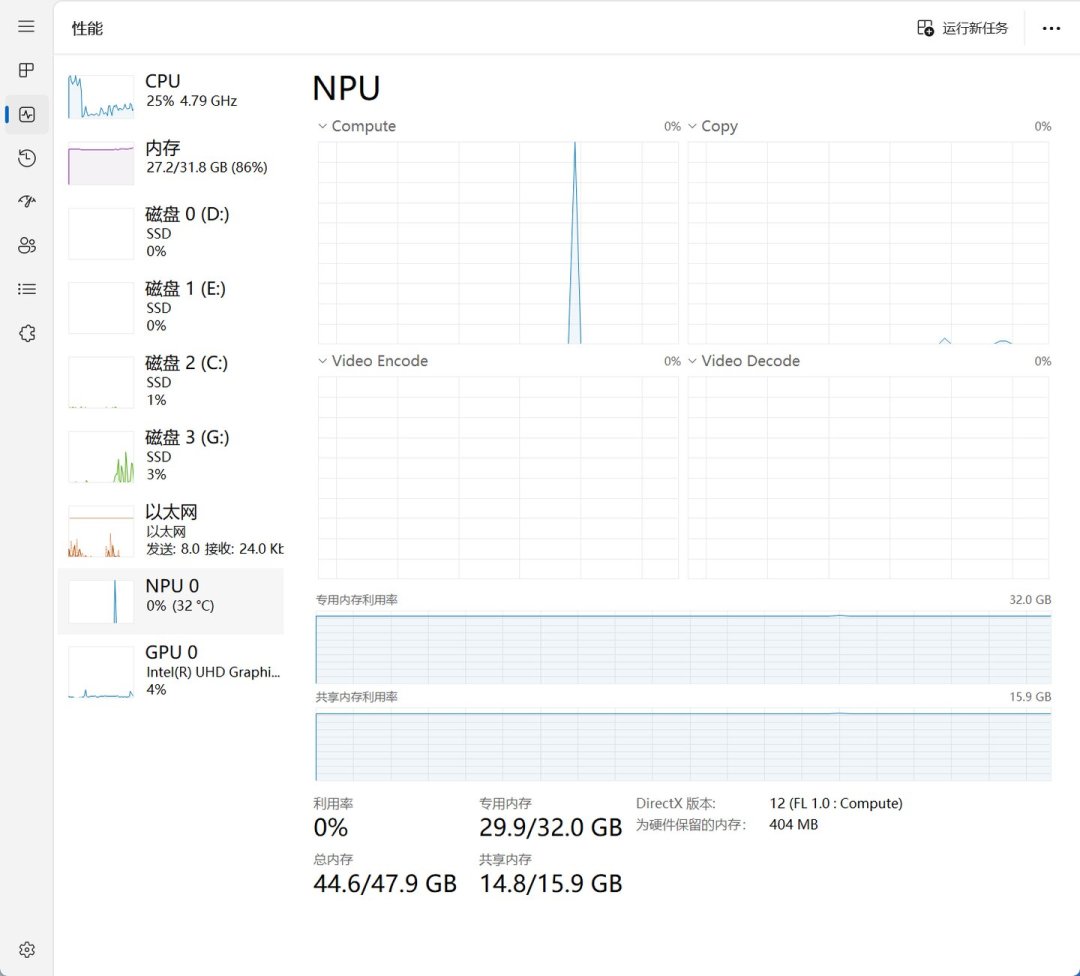
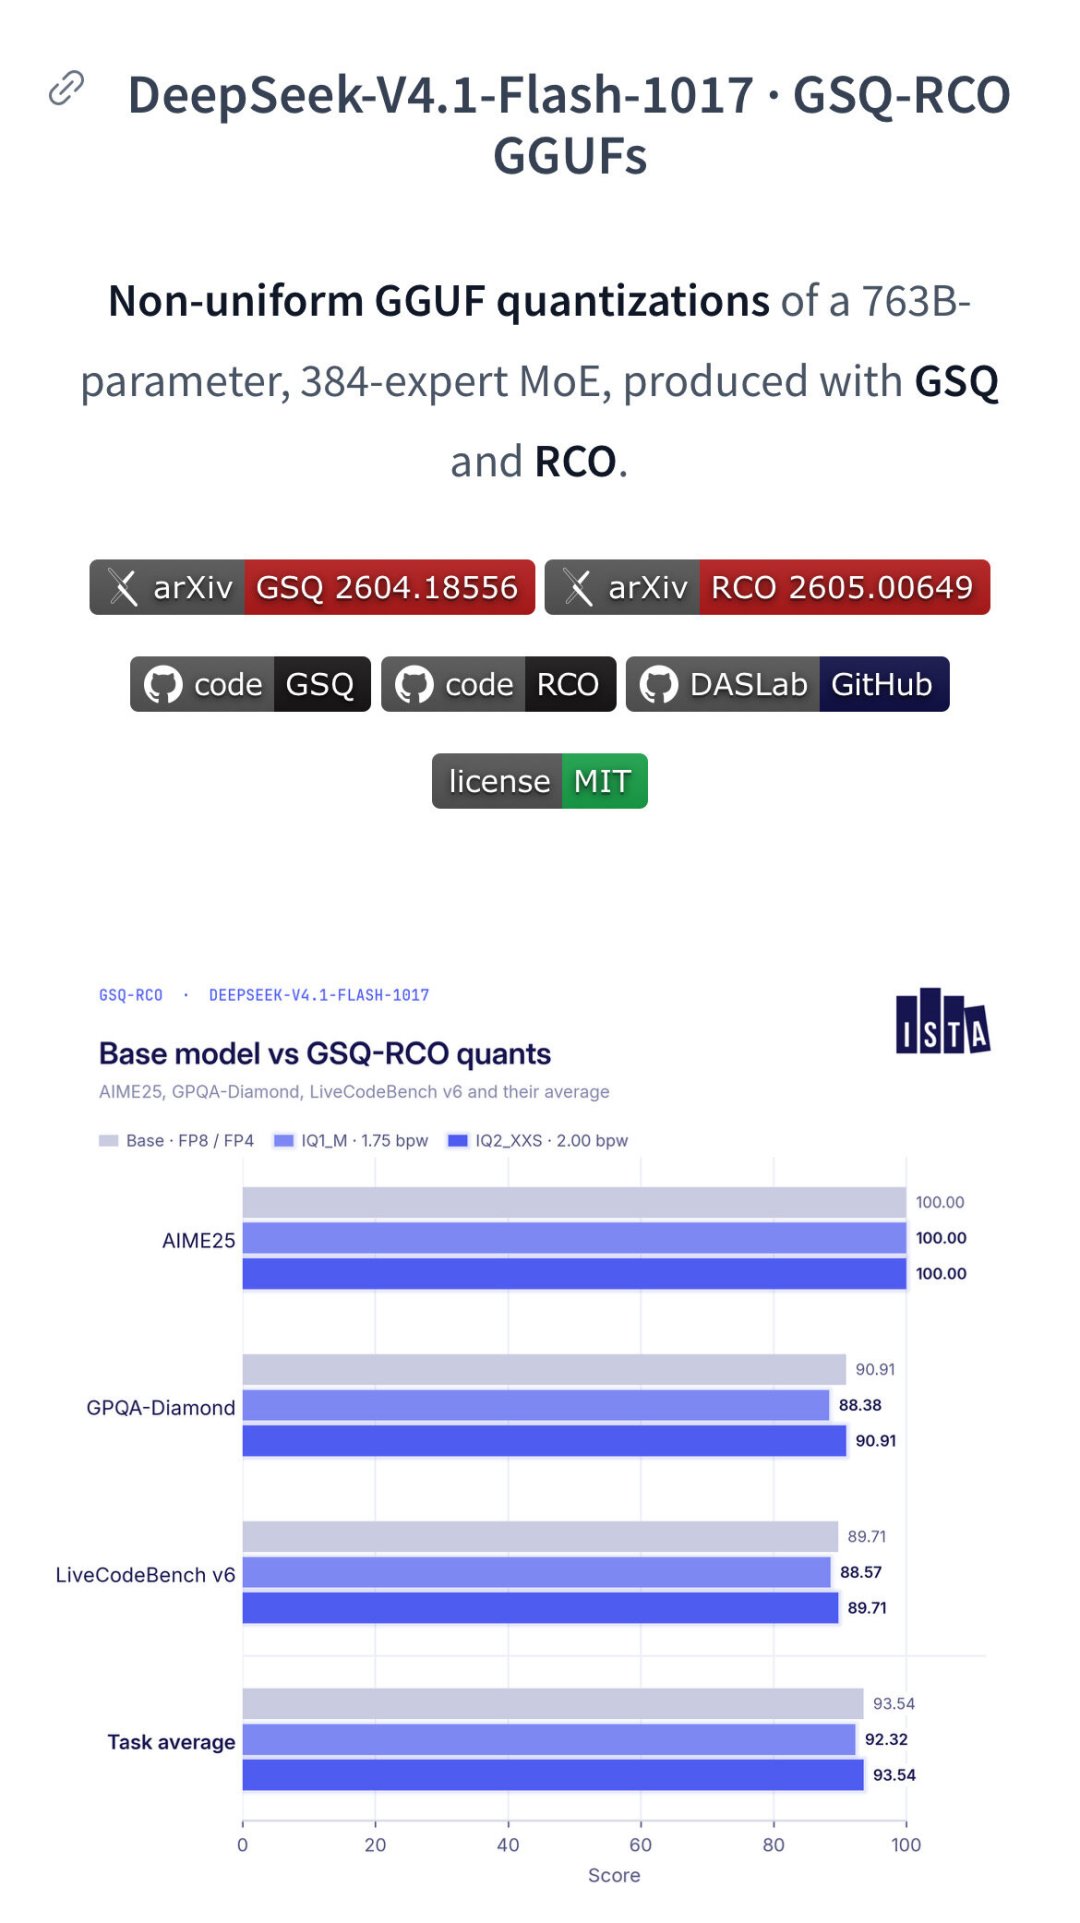
翻车帖和真香帖齐飞:有人把 2016 年老服务器加单张 3090 的长上下文生成速度推到热态约 121 tok/s、峰值 137.7,而且全程没换过一块硬件。但 3060 12G 的用户"试了 5 速度左右,果断放弃"。还有人说让模型画一张利润表曲线图吭哧吭哧要五分钟,想接着再画一张时上下文直接卡死。就连 v0.2.2 的复测也直言:吐字变快了,但长程任务还是翻车,短题 14 个过 11 个、长任务 2 个全挂。量化"降智"之争也没停——有人觉得量化必然换精度,也有人拿出 IQ2_XXS 档跑分拉满 100%、IQ1_M 掉 1.3%(恢复率 98.7%)的实测。证据盖到哪儿,结论就只能到哪儿:中小模型聊天、写小代码,够用了;长文档、复杂任务,目前别指望它替代云端。知乎哔哩哔哩知乎知乎小红书
现在该不该掏钱?我的建议是别急
这是最该冷静的一节。当下不建议为本地推理买新硬件:RTX 3060 已经全线复产,复产后的反常一幕是老卡卖得比新卡还贵,核心原因是新一代卡依赖的 GDDR7 显存成本飙升且供应紧张。内存价格同样在高位,而工具和模型还在一周三变的迭代期——硬件上车即过时。知乎
三类人分开看:
只想玩大模型:官方 API、免费云端方案足够,一分钱别花。
家里有 16G 内存以上的旧游戏本/旧 Mac:可以零成本装 Strata 抄作业,把预期调成"玩具+备用",坏了不亏。
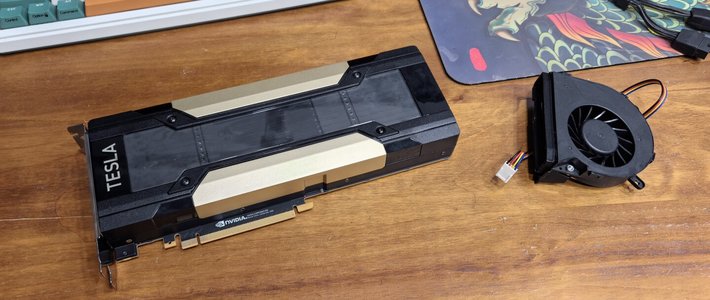
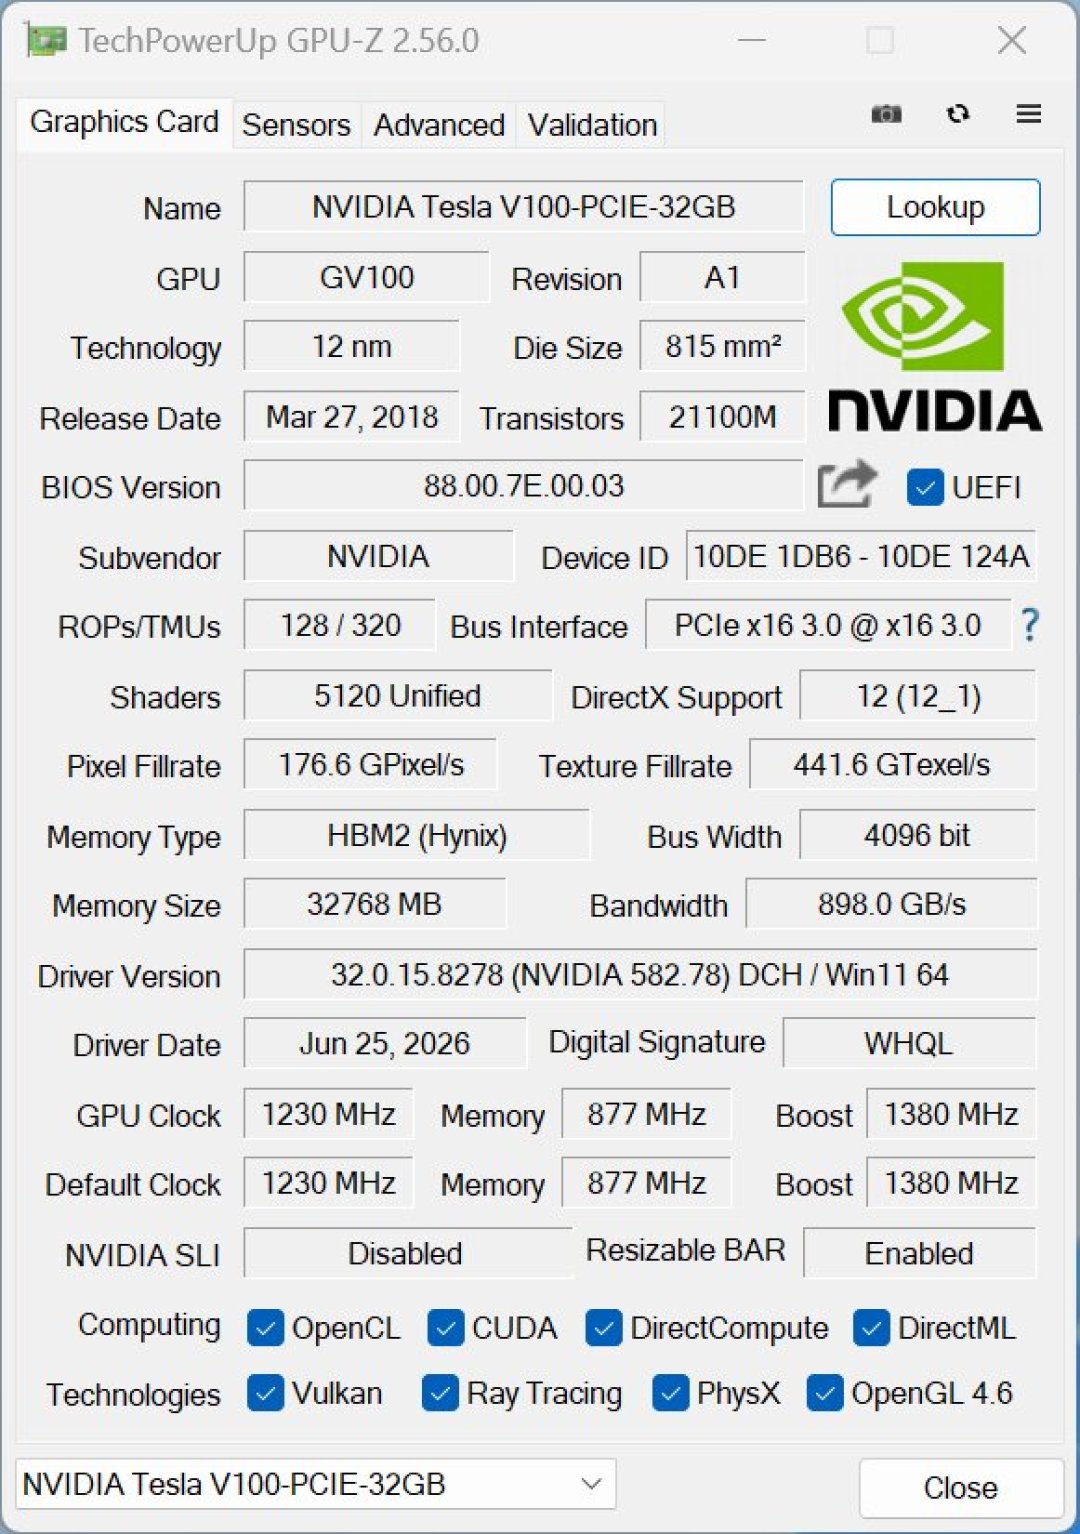
真刚需的人:涉密数据不出内网、离线环境、合规审计——评论区吵了几百条,最一致的共识就是"你不需要,不代表别人就不需要"。这类用户才值得认真配 32G 显存档,二手机房拆机的 Tesla V100 32G 三千多就能入手。小红书小红书
本地部署买到的从来不是速度,是"没人能给你限流、涨价、关停"的底气。推理门槛确实被砸下来了——显存需求从几百GB降到 8GB。但体验还在爬坡。等硬件降价和工具成熟这两个圆交汇,再上车也不迟——反正老卡还在闲鱼等你。知乎