十月中旬打开任何一个Agent开发者的社区,你会看到两条平行时间线。一条是知乎那篇「我打造了一个24小时不停工作的多Agent集群」实录,加上小红书「从0到1搭建Agent舰队,一个月省10w」的自述——数字均未经平台验证。 另一条,是10月18日到24日一周之内,知乎密集出现多篇给多Agent泼冷水的分析:Google/DeepMind/MIT的260组对照实验、南大论文对Codex、Claude Code、Kimi Code的2124次执行记录、Salesforce和Anthropic自己的一线数据。知乎小红书
三拨动机完全不同的来源——学术对照组、论文测量方、卖Agent的厂商——难得指向了同一个方向。这篇把散在各处的证据拼成一张图,顺便给出一套可以直接抄走的选型规则。
一、260组实验:多Agent赢在哪,输在哪
知乎一篇高收藏回答梳理了Google/DeepMind/MIT的对照研究(文中引arXiv编号2512.08296,笔者未获取到论文原文,以下数字均为二手引用):研究者固定了任务指令、可用工具和总算力预算,只让组织方式这一个变量变化,在6个agentic benchmark、5种架构、3个模型家族上跑了260组配置。 结论不是"多Agent不行",而是分任务:知乎
可分解的金融推理任务上,最佳多Agent配置领先约81%。知乎
顺序规划类任务上,多Agent反而倒退39%到70%。
同一篇文章还给了容易被忽略的工程细节:独立协调、没有中心验证的多Agent会把链路级错误放大17.2倍,而带中心化验证的架构只放大4.4倍。知乎
Anthropic自己的数据是,在BrowseComp评测里,仅token用量这一个变量就能解释80%的性能方差。 换句话说,很多"多Agent更聪明"的观察,先要排除"多Agent只是更费token"这个混杂因素。知乎
Salesforce Research的《The Illusion of Multi-Agent Advantage》更直接:六个自动生成的多Agent框架输给同一个模型采样五次投票的CoT自一致性基线,价格却贵出最多十倍。知乎
以"Agent多样性带来性能"为前提的DyLAN,在约70%的GPT-4o用例、超过90%的GPT-5用例里各Agent会立刻达成一致——花大钱买回一群互相点头的昂贵见证者。知乎
二、南大论文:并发子Agent的账单和故障清单
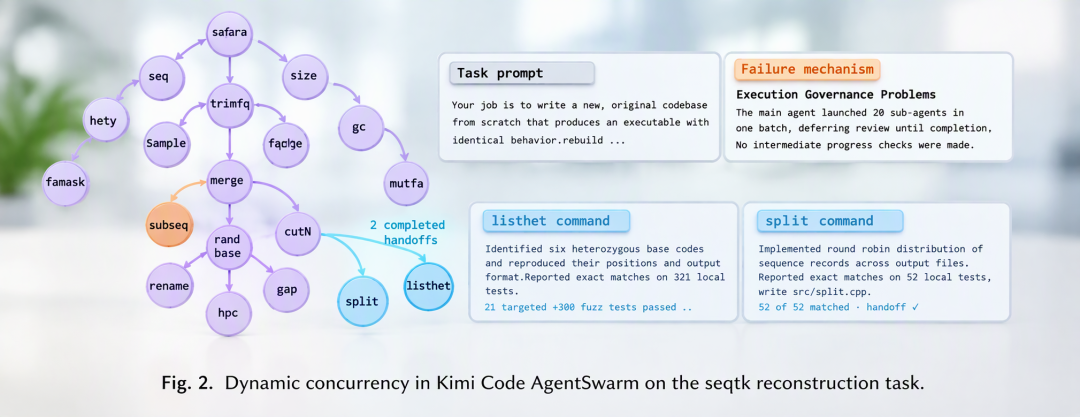
如果说前一组证据还是benchmark层面的对照,南大《When Sub-Agents Work in Parallel》就是直接扒了生产工具的执行日志:把Codex、Claude Code、Kimi Code的动态子Agent功能分别开关,在354个任务上跑了2124次执行,记录112亿token(模型组合选定于2026年7月)。 几组数字值得截图保存:知乎
并发模式的平均token用量是顺序执行的1.41到3.31倍,15个"Agent×Benchmark"组合里有14个并发平均耗时反而更长。知乎
366对双成功执行里只有102对并发更快,其中快至少20%的仅46对;
1062条并发轨迹中650条至少出现一种并发故障,累计标注804次,归纳成4大类、13子类、28个具体模式。
Codex首次派生子Agent的位置中位数在任务进度的4.0%,Claude Code是22.1%、Kimi Code是26.0%;
灾难样本:Kimi Code重建seqtk命令行工具,截止时间到只回收了2个子Agent的结果,其余18个全部中止,整个项目只通过92/440项测试。 ProgramBench上三家无论怎么开并发,完整任务通过率都是0%。
这也解释了一个不少人的体感:某些宣传"并发提速"的Ultra模式,用起来反而更慢。
三、45%选型线:什么时候多Agent仍然是对的
把三组证据合起来,可以提炼一条目前被反复引用的经验规则(原文补充:在SWE-bench Verified和TerminalBench的额外配置里方向吻合率94%,但它不是普适定律):大致在单Agent基线45%这个位置,超过这个点,再加Agent通常就不太可能带来提升。知乎
那什么情况下还该上多Agent?证据支持的只有三类:
真可分解、子任务间信息依赖少——金融推理侧+81%的赢家场景;
必须买覆盖面——比如并行扫描大量独立模块,但要按算力记账不按智力记账:多Agent买到的主要是覆盖面,这笔账得按算力算,不能按智力算。 一项被Meta引用的Mount Sinai临床任务研究给出了极端对照:80个任务一批时,多agent编排准确率65.3%,单agent掉到16.6%,token最多省65倍。知乎知乎
带中心化验证的架构——错误放大4.4倍对无协调的17.2倍,差距就是那个验证节点。把多Agent当编排负载而不是群脑:一篇10月24日的实战帖里,给推荐系统数据管道做的agent编排层就是1300行路由,把20多个workflow派给14个上下文隔离的subagent,自己不做任何领域工作。
四、不同人群怎么办
教程党和独立开发者:先做单Agent + 好harness。斯坦福CS329Z第一讲作业把17道题按Agent全流程从0走一遍,小红书逐集拆解里最说明问题的细节是:手写BM25倒排索引比逐封翻邮件快约2万倍——工程结构带来的收益,常常大于再开一个Agent。小红书
在选型的人:拿你的任务测单Agent基线。过45%这条线,把多Agent方案退回评审;没过线,先确认任务是"可分解"而不是"看起来可以分给不同的人"。
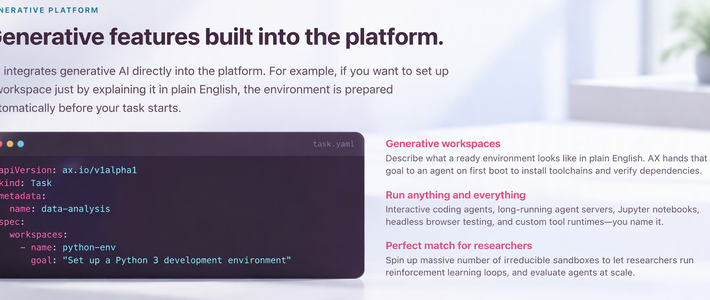
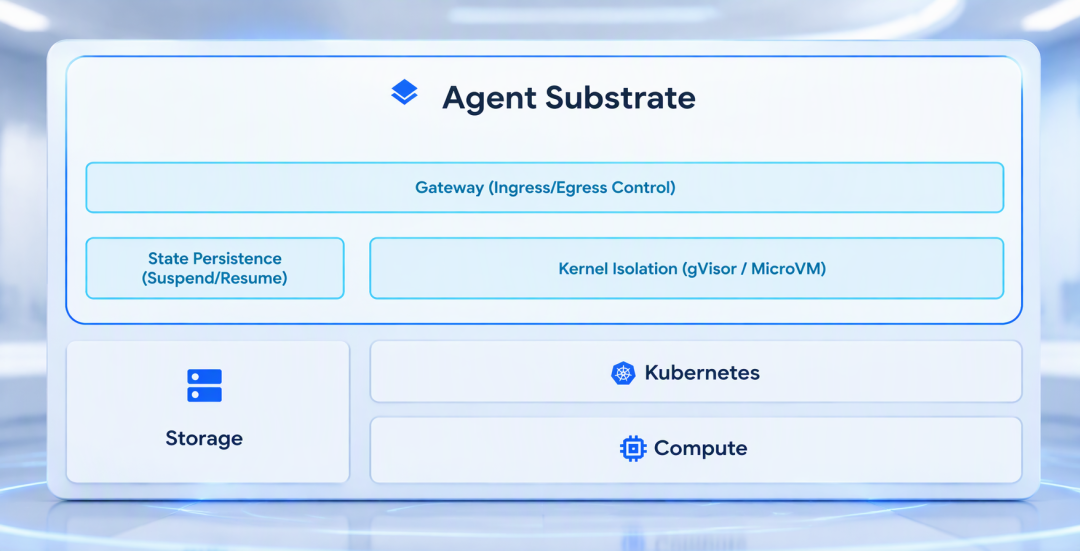
平台/架构团队:注意力可以往下移一层。Google开源的AX提出Agents are a new kind of workload,更合理的方式是让10000个逻辑Agent共享几百个实际Worker,只在真正需要工作时占用计算资源。 A2A的第一个稳定规范v1.0.0在2026年3月发布,8月进入Linux基金会旗下的Agentic AI Foundation。 微软则把维护模式中的AutoGen与Semantic Kernel合并,官方定名为继任者的Microsoft Agent Framework——圈的共识正在从"开几个Agent"转向"Agent作为负载怎么被调度和验证"。知乎知乎知乎
五、反证和边界
证据覆盖到哪里,结论就只能说到哪里。这轮祛魅研究全部基于固定预算对照,benchmark集合有限;南大的测量对象是2026年7月的三套harness组合——如果模型原生长上下文调度和并行能力继续变强,“并发更慢"的结论有效期存疑。而"省10万”"24小时集群"一类帖子均系发帖者自述,无一可提供账单审计。所以这篇能给的判断是:在当前主流的编码与顺序推理负载里,多Agent已从默认答案降级为例外答案;至于它会不会在下一代模型上翻案,值得设一个观察清单——看厂商博客是否修订口径、看是否出现端到端耗时(而非token数)计的并发故障基准、看45%这条线在新benchmark上是否还站得住。
一个行业在半年内从"人人都要Agent舰队"走到"先证明你该有第二个Agent",这个修正速度本身就是2026年Agent开发最有趣的地方:口号的半衰期,比模型版本还短。