10月26日晚到今天,中文技术圈的信息流被一个项目刷屏:ds4,别名 DwarfStar,作者是 Redis 创始人 Salvatore Sanfilippo(antirez)。 标题都很燃——“让 DeepSeek 在消费级硬件上运行”。但先给打算跟着教程折腾的朋友泼盆冷水:这个项目 5 月就出现在 GitHub 上,这两天火的是它对 DeepSeek V4 系列 Flash 模型的支持和几篇中文长文解读;而且它解决的是"装得下",不是"跑得快"。知乎
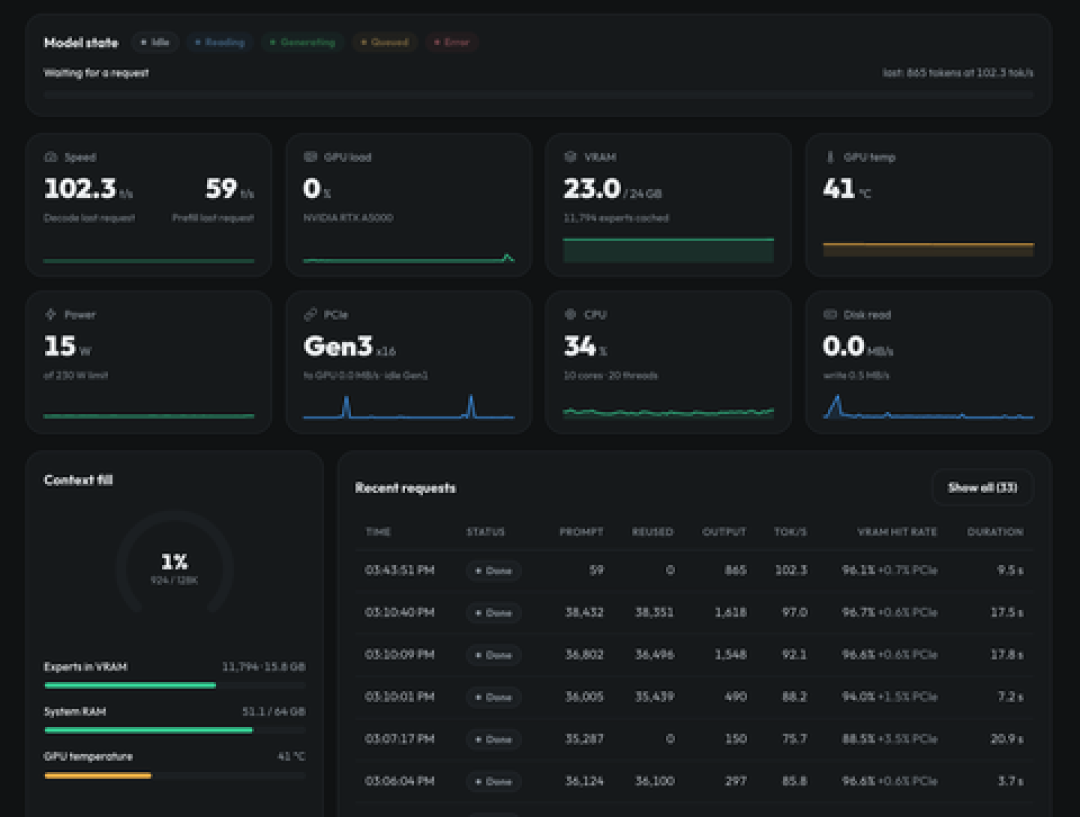
它不是另一个 Ollama,而是"窄而深"
用过 llama.cpp、Ollama 的人第一反应是:ds4 能不能直接加载我本地那堆 GGUF?答案是不能,它并不是一个通用的 GGUF 模型运行器,而是针对少数模型自己适配文件格式。 它的核心实现是纯 C 加各家 GPU 后端,只围绕少数高能力模型做专用优化:DeepSeek V4 Flash(提供 Q2 量化版,官方建议 96GB/128GB 内存机器初次体验)、V4.1 Flash(Metal 和 CUDA 的支持范围还有差别)、部分 GLM 模型(大型 GLM 即使 128GB 内存也可能要靠流式),部分 Qwen Flash 从 64GB Mac 起步。平台重点是 Apple Silicon Metal,另外支持 DGX Spark、通用 CUDA(含部分 Ada Lovelace 显卡)和 AMD Strix Halo。知乎
热度是真实的:微博上《Redis 设计与实现》作者黄健宏 5 月 11 日记录它"接近七千次加星"。 6 月 B 站解读视频的说法则是"发布短短几天一万三千 Star"。 两个口径不同,但方向一致——它是今年本地推理圈最受关注的新项目之一。微博哔哩哔哩
SSD Streaming:扩容,不是提速
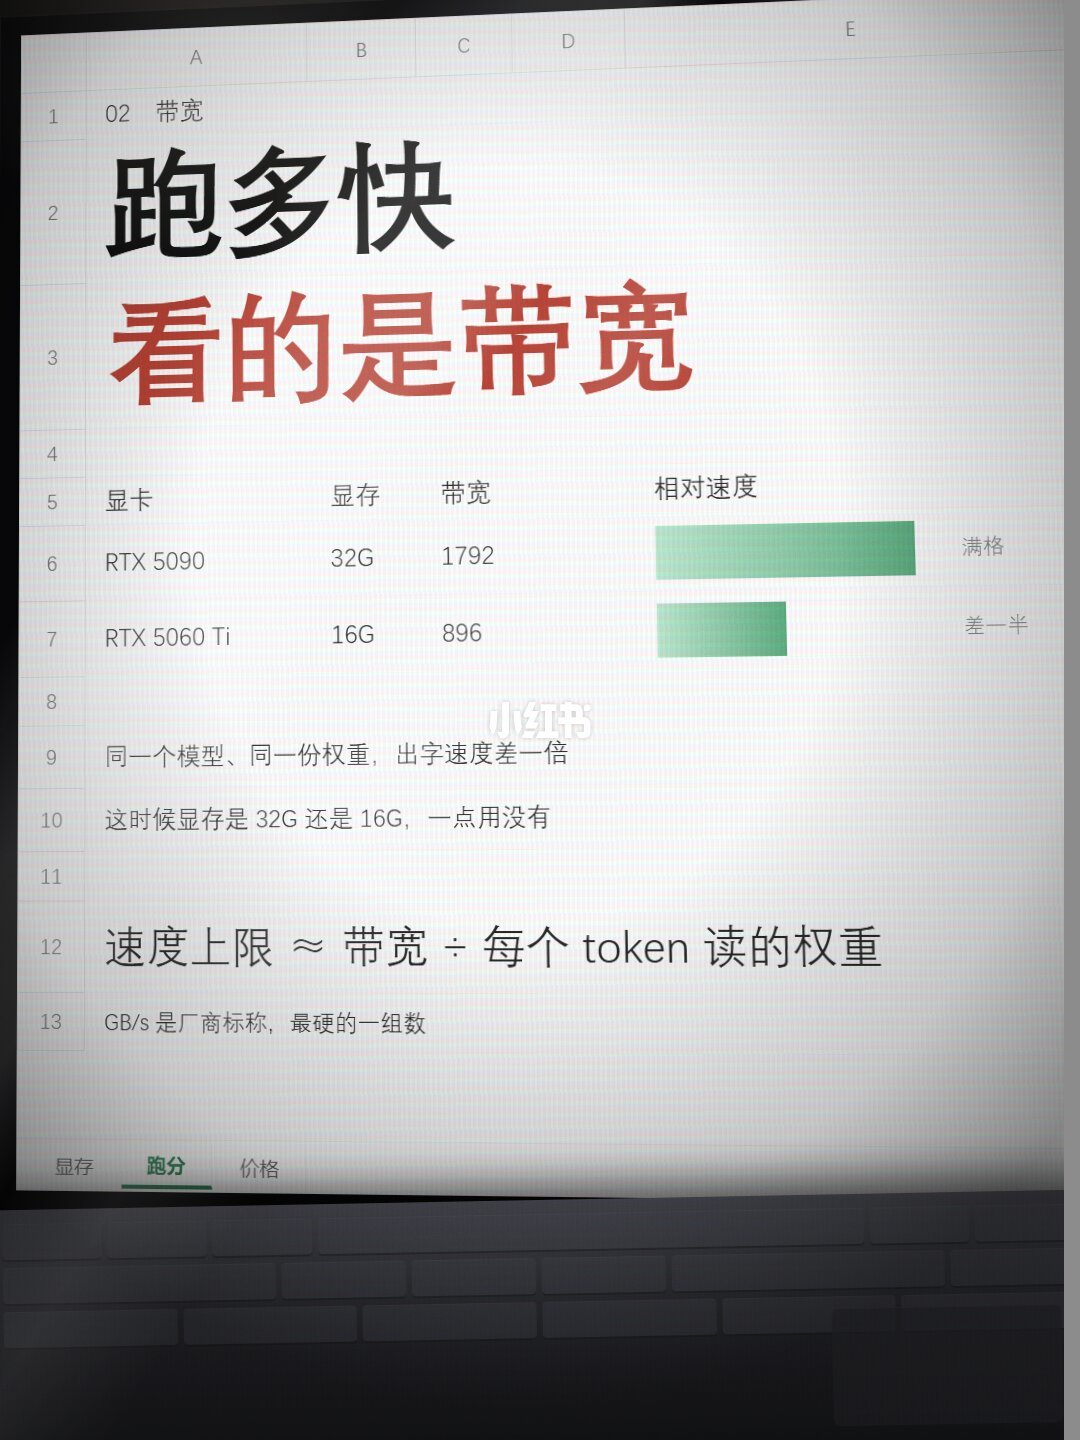
ds4 最值得聊的是 SSD Streaming:模型放不进内存时,让部分模型数据保留在 SSD 上,推理时按需读取。 这一下把"能不能打开一个模型"和"内存装不装得下"解绑了。但容量解绑了,带宽没有——消费级 PCIe 4.0 固态硬盘顺序读取约 7GB/s,PCIe 5.0 也就 12GB/s 级别;而 Apple M4 Pro 的统一内存带宽是 273GB/s,M4 Max 到 546GB/s,流式通道比常驻通道窄了 20-40 倍。MoE 架构是这条路的救命索:每个 token 只激活一小部分专家权重,要读的数据量比稠密模型小得多,加上专家权重对量化容忍度高,Q2 这种低比特在 MoE 上损失比想象中可控。官方 README 的 Speed 节放出了 M5 Max(128GB 内存)跑 V4 Flash Q2 的吞吐曲线,愿意先晒数据比只喊口号厚道。 但项目自己也写得很直:这项技术的价值是扩展可运行模型的范围,不是让 SSD 取代内存。知乎GitHub
和刷屏的 Strata 别搞混
同期另一个"小机器跑大模型"的明星是 Strata:教程标题就是"8GB显存畅玩125B千亿大模型",靠的是 GPU+内存+磁盘三级异构分片。 两条路线解决的问题相似,手段完全不同——Strata 想把任何大模型分层塞进小显存机器,ds4 则是押注 MoE 模型"本来就不需要全部权重常驻"。刚看完 Strata 教程的人要注意:ds4 不认 Strata 的文件,Strata 也不跑 ds4 的模型,别把两边的下载命令混着敲。知乎
社区的另一半声音:跑起来了,然后呢?
这次刷屏并不是一边倒的叫好。B 站 10 月 23 日搬运的 Matthew Berman 中配视频追问"本地AI到底是给谁用的",他的说法是即便具备强技术背景、充足算力和数据控制需求,真正完成工作时仍倾向云端。 知乎 10 月 27 日"DeepSeek 新版模型单周调用量登顶全球首位、环比暴增 801%“的问题下,高赞在算云端的账:API 便宜到这个程度,本地部署的动机只剩隐私和离线。 同一周 36氪的头条更是"DeepSeek 全面开源推理框架”,宣称兼容英伟达和华为昇腾芯片、单集群日吞吐 155 万亿 Token——云端侧也在同步卷速度。哔哩哔哩知乎36氪
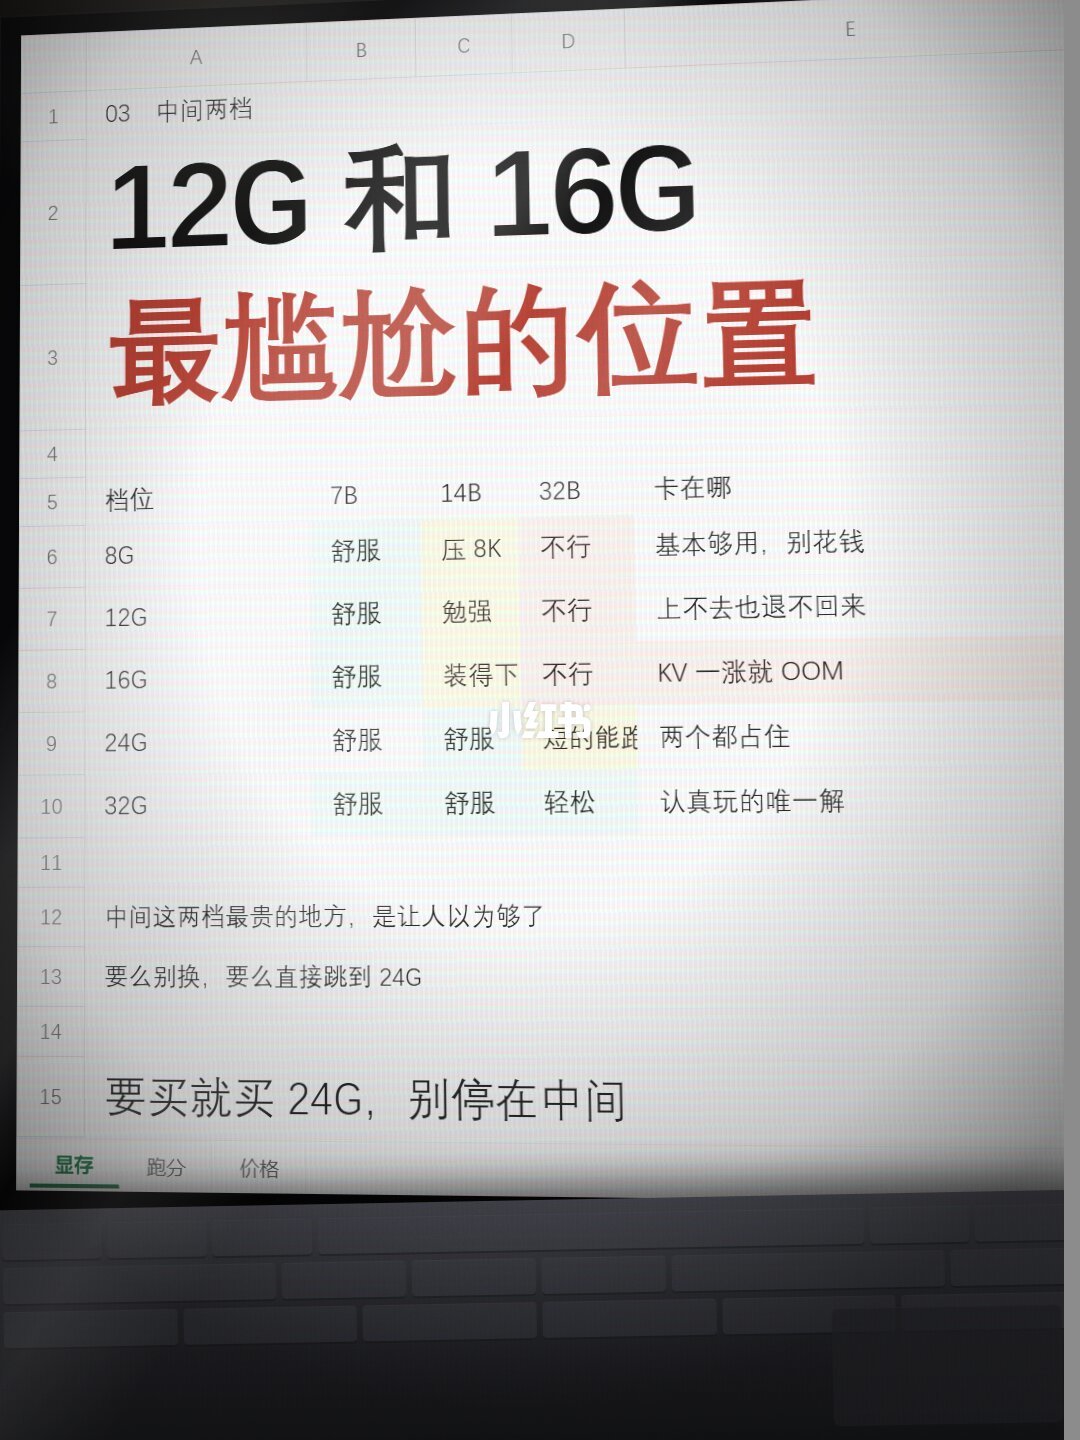
另一边的实操社区则是冷静帖当道。小红书上有人把显存从 8G 排到 32G 之后得出的结论是"我这张卡不用换",因为他分清了"显存管装得下、带宽管吐字快"是两个数。 知乎那篇《本地部署大模型到底值不值》的长文话说得更直白:4 个问题答不上来,装完也是吃灰。 还有 B 站工具科普 UP 主提醒新手:你下载到的 .gguf 有 99% 不是官方做的,"信谁的文件"是第一道坎。小红书知乎哔哩哔哩
谁值得动手,谁再等等
按你的设备对号入座:
64GB 以上 Mac 或大内存工作站 + 高速 SSD:值得试。目标是"打开过去打不开的东西",比如 96GB 机器用 Q2 版 V4 Flash 跑长上下文分析,心理预期放在"能干活但别嫌慢"。它还有条别人没有的后路:通过 RDMA 连接两台 128GB Mac 协同跑 DeepSeek Flash 或 GLM Flash 的特定量化版本,或者用流水线并行把模型不同层拆到不同机器,省下"升级更大单机"的采购。 但没有高速网络条件的单机用户,不必幻想两台普通笔记本能拼出 AI 主机。知乎
普通 16-32GB 内存、8GB 级显存的单机玩家:别指望 ds4,它没有把 V4 级模型塞进 16GB 机器的魔法。知乎一条 27 万播放的配置回答把顺序讲得很清楚:配置应从模型、量化位宽、上下文长度和并发数倒推,不要先认定某张显卡或某台电脑。 日常自用仍是 7B-14B 模型的甜区,想体验旗舰请先对比云端 API 的价格再决定。知乎
合规和隐私刚需(法务、医疗、涉密文档):本地引擎+全离线的价值成立,但选型看的是数据不出门,不是跑多大参数。
接下来值得盯的信号:V4.1 Flash 的 CUDA 支持范围会不会补齐;社区实测 t/s 和 Q2 量化在编码、中文长文任务上的质量损失数据(官方 speed-bench 目前只覆盖了 M5 Max 一条曲线);antirez 是否开放更多模型适配;以及 SSD 价格走势——"SSD 涨价行情或将持续到 2030 年"已经上了知乎问题列表,这条"用硬盘换内存"路线的原材料本身在变贵。知乎
一句话收个尾:ds4 让"本地能不能打开 DeepSeek"变成了伪问题,真正的分界线从这一刻起移到了"打开之后每秒吐几个 token"。在更多第三方实测出来之前,先看戏,别下单。