















21
26
自建RAG本地知识库,搭建私人文档问答机器人,查资料不用翻PDF
2026-10-22 22:27:30
0点赞
0收藏
0评论
一、之前存在的难题
我手头攒了非常多学习资料,大量PDF文档、Markdown笔记、电子书,零散存放在电脑各个文件夹。想要查找文档里面某一段知识点的时候,只能挨个打开文件,使用自带搜索,很多扫描版PDF甚至无法检索文字。有时候明明记得某个知识点在某几份资料里面,但是翻十几份文档都找不到原文。普通大模型没有办法读取我本地私人文档,直接提问,它只能依靠训练知识库,回答通用内容,没办法引用我自己保存的笔记、行业内部文档。如果直接把整篇文档一次性粘贴进对话窗口,有字数上限,长文档会被截断,而且每次提问都要上传一遍,操作繁琐。很多在线知识库平台上传私密资料,担心文档上传第三方服务器,存在资料泄露风险。
二、解决方案
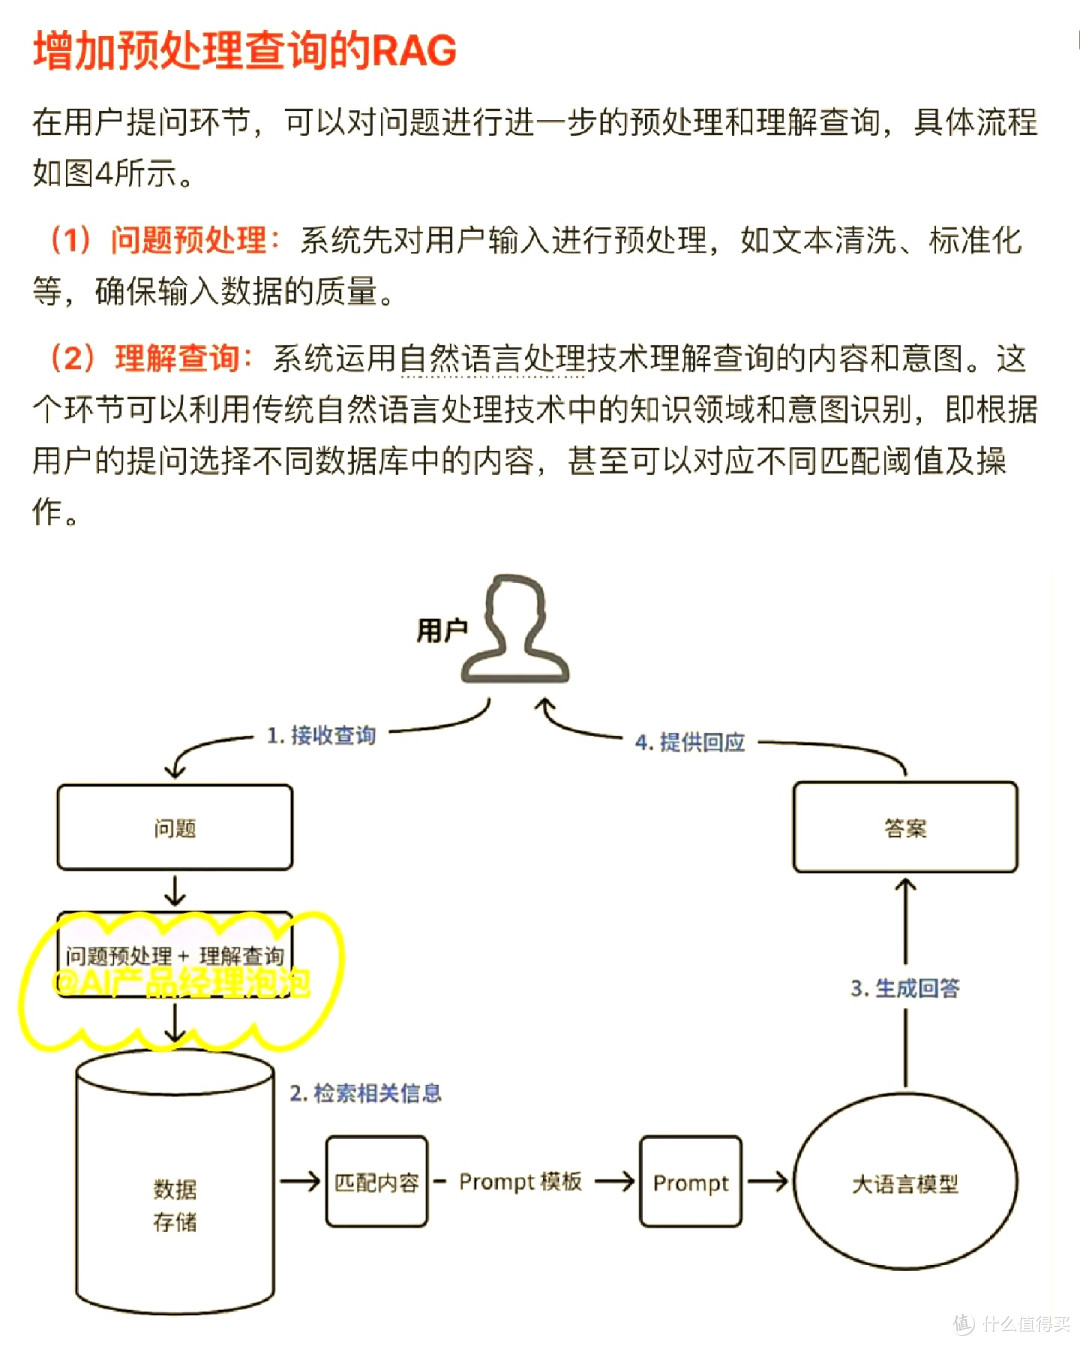
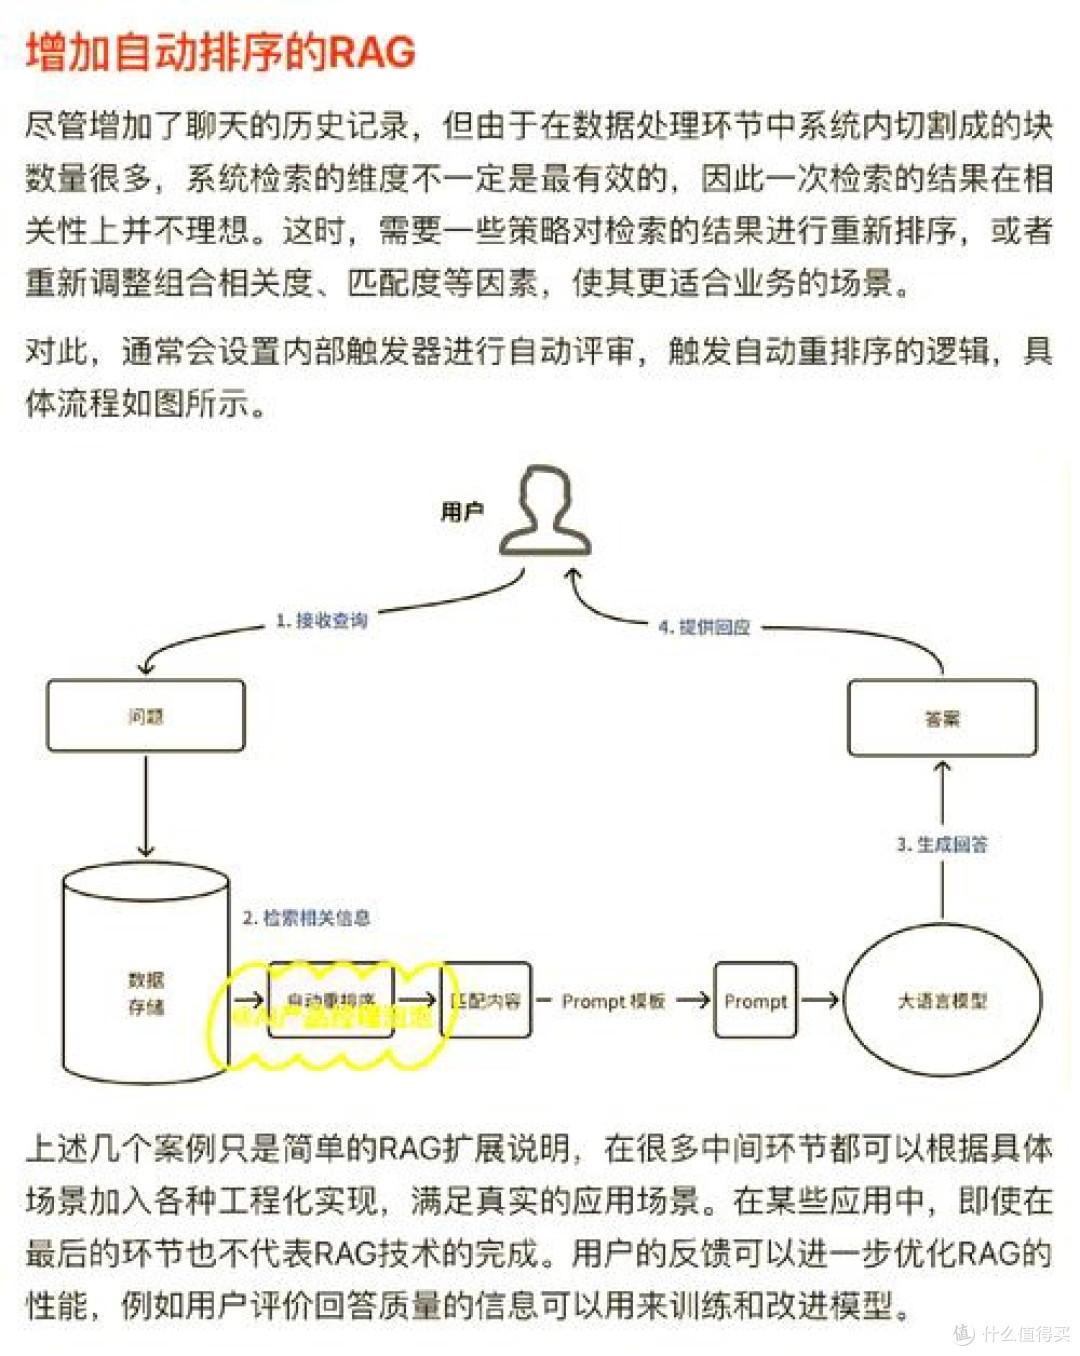
本地RAG方案支持在本机部署,文档导入之后执行文本切分、向量嵌入,存入本地向量数据库。用户提问时,先根据问题做向量检索,匹配文档中和问题相关性最高的片段,把检索片段连同问题一起送入大模型,基于检索出来的原文生成答案。支持多格式文档解析,包含PDF、Markdown、TXT。支持私有化部署,全部文档处理流程运行在本地设备,文件不会上传外部服务器。可以设置检索召回数量,控制参考资料片段多少,同时可以配置引用标注,回答附带原文出处位置,方便核对。
三、上手实测反馈
我挑选了5份技术文档,总大小接近300MB,导入本地知识库,等待文档解析分片,大概耗时十几分钟。全部入库之后,我提了一个非常具体的问题,需要找到文档里面某个参数的取值范围,机器人直接给出对应的说明,并且标注来自哪一份文档第几章节。我专门测试容易混淆的知识点,对比单纯直接问大模型,没有RAG的时候,AI给出错误参数,开启本地知识库之后,回答完全和我导入文档保持一致。我又测试扫描版PDF,发现图片型扫描文件无法自动提取文字,识别失败,需要提前OCR转文字文档再导入。我尝试问一份文档不存在的知识点,机器人可以识别知识库没有相关内容,不会强行编造文档里面不存在的信息。
四、日常使用体验
搭建完成之后,日常查阅资料体验提升很大,想找笔记里面的内容,直接提问,不用手动逐个打开文件翻阅。日常更新资料的时候,新增文档重新执行索引即可。但是首次大批量导入资料的时候,对电脑配置有一定要求,CPU差的机器索引文档速度很慢。我一般是晚上空闲的时候批量做文档入库,白天直接问答。使用一段时间发现,文档排版混乱、大量无关冗余文字会干扰检索结果,资料最好提前简单清理再导入,问答准确率会明显变好。
五、优劣分析
优点:私密文档保存在本地,不用担心外泄,能够精准引用个人资料内容,解决普通大模型不知道私人文档内容的痛点,适合整理学习笔记、行业内部资料。缺点:配置部署门槛偏高,新手需要花时间调试,扫描版图文资料需要额外OCR预处理,大批量文档索引比较吃电脑硬件,向量数据库管理维护有一点学习成本。
六、谁值得买或入手建议
适合手上有大量本地文档、重视资料隐私,经常需要查阅自己整理笔记的学习者、技术人员。如果你只有少量文档,只是偶尔查资料,折腾本地RAG性价比不高,可以优先考虑在线知识库。新手可以先拿少量TXT、可复制文字PDF先练习部署,熟悉流程之后再大批量导入资料。