10月28日下午,一条帖子在程序员时间线刷屏:一个人带着五十多个AI Agent上班,干出了二十个工程师的活儿。 按发帖人的说法,这位曾在Cursor任职、现在SpaceX AI做高级工程师的姑娘,工作流分三层:1个AI总管统筹方向,3个AI项目经理分配任务,40多个AI员工夜里自动跑,她每天早上泡杯咖啡验收成果。主帖479赞、398转发,两天内至少4个账号复读同一段文案,评论区清一色"mark"“未来已来”。但少数几个清醒追问里点赞最高的一条是——“感觉这得需要无限Token模式。”微博
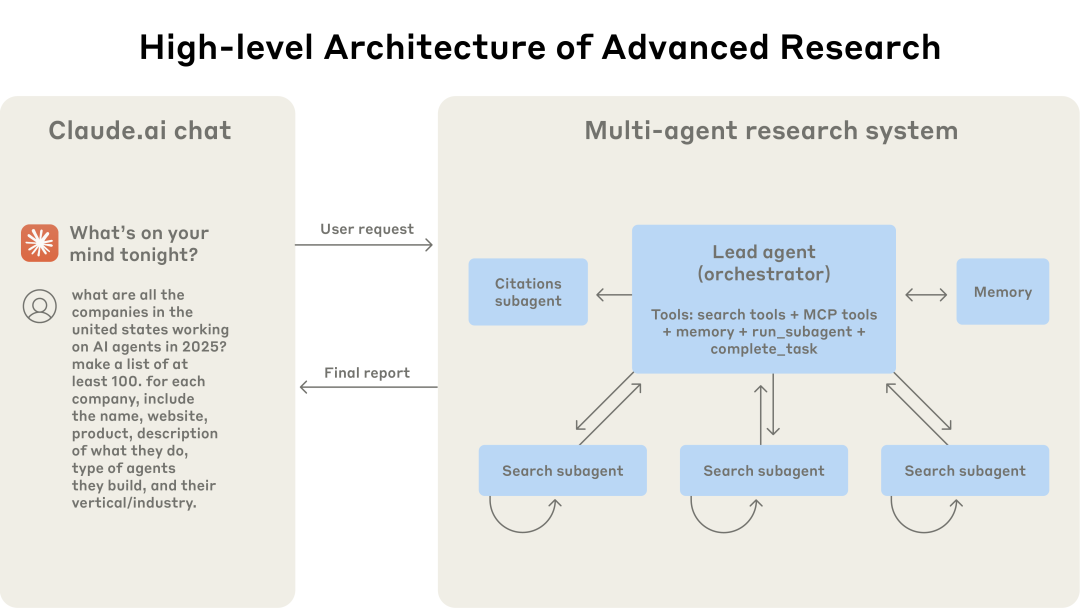
把微博、知乎、B站这两天的相关帖子、实测数据和工程讨论拉到一起看,我的结论是:这条帖子的主角有不少对不上的地方;但它拖出来的问题——你现在该不该给自己的工作流叠多Agent——是每个日活Claude Code/Codex的用户马上要做的决策。神话归神话,额度归额度。
一、先把神话降级,再谈技术
这条热帖里没被证实的部分,得在"学她"之前说清楚:
主角身份各源对不上。"曾在Cursor、现SpaceX AI"这个履历标签,同时出现在斯坦福CS146S课程的讲者、GrokBot演讲帖和AI Engineer大会演讲者(Jediah Katz)三条传播链里,指向至少三个人;"带50个Agent的姑娘"没有任何一手信源,评论区连性别都在吵。
数字自己打架。10月27日的另一条转述帖还在说,一个人真的可以指挥20多个AI Agent组成的团队,一个当Chief of Staff、其余负责项目管理。 10月28日主帖则变成"50多个",疑似同一素材在传播中演化。微博
越耸动的说法,信源越弱。“SpaceX AI内部97%工程师已经在用类似方式”"同内容以前有人卖5000美元"只存在于中文复读簇里,一手演讲未经验证。
传播面比"全网刷屏"的体感小。话题集中在微博科技号和一条B站演讲解读;知乎、小红书、公众号几乎没人讨论这个具体事件——知乎同期真正在吵的是另一条线:"harness工程"之争,光10月27、28两天就冒出近二十篇。
所以这类帖子的正确打开姿势是:人和数字当转述处理,只把它指出的问题当真。
二、三张账单:知乎上已经有人替你踩过的坑
"该不该堆多Agent"这件事,社区沉淀了一组硬得多、也便宜得多的答案——三张用别人实测换来的账单:
第一张:45%成功率门槛。有知乎回答汇总了多组编排实验的结论:单Agent任务成功率超过约45%之后,再加Agent的边际收益趋近于零甚至为负。 而独立并行的多Agent会把错误放大约17.2倍——没人互相检查作业时,每个Agent的幻觉都会变成下一环节的输入。知乎
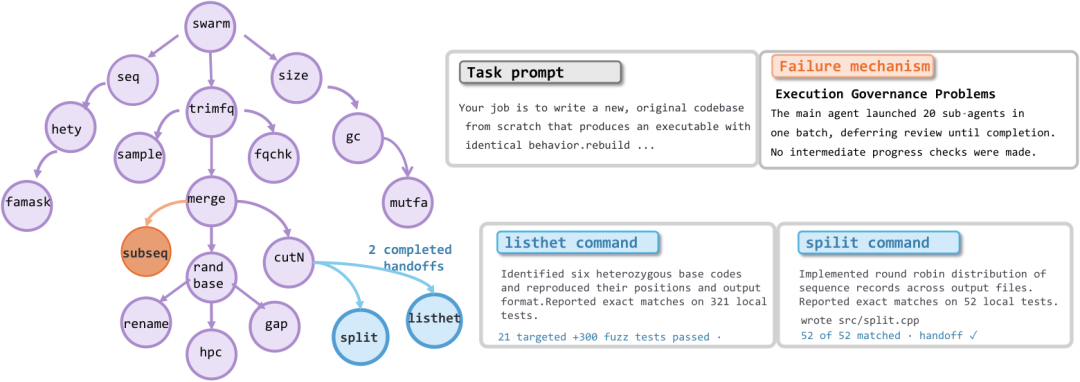
第二张:15倍的Token开销。同平台的实测口径:多Agent方案的Token消耗约为单Agent的15倍。 翻译成人民币:很多人的用法已经是"睡前挂长任务、早上验收",一位30岁资深程序员就晒出过"30天的活1天干完"的日常,那条回答拿了1071赞。 按套餐额度,15倍意味着月配额可能一夜烧光;按API计费,"跑一个长任务一天烧几十刀"本就是降本话题里的常态。热帖里那位"喝咖啡验收"的人未必在撒谎,但她的前提大概率是无限额度——这正是最高赞评论点破的死穴。知乎知乎
第三张:管理损耗,连Anthropic自己都认。其官方分享过客服场景的反面案例:拆了十几个"专家子Agent"之后,品牌口吻失控、延迟上升。 Meta的多Agent方案还被网友指出:全文没有单/多Agent同口径的成功率对比——没有对照组的成绩单,参考价值要打对折。知乎
正方当然也有:14个Agent自治"开公司"的开源项目、24小时多Agent集群,都有人跟。但仔细看,它们的任务共同点是独立、可验证、不用扯皮。
反例更有代表性:知乎一个40万浏览的问题问"为什么不下班前把需求丢给AI、第二天review",真实照做过的人答的是——第二天对着满屏红色报错发呆,因为AI没有你脑子里的业务上下文。 同样翻车还发生在老代码库上:一个跑了两年多、十一万行的老项目让AI加功能,AI花了90分钟,最后为了让编译通过,在第47行硬编码了作者自己的服务器地址。 项目过了临界点之后,AI最大的毛病是为了能跑,什么都肯干。知乎知乎
三、Agent Harness已死?模型吃掉的是编排复杂度,不是"管理"本身
这周真正有含金量的讨论来自AI Engineer大会演讲《Is the Agent Harness Dead?》,讲者Jediah Katz,在Cursor做harness资历最深的工程师之一,现在SpaceXAI。 演讲的转述口径里有两个值得记住的证据:伯克利用7个模型跑3套harness的实测,框架间差距只有约1个点;苹果×EPFL的实验里,“极简agent"对最强harness不落下风。也就是说,模型每变强一代,脚手架就被吃掉一层,harness在"亲手淘汰自己”。微博
但演讲里最值钱的是反转案例:他们做新一代产品时,“又把护栏一条条加了回来”。模型吃不掉的三样东西:基础设施、信任与安全、效率。中文圈最犀利的一条反证来自B站解读视频的评论区(11赞):“它虽然提高了用户使用成本,但公司财报更好看了。”——编排层进化的动机,不总是开发者体验。
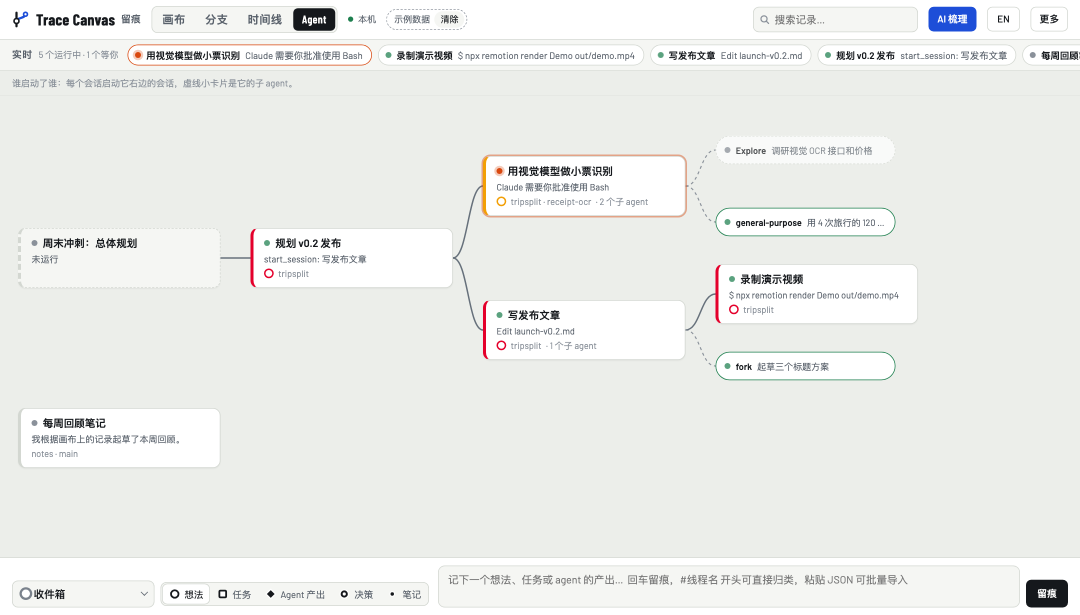
合起来的结论既不是"harness已死",也不是"Agent军团才是未来",而是:编排正在从"总管-经理-员工"的三层人肉式汇报,坍缩成"一个面板管多个会话"。这恰好和官方动向对上:Claude Code的AgentView已经支持一屏管理全部并行会话,Projects模式让主Agent协调多条线程;社区也攒出了配套工具——Orca把一条需求扇出给多个Agent,各自跑在独立的git worktree里互不污染,比完结果挑赢家合并。 emdash同思路;TraceCanvas则把多个AI编程会话画成一张交通图,指令、提交、决策是站点,分叉合并像git一样连成线,新开的Agent读图就能接上别人放下的活。 面壁智能还联合开源了PilotDeck这类harness工作台。GitHubGitHub
四、要不要抄?先做适用性判断,再从3个Agent起步
直接给日活用户一个可执行的判断:
适合试的:任务独立、结果可当场验证、错了代价小。比如并行跑多模块的测试与回归验证、日报和资料汇总类后台任务、做简单小应用和内容副业——vibe社区"一轮对话挂一晚、早上一杯咖啡验收",跑的大多就是这类活。
别急着上的:业务上下文耦合高、错误代价大的。核心业务逻辑改造、老代码库加功能、碰线上数据和钱的活,前面11万行项目硬编码服务器地址的教训就是现场。
动手路径,别一上来就搭"总管+经理":
先用完存量:就在Claude Code/Codex官方的AgentView或Projects里开3-5个并行会话,不加任何新概念,先摸清自己每周"能审得动"几个。
加隔离:用git worktree(Orca、emdash或命令行)给每个Agent一条独立分支和环境,先把"互相污染"这颗雷拆了。
再加可视化:会话上了8个再引入TraceCanvas这类工具。判断标准只有一条——你能不能在3秒内说清"哪个Agent在等我批准"。
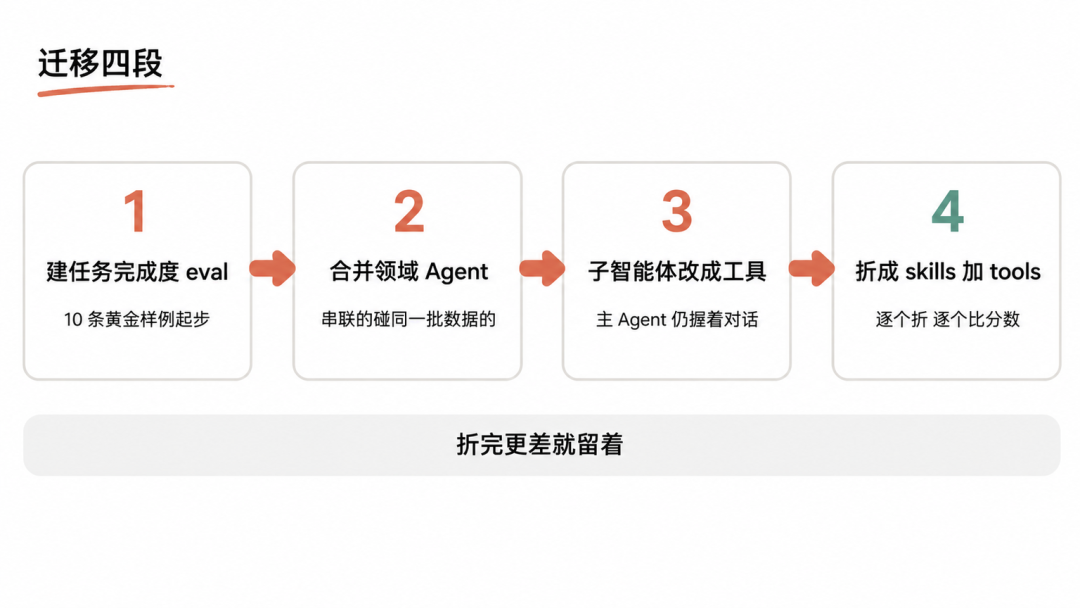
Anthropic那篇分享的迁移路线也印证了这个顺序:先建评测,再把领域Agent合并、把子Agent降格成工具、最后折成skills加进同一个循环——不是取消编排,而是把编排压薄。
三个观察信号,出现任何一个就先停止加Agent:每个任务的返工/修复行数开始超过新增交付;Token开销翻几倍但合入代码量持平;你的review开始积压——“早上验收"变成"下午道歉”。
尾声
“一人50个Agent"此刻更接近谈资而不是工作流:人、数字、信源都没坐实,坐实的是堆并行确实烧额度、确实放大错误。但方向也确实存在——争议已经在从"要不要让AI写代码”,挪到"你能同时管理几个Agent",编排能力正在变成prompt之后程序员的第二道分水岭。
抄军团之前,先从1个面板管住3个Agent开始。15倍开销、17.2倍错误放大这两张账单,拿来当预检查,比任何教程都便宜。