10 月 20 日,DeepSeek 把线上在用的推理框架 DeepInfer 以 Apache 2.0 开源了。连同自研算子一起打包,还支持了华为昇腾 950。知乎
本地玩家的第一反应大概是:我的卡能跑吗?答案就在 README 的硬件清单里,只有两行——英伟达 SM100、华为昇腾 950。4090、3090、3080,一张都没进名单。GitHub
这不太像“还没适配”,更像是这套东西从一开始就没打算朝桌面写。SM100 是数据中心卡,昇腾 950 同样是给机房准备的产品。
更关键的是,它开源的并不是你最想要的那一层。
官方给了一个很唬人的数字:单集群每天 155 万亿 Token,按谷价算每卡每小时收入 38 美元。撑起这个数字的,是 8 卡机器做 Prefill、64 到 128 卡超节点做 Decode。官方 benchmark 也写得很清楚:Prefill 用 4 张 SM100 测,Decode 用 64 张。知乎36氪GitHub
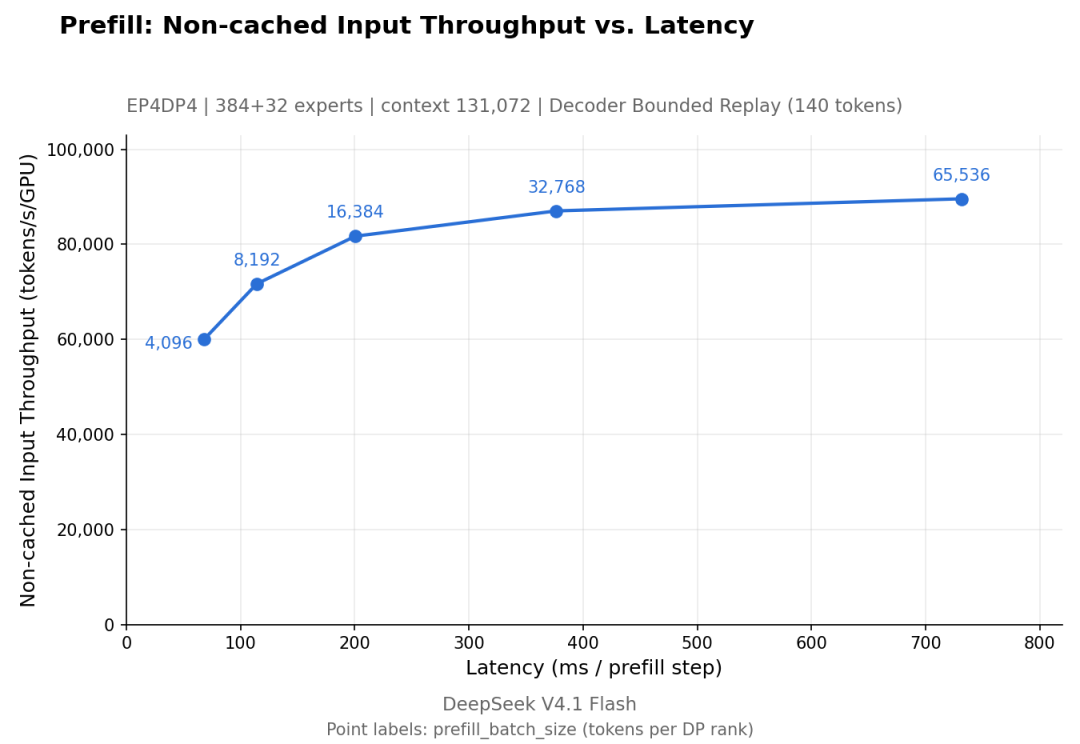
横轴是每一步的延迟,纵轴是单卡吞吐。这张图是拿 4 张 SM100 跑出来的,横轴起点就在你够不着的地方。
README 还附了一份“本次未包含”清单:KV cache 系统、Prefill/Decode 分离、跨副本负载均衡,三件套一件没给。官方自己的说法是,KVCache 管理和负载均衡跟内部基础设施耦合太深,代码尚未完整开源。GitHub知乎
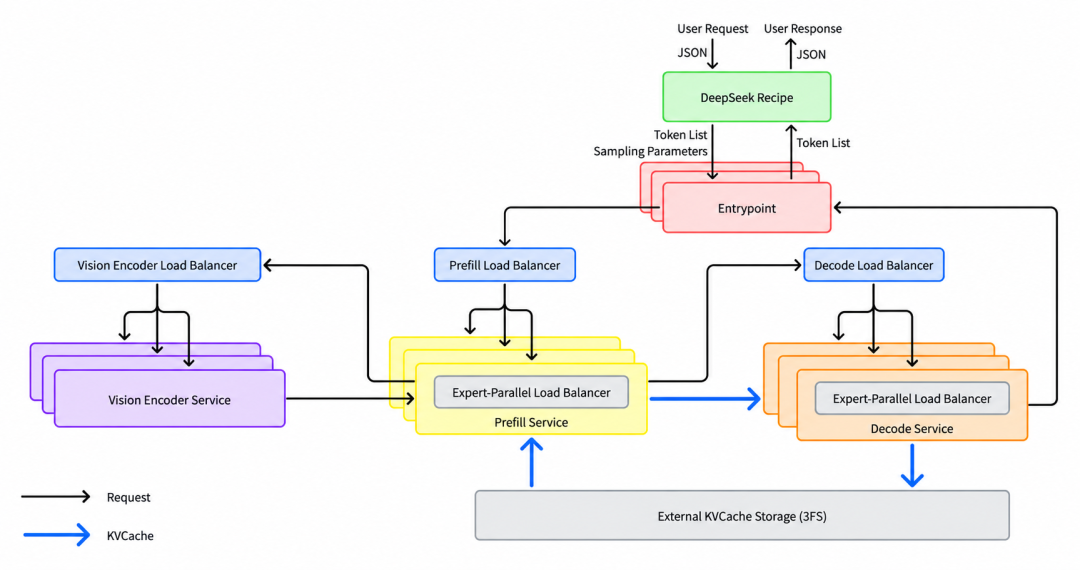
而这三样,恰恰是省钱的命门。官方那套 KV cache 放在约 100 PiB 的独立存储里,Agent 流量保留 3 天、聊天机器人保留 7 天。没有它,同样的请求你要反复重算——发动机开源了,油箱留在家里。36氪
但这份开源也不是没干货。SWA 缓存没命中时,它只重算最近 128 个 Token。这个抠成本的手法,比任何跑分都值得本地党抄。36氪
那本地玩家还有戏吗?有,但不是这条路。眼下最现实的是两台 DGX Spark:单台 128GB 统一内存,两台拼成 256GB。在这个基础上把权重压到 2.9bit,才换来自然语言单流 74.9 tok/s。这已经是能顺畅打字的水平,但离富余还很远。知乎GitHub
而且这一切的前提,是先把那 510GB 的账认下来。模型卡写 552B,磁盘上是 510GB。注意,这是一套要落地的权重,不是一个 5GB 的安装包。官方那条 8 卡命令算得更清楚:8 卡 640 GB、利用率 0.90,才留出 66 GB 给 KV 和激活。两台 Spark 那套方案更直接:主机端光是权重、Engram 表和派生的权重文件就要约 505GB 磁盘。卡你的不是显存,是总容量。知乎GitHub
至于“开源即免费”的想象,也值得拆一下。先说授权,模型权重是 MIT。框架 DeepInfer 走的是 Apache 2.0,二次分发也不设卡。代码确实能白拿,但让这套系统跑出 155 万亿 Token 的,是存储集群、超节点和调度系统,这些东西既不在仓库里,也不是家用能拼出来的。知乎GitHub
所以 DeepInfer 值得看,但别误会它的受众。它是给自建集群省电费的,不是给桌面党发门票的。对个人用户,它最大的价值反而是让你看懂两件事:你的机器为什么慢,以及慢在缓存和调度,而不只是显卡。
想在家跑 V4.1 Flash,短期还得靠社区量化和消费级引擎;想等 DeepInfer 支持你手里那张卡,先等官方把 SM100 之外的名单补上。