一张 2GB 显存的显卡,跑一个 7B 参数的图像模型。放在几个月前,这句话像是参数写错了。
9 月 29 日,qwenimage-ncnn-vulkan 的作者 nihui 把这个组合跑通了。模型没有被压成 2GB,权重仍是完整 BF16。他做的不是把模型缩小,而是不让所有东西同时待在显存里。知乎
Qwen-Image 的推理要经过文本编码器、视觉编码器、VAE 编码器、Transformer 和 VAE 解码器。它们本来就串行工作,项目改成哪个阶段要用就加载,跑完就释放。
Transformer 的权重放在主机内存,VAE 分块处理,块与块之间留重叠,避免接缝。显存峰值从“所有模块相加”,变成“当前最重的那一块”。
还有 KV 缓存。生成一张图要跑几十个去噪步骤,真正变化的只有目标 latent,前面的上下文没必要每一步重算。
项目先做一次 prefix prefill 把结果缓存起来;多参考图编辑时缓存太大,就按 block 流式处理,不把 32 层全塞进显存。
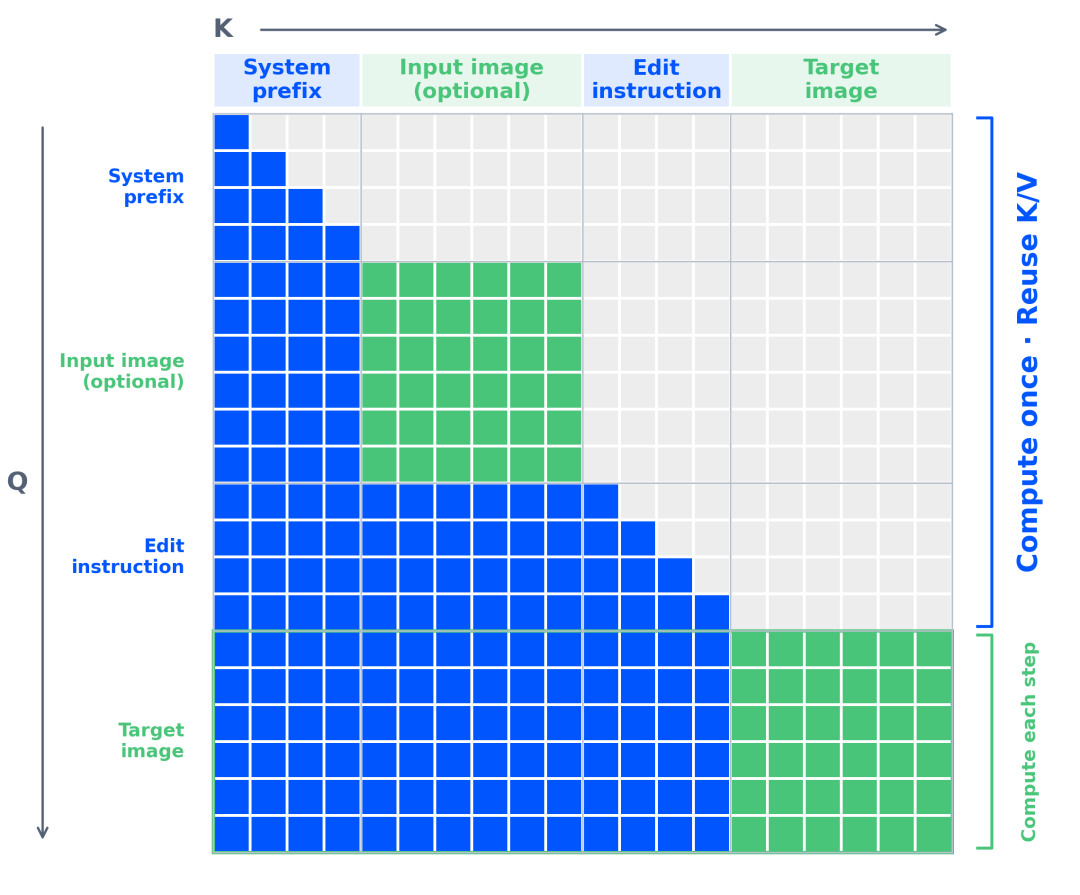
代价写得很直白:用更大的系统内存,换更低的显存门槛。它不是免费的,但它把“完全跑不了”变成了“可以跑,只是会慢一些”。知乎
对大多数人来说,2GB 是极限演示,更现实的档位是 8GB。Qwen-Image 2.1 的视觉生成部分只有 7B 参数,把文生图和图像编辑合在同一个模型里,原生支持透明图。千问大模型知乎
2070 大约两分钟出一张,5090 约二十秒。8G 显存可以选 int8 版本,文本编码器用 nvfp4,这是一个省显存的配置。哔哩哔哩
显存一样,内存、量化和驱动不同,速度和稳定性也会差出一截。8GB 能跑,不等于每台 8GB 都跑得一样。
11 月 3 日,Lightning v2 RL 更新,4 步去噪就能出图,文生图、单图编辑、多图参考都能用。对本地生成来说,这比再快一点的显卡更实际:同一张卡,试错次数多了,废片成本才降得下来。小红书
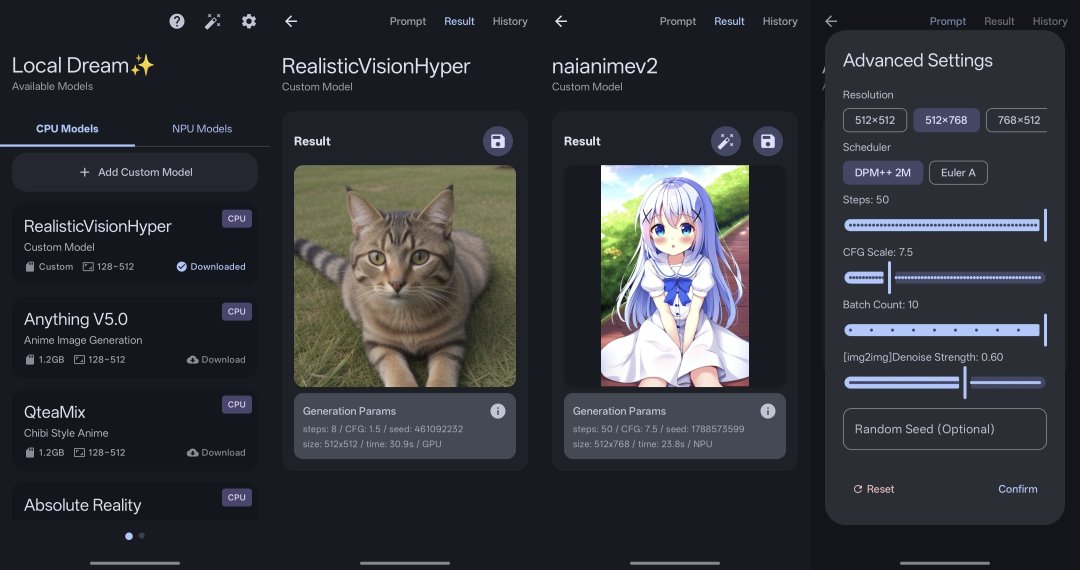
另一头,门槛还在往下掉。ncnn 版本不依赖 PyTorch、CUDA、ROCm 和 Python,NVIDIA、AMD、Intel、Apple Silicon 都能跑。知乎
同一套模型,红魔 11 Pro+ 和 12 Pro+ 用手机 NPU 跑,一张图两分半。哔哩哔哩
几件事放在一起,意思很明确:本地生成不再被 CUDA 和一张大显存卡绑死。
但“能跑”和“好用”之间还有距离。2GB 靠内存和等待换来的,是能出图,不是能批量出图。8GB 是现在的实用线:4 步加速后,速度能接受,试错也不至于太贵。再往下,更多是演示意义。
所以,第一道门槛正在从显存移开,移到内存、平台兼容和模型选择上。
手里有一张 8G 卡,先别急着换。装 int8 版本,配 4 步加速模型,拿自己的提示词跑十张,看看废片率,再决定要不要升级。
只有旧笔记本的话,2GB 的 ncnn 版本值得试一次,但别指望它替你干活。
技术把门推开了一条缝,走不走得进去,还得看你能接受多慢。