

先说结论:没有哪个生图模型样样第一。要的是“好看”、想找风格,用 Midjourney;要的是“做对”——字写对、商品不走样、改图听话,就在另外三个里挑:图里有中文用 Seedream,手里有几张图要合成、要换背景用 Nano Banana,要求复杂、需要边聊边改用 GPT Image。
下面这张表可以直接对照:
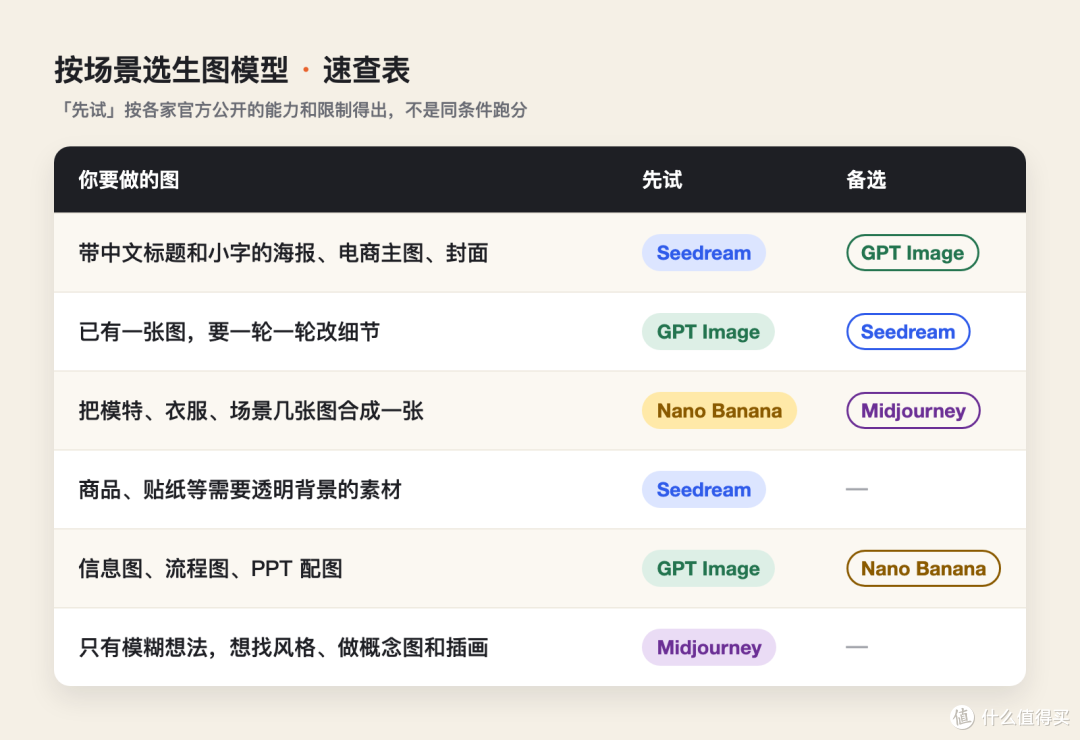
表里的“先试”,是根据各家官方公开的能力和限制得出的倾向,不是同条件跑分。具体为什么这样选,往下看。
先别问哪个最强,先问这张图怎样算“废了”
同样是“生成一张图”,失败的方式完全不同:
做活动海报,日期错一个字,整张图就不能用;
做商品图,背景再漂亮,瓶身上的 logo 变形了也不能用;
做品牌概念图,字字正确但构图平庸、没有记忆点,同样没用。
前两种要的是“对”,最后一种要的是“美”。这两类需求,刚好把四个模型分成了两边。
榜单上的总分,反映的是大量用户投票的平均偏好,替代不了你这一张图的标准。所以选模型之前,先想清楚:这张图出什么问题就废了?那一项,就是你最该比较的能力。
四个模型,各自强在哪、弱在哪
GPT Image:要求复杂,需要边聊边改
GPT Image 是 ChatGPT 里负责画图的模型。它最大的特点是“听得懂”:你可以把一大段要求一次说清,比如“左边放产品,右边三行卖点,底部留出放二维码的位置”;出图后也能接着说“背景再亮一点,瓶子挪到右边,其他不要动”,在对话里一轮轮往下改。OpenAI 在开发文档里也提到,密集文字、复杂版式、多个物体之间的关系,正是它需要在出图前多做规划的部分。
适合:
要素多、要求细的图:信息图、PPT 配图、产品功能示意、界面草图;
自己也没完全想好、需要边看边改的图。
短板,OpenAI 自己在文档里写得很清楚:
文字虽然进步很大,但把字放到精确位置、保证每个字都清晰,仍可能出错;
版式要求严格时,元素不一定落在你指定的位置;
同一个角色或品牌元素连续生成多张,可能保持不住一致;
要求越复杂,出图越慢,复杂提示词最长可能要等 2 分钟左右。
换成大白话:它适合把一张图“聊”到满意,但不适合要求像素级排版的定稿。最后的文字和位置,还得自己核一遍。
Nano Banana:手里有几张图,要合成或修改
Nano Banana 是 Google Gemini 的生图模型系列,强项是“用图说话”。一次可以放进最多 14 张参考图,Google 写明能保持最多 4 个人物的长相、最多 10 个物体的细节。比如你有一张模特照、一件衣服、一个房间,就可以说“让第一张图的人穿上第二张图的衣服,站在第三张图的窗边”。
它还有两个实用点:一是快,Google 把主力版本定位成速度快、成本低的日常款;二是能接入 Google 搜索,按真实信息出图,比如根据当下的天气、行情、近期事件做一张信息图。
适合:
多张参考图合成:换装、换场景、把产品放进实拍环境;
修改已有照片:换背景、换颜色、加减物体;
需要真实信息的配图。
短板,同样来自 Google 自己的文档:
你要 4 张,它不一定正好给 4 张;
图里要放文字时,Google 建议先让它把文字内容定下来,再要求生成带这些文字的图,说明一步到位时文字不总是稳;
人物超过 4 个,长相一致性就没有保证。
如果图里文字多、品牌要求严,Google 另有定位更高的 Nano Banana Pro,主打复杂任务和高保真文字;主力版胜在快。
Seedream:图里有中文,或者要直接能用的素材
Seedream 是字节跳动的生图模型,在即梦、豆包里就能直接选用,是这四个里国内用起来最方便的。最新的 Seedream 5.5 主打三件事,刚好都是做电商图、运营图最头疼的地方:
中文字更准:复杂字形、密集小字都更容易写清楚。官方示例里有一张蝴蝶科普图,旁边的中文小注释笔画再多也能看清;
多轮修改不走样:没要求改的区域会保持原样,不偏色,也不会越改越糊。官方演示对同一张人像连续改了 100 轮;
直接出透明背景:商品、贴纸、角色可以直接生成透明底素材,省掉抠图修边。
另外,它的光线、材质和皮肤质感更接近真实照片,AI 图常见的“油光感”和过曝也少了。
适合:
带中文的海报、电商主图、小红书封面、活动图;
需要反复微调的商品图、人像图;
要拿去做二次设计的透明素材。
短板:和 OpenAI、Google 不同,字节没有公开列出它的限制。官方说它在文字结构和写实感上领先 GPT Image、Nano Banana,但这是厂商自己的评测,没有第三方同条件复现之前,当参考,不当定论。从官方展示看,它主打的是“稳定产出能用的图”,评测场景集中在电商、营销、影视、游戏、办公和时尚设计。如果你要的是天马行空的风格探索,它不是第一选择。
Midjourney V8.2:只有模糊想法,想找风格
Midjourney 一直是审美最出挑的那个。V8.2 这次更新的重点依然是审美、画质和“个性化”,官方形容新版画面更有创意、更大胆、更精致。“个性化”会学习你平时偏好的图,让出图越来越贴近你的口味;再配合风格参考和情绪板,一组图可以保持统一的视觉风格。
很多人对它的印象还停留在“只能抽卡”。V8.2 把改图能力整合成了新的编辑模型:可以用文字指令改图,用最多 4 张参考图合成新画面,也能局部重绘、向外扩图。
适合:
只有一种感觉、还没有具体画面时,让它一次给出好几个方向;
插画、概念图、品牌视觉,以及海报里负责氛围的主视觉部分。
短板:
文字:官方说明英文等拉丁字母、短词短语效果最好,中文字不是它的强项;
太有“主见”:默认风格化很强,画面好看,但不一定严格照你说的来。想让它更听话,可以打开 Raw 模式或调低风格化强度,代价是少了那股味道。
按场景选:先问自己三个问题
第一,图里有没有中文字?
有,而且字要一次写对,先用 Seedream。文字以英文为主,GPT Image 和 Nano Banana 都可以。Midjourney 只适合放简短的英文。
第二,是从零画,还是在已有图上改?
从零画,而且要求多:GPT Image;
有几张参考图要合成:Nano Banana;
一张图要来回改十几轮:Seedream 或 GPT Image。前者更强调没改的地方保持不动,后者更擅长理解一句话里的多个要求。
第三,要“对”还是要“美”?
商品图、海报、信息图要“对”,在前三个里挑;概念图、插画、品牌氛围要“美”,先找 Midjourney。
放到具体场景里,大致是这样:
小红书封面,大标题加副标题:Seedream;
商品实拍换到新场景:Nano Banana 合成;要白底或透明素材,用 Seedream;
公众号或 PPT 里的信息图:GPT Image;需要实时数据时,用 Nano Banana;
新品牌找视觉方向:Midjourney。
还有一个现实因素:国内直接能用的是 Seedream,其他三个需要海外网络和账号。如果只想先用一个、主要做中文内容,Seedream 是阻力最小的起点。
组合着用,比押注一个更省事
一个人做内容,常见的分工是:
用 Midjourney 找方向:先出几组风格,定下色调和氛围;
用 Nano Banana 或 GPT Image 落到具体:把自己的产品、人物放进去,调整构图;
用 Seedream 收尾:加中文标题、做透明素材,或者做最后几轮微调。
不是每张图都要走完三步。大多数日常图,一个模型就够了;只有一张图既要“美”又要“对”时,才值得拆开做。
如果还拿不定主意,就用自己手头一个真实任务试一次:同一个需求给两个候选模型,各出几张,再提一次平时一定会提的修改。比较三件事:几张能直接用,改完后该保留的地方有没有被动,最后还要自己修多久。
最后记住一句话
要美,找 Midjourney;要对,看你的图:有中文找 Seedream,手里有图找 Nano Banana,要求复杂找 GPT Image。
当前文章无评论,是时候发表评论了