

货架开了:这次更新到底多了什么
11月12日,豆包工作完成产品更新,在豆包2.1 Lite和Pro两款自研模型之外,新增接入Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash等多款第三方模型。模型选择页同步标注了每款模型的额度消耗倍率。微博知乎
选模型不用先问哪家最强,而是两步:先看任务要什么能力,再在这一层里挑倍率最低的。轻活给豆包2.1 Lite和DeepSeek V4.1 Flash,长文给Kimi K3.1 Pro,法律、文献这类长链推理给GLM 5.3,正式交付给豆包2.1 Pro,拿不准就交给自动挡。
不同办公任务,分别把活派给谁
改文案、写周报、翻译、翻邮件这类高频轻活,创作者的实测结论是挂上0.01x限时倍率的模型就能接住,同样一份额度能扛原本几十倍的量。知乎
写长文、整方案这种要质量又要上下文的活,模型列表把Kimi K3.1 Pro标成0.95x的主力款,而用过的人的评语是它长文本的底子一直在,资料喂得多一点也接得住。知乎
代码和表格数据这类硬活,先试DeepSeek V4 Pro和GLM 5.3,一个0.46x一个0.8x,试错成本不高。GLM 5.3在创作者的清单里被标成旗舰,长程多链路推理、法律文献优先试。知乎哔哩哔哩
至于正式文档、翻译和行业文风这类要拿得出手的产出,豆包2.1 Pro被列为付费主力,倍率约0.65x。哔哩哔哩
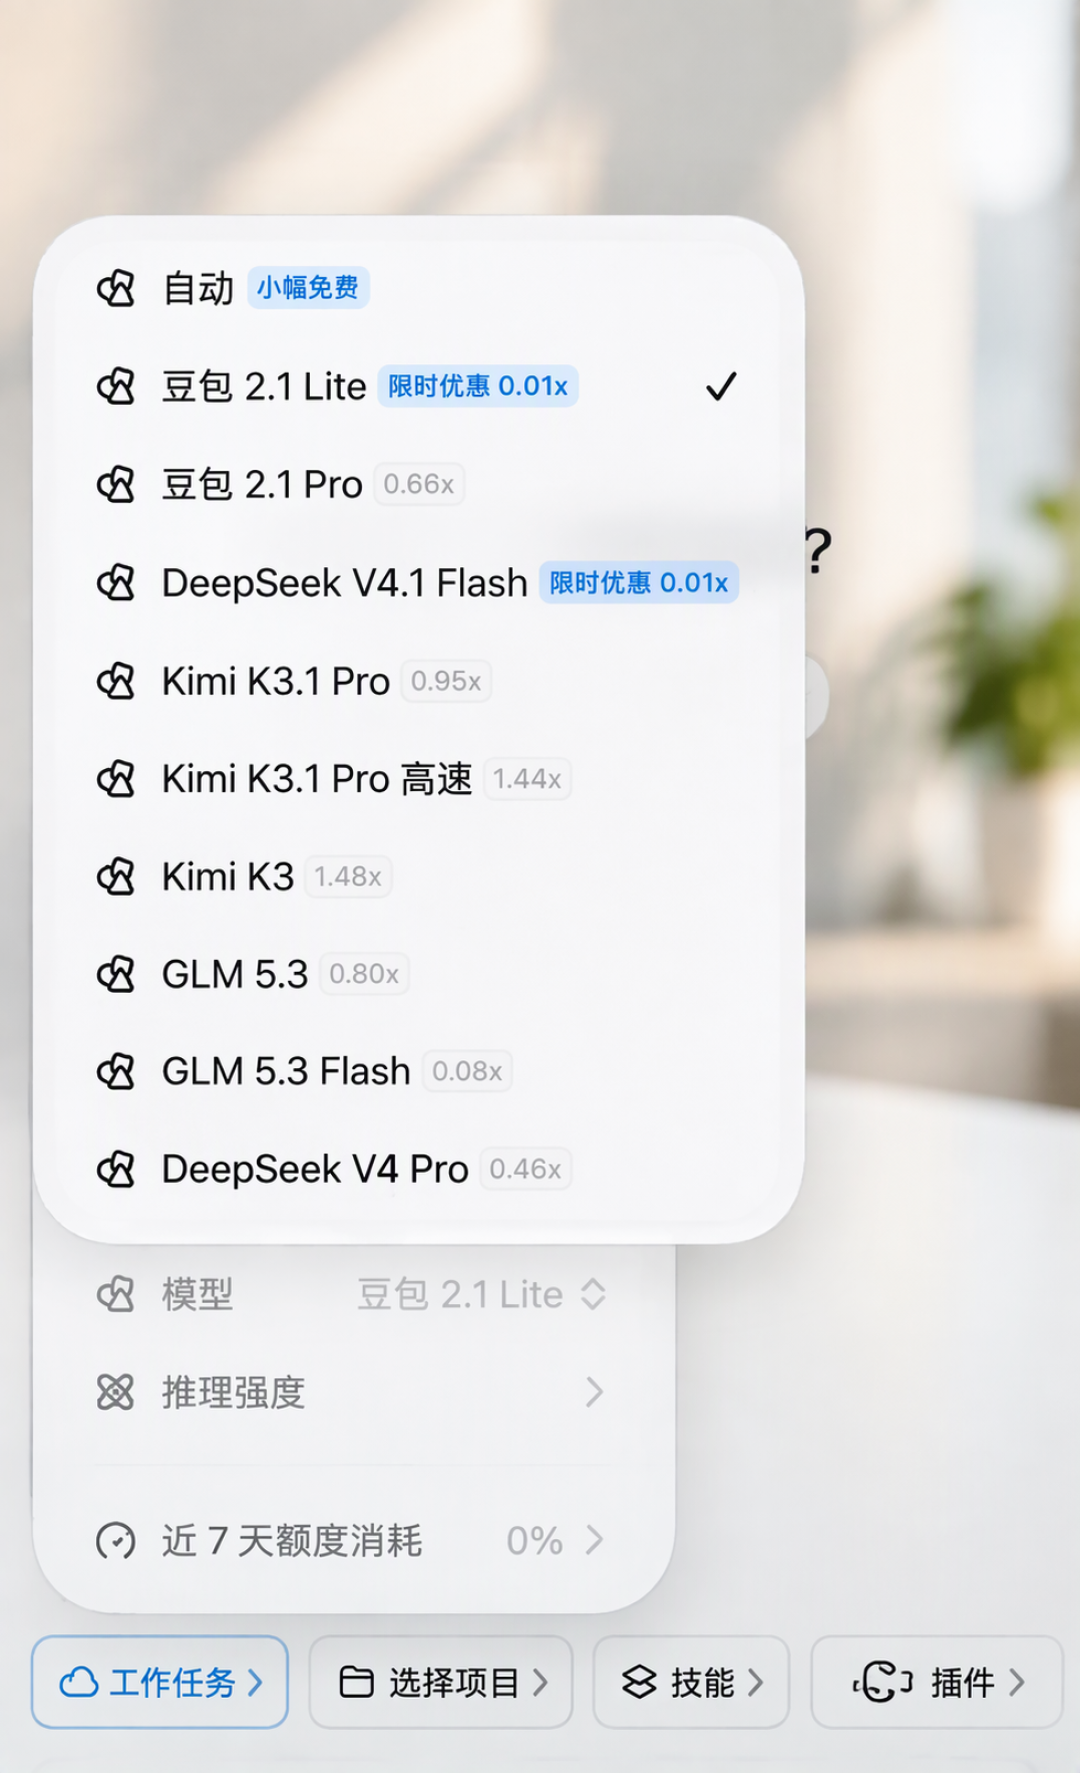
倍率真正的含义:把成本从黑盒里拎出来
倍率首先是计费系数而不是能力排名:倍率只代表计费不等于强弱,搭配多为手感,版本与倍率会迭代、需要复测。之所以要让用户自己算这笔账,是因为Agent任务的单次消耗远比普通问答不可预测——斯坦福数字经济实验室2026年4月发布的一项基于SWE-bench等基准的大规模实证研究发现,agentic编码任务的Token消耗量可达普通代码问答的约1000倍,成本大头来自输入侧。哔哩哔哩36氪
企业侧也是同一套逻辑:管理员可按成员、部门或场景配置可用模型范围,调用第三方模型的用量从企业已购AI点数中直接扣减,无需另行向模型厂商采购。倍率系数越低,消耗越少,用户可以根据自己的实际需要进行选择。36氪微博
上手之前,记住三个边界
拿不准选哪个模型时,可以先交给「自动」档:小额免费、按难度调度。哔哩哔哩
赶时间则要留一分清醒:第三方模型首字延迟通常比豆包系多。着急的活优先挂Kimi K3.1 Pro高速或GLM 5.3 Flash这类快档。哔哩哔哩知乎
免费额度也够用起来再说:新用户可领30天免费体验套餐,老用户每天登录签到可领额度。工作日及节假日的指定优惠时段使用参与活动的模型,还能享受额度消耗优惠,具体规则以官方活动页当日显示为准。知乎微博
货架的竞争已经溢出到豆包之外:11月16日,阿里旗下千问办公一口气上线了10款模型。36氪
至此,腾讯WorkBuddy、字节豆包工作、百度库库AI、阿里千问办公四家头部办公Agent产品,全部走上了多模型聚合的同一路线。36氪
当货架上同时坐着几家竞争对手,「该用哪个模型」的答案就重新交回到了使用者手里:货架宽不等于每款都要用,GLM、Kimi被清单标成专项款,非垂直需求不必上。哔哩哔哩
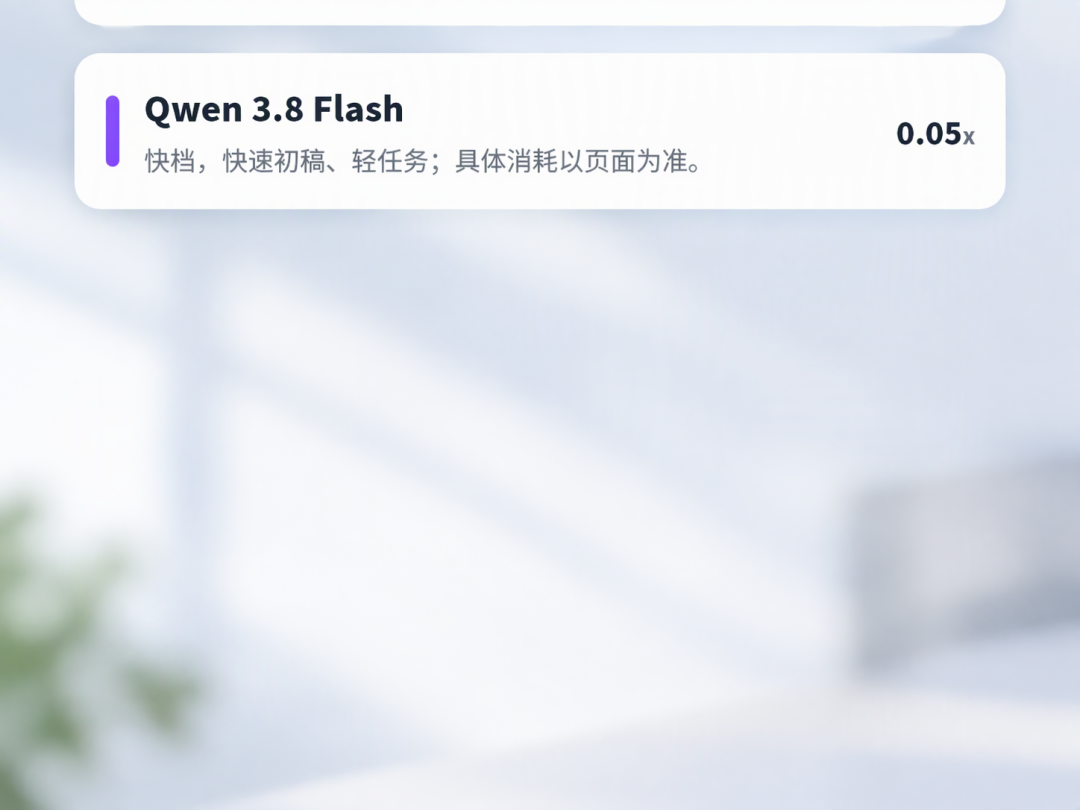
最实用的上手方式不是背参数:先花一两天,拿自己手上的真实任务把低、中、高几档各跑一遍,再用倍率给自己算一次账——这一阶段该派给谁的活,答案自然出现在你自己的消耗清单里。

当前文章无评论,是时候发表评论了