

上周小红书还在刷「5个神级Skill,装完Codex直接开挂」,1.7万人点赞、3.5万人收藏;同期一条三分钟讲怎么装 Skill 的干货,2.3万赞、3.7万藏。这周就有人把账算出来了。小红书小红书
11月16日晚,有人刷 GitHub Trending 刷到 NVIDIA/SkillEvaluator:当天 +953 star,总数 2314(他抓取那一刻的快照)。这仓库干的事特别扫兴——把你装的 Skill 扒下来,同一批任务跑两遍,一遍带、一遍不带,其余条件全锁死,然后相减,差值叫 Skill Lift。知乎微博
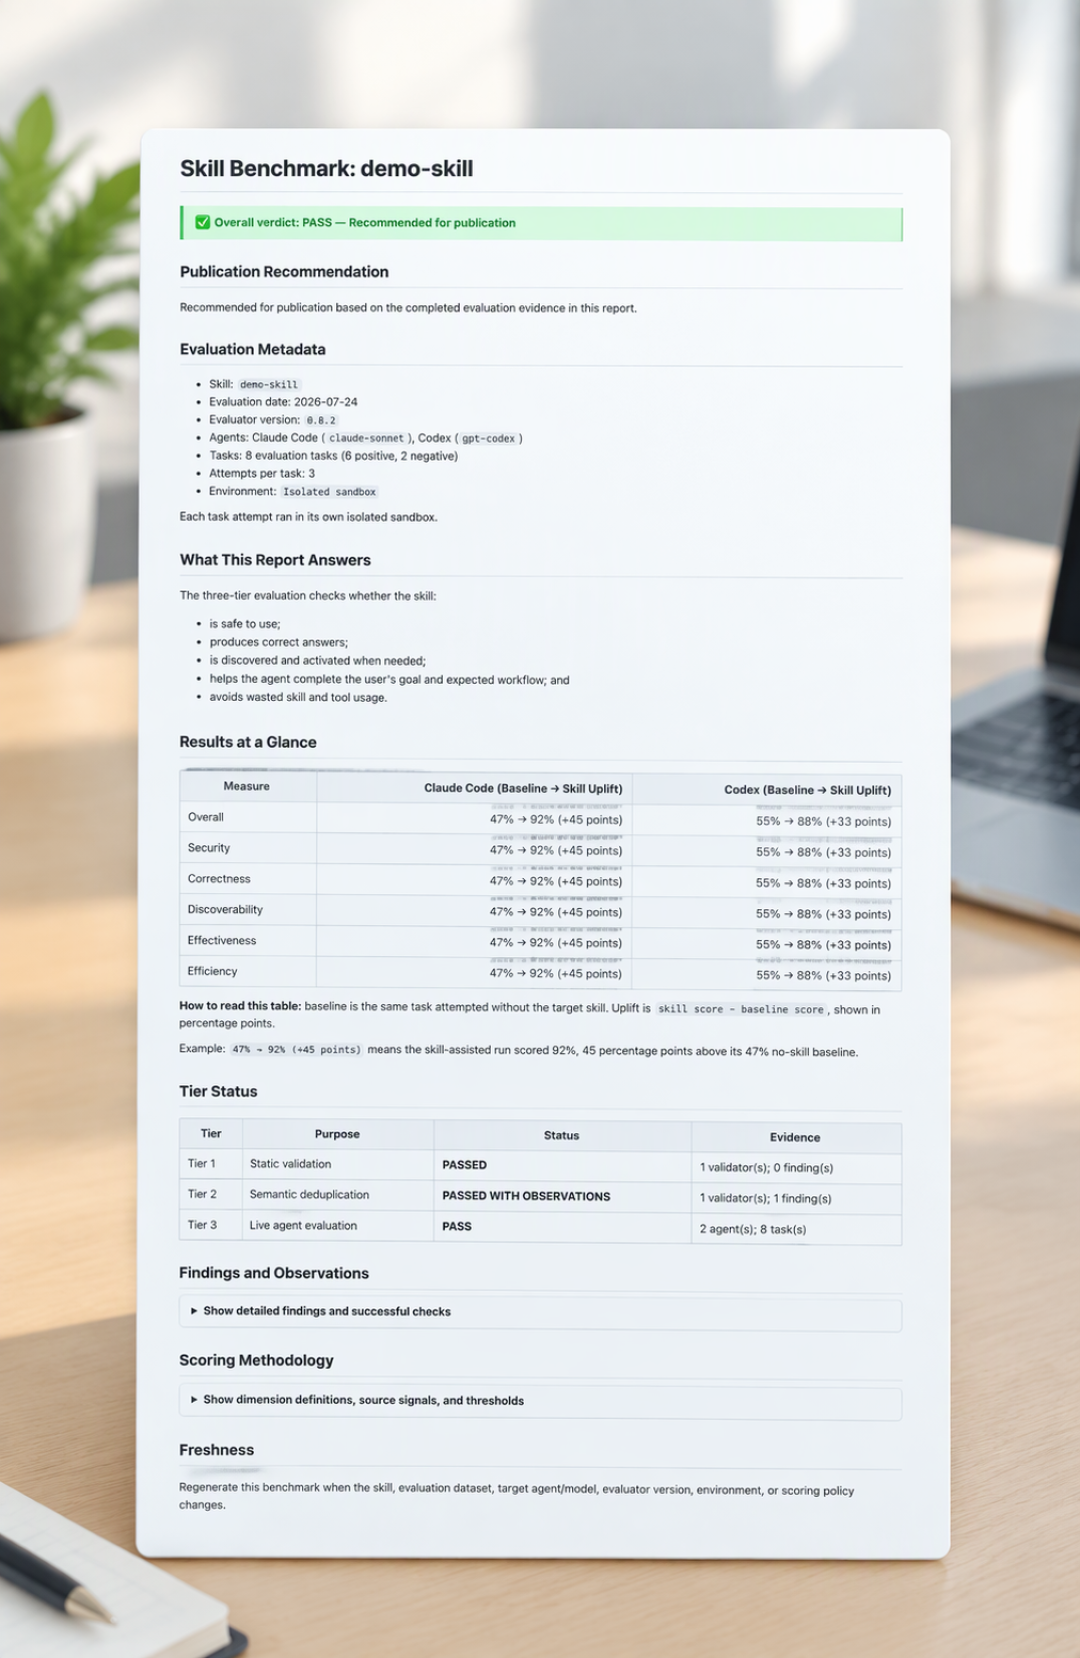
背后那篇论文(ACES,arXiv 2608.20614)跑了 947 组配对,覆盖 58 个真在生产环境干活的 Skill、4 种运行外壳。结论分两半:Skill 确实有用,平均综合增益 0.2134,95% 置信区间 [0.1967, 0.2301],72.8% 的配对为正;但换算过来,大约每四组里就有一组,装了跟没装一样,甚至更差。口径也得钉住:0.2134 是归一化尺度上的分差均值,不是百分制的"提升 21 分",而且这批数只在固定任务、固定外壳、固定沙箱下成立,换模型就不跟着走,唯一的用法是跟自己比。知乎
结构分 88.8,效果可能一文不值
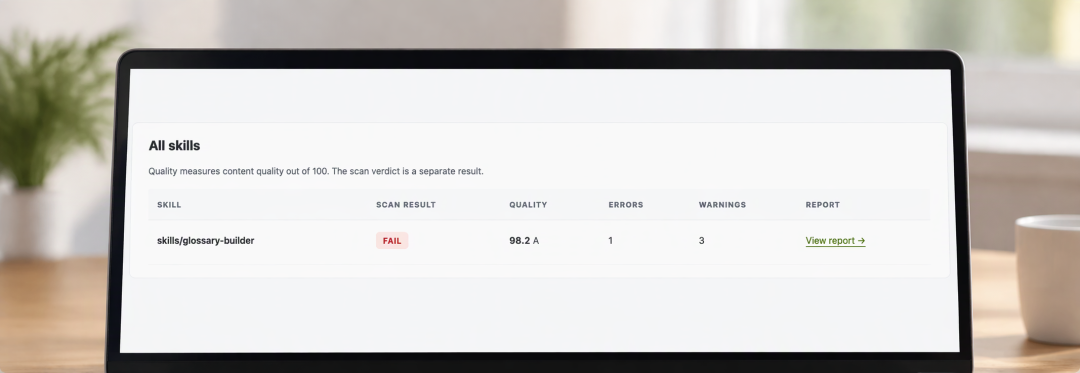
多数人判断 Skill 好坏,看的是写得整不整齐。SkillEvaluator 把结构扫描和实际效果都测了,算了个秩相关:0.14——两张榜单大体各排各的。二十个 Skill 按结构排一遍、按效果排一遍,中间十来个名次基本是乱的。
仓库自带的示例 Skill 结构分 88.8,评级 B 档,默认及格线 70。示例都只到 B,说明这个分段讲的是"挑不出毛病",不是"好用"。结构扫描该干的活是拦垃圾:空文件、缺字段、明文密钥、"忽略之前所有指令"这类越权话术,几秒钟、不花钱、不调模型。它不该干的活是排序。知乎
先跑不要钱的那两层
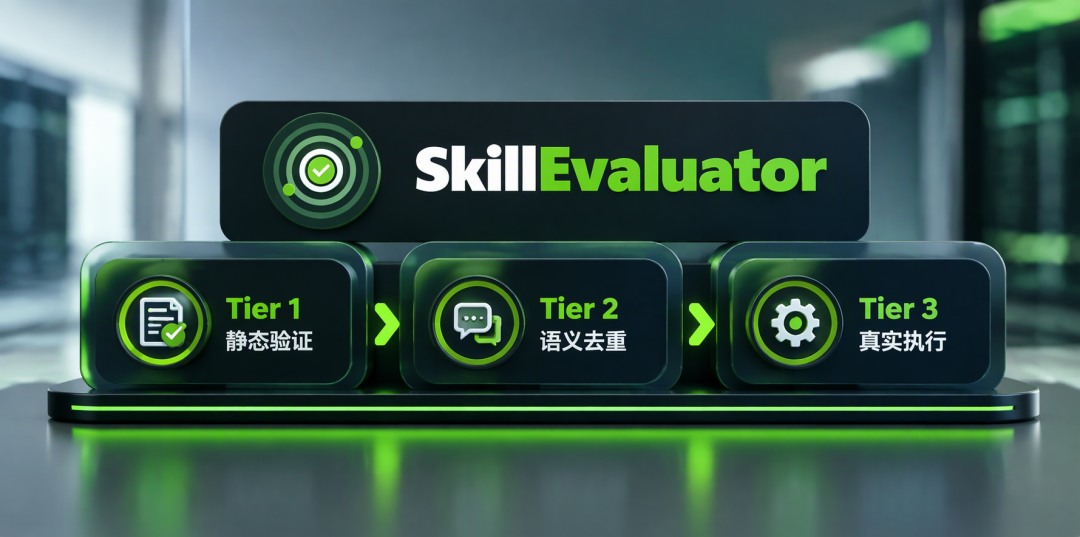
SkillEvaluator 把评测拆成三层,从不要钱的静态检查一路排到要烧 token 的真实执行。微博
Tier1 静态验证:查结构、指令质量、脚本安全、敏感信息、许可证。不调模型,秒级出结果。
Tier2 语义去重:查一个 Skill 内部、以及多个 Skill 之间的功能重叠。刚上手最容易堆十来条意思重复的规则,篇幅涨了,注意力被摊平,模型反而挑不出该执行哪条。
Tier3 真实执行:沙箱里带 Skill、不带 Skill 各跑一遍算差值。要 key、要沙箱、要烧 token。
顺序不用纠结:新写的先过 Tier1,改老的看 Tier2,要判断这包东西该不该留,才轮到 Tier3。
一个下午,自己给自己算一次
不必等 Tier3。二十个任务,从最近两周真跑过的活里挑,别从"我希望能做的事"里挑。固定模型和外壳全程不动,评分标准在跑之前定死。第一批不带 Skill 全跑完,清上下文,再起第二批,逐条减。
有人真这么干过:两个下午,头一个搭环境写评分脚本,第二个跑四十次,纯跑三个半小时。返工最狠的是评分那步,一条任务改了三版判准。门槛不在算力,在你肯不肯花一天把尺子定死。
三个坑。任务挑太简单,基线全在 9、10 分,差值全 0,你会误判成"没用";挑完全做不出的,两组都 0,同样学不到东西——该找"基线能做一半、做完你不敢签字"那一档。评分别靠感觉,"读起来更清楚了"这种判词,你隔一周自己都复现不了,能用退出码和单测通过数就别用形容词。样本别太小,五组差值 +3、+1、-2、0、+2 什么都读不出来,二十组只够看方向;除非差值普遍为负,那种可以直接删。
这套办法不新鲜。Anthropic 官方的 skill-creator 里就写着"对比测试":给 2-3 个用例,有技能和没技能各跑一遍。官方自己都不信"感觉好用"。知乎
它还会过期
11 月 11 日,纽卡斯尔、曼彻斯特等八所学校在 arXiv 发了《Prior-as-Skill》:把操作流程喂给 Agent,短上下文准确率从 51.1% 涨到 69.1%;但同一批题里,画面明确跟常规顺序对着干时,准确率从 98.3% 掉到 83.8%。训练步数拉到 5 倍,这条曲线还在那儿。知乎
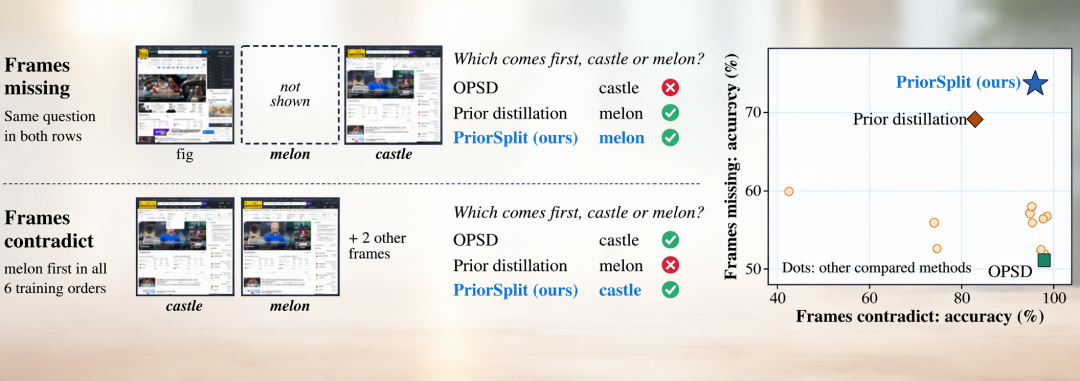
论文管这叫"先验渗血"——背进去的旧流程渗出来,把眼前的证据盖住了。页面改版、口径调整、模型换代,三个月前那份写得漂亮的 Skill 可能早就不涨分了,而你不去查就永远不知道。
所以下次再刷到"装完直接开挂",先别急着收藏。就问一句:这个数,是跟谁比出来的?
当前文章无评论,是时候发表评论了