







96
45
AI 视频白模是什么?PixTV 用白模精准控制运镜
2026-11-04 18:05:20
0点赞
0收藏
0评论
玩 AI 视频的人,迟早都会遇到同一个问题:提示词写得越来越长,抽卡抽得越来越多。
"镜头从人物左侧缓缓环绕到身后,背景是黄昏的城堡,男主回头看向女主……"—— 你觉得自己写得很清楚,AI 却可能在 5 秒里让男女主互换三次位置,城堡时有时无,环绕变成了原地鬼畜。
问题不在 AI 笨,而在文字描述空间关系,天然就是模糊的。
"左边" 是哪边?"缓缓" 是多快?"环绕" 的半径是多少?机位在什么高度?这些话你说得明白,AI 理解不了。
影视行业早就遇到过这个问题,并且有标准答案:Previs(预演)—— 正式拍摄之前,先用低精度模型把镜头排一遍:机位在哪、人物怎么站、镜头怎么走,全部先演一遍。好莱坞大片都是这么拍的。
现在,这个流程被 PixTV 搬到了网页里,而且不需要你学任何 3D 软件。
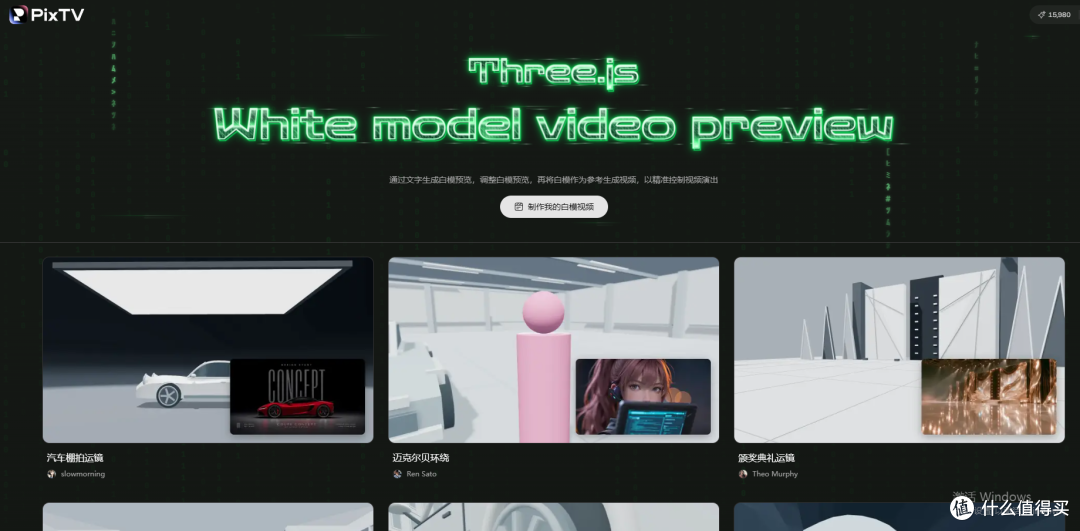
PixTV 白模预演:用文字生成白模,让 AI 照着拍
PixTV 新上线的 3D Previs 功能,逻辑很简单,三句话讲完:
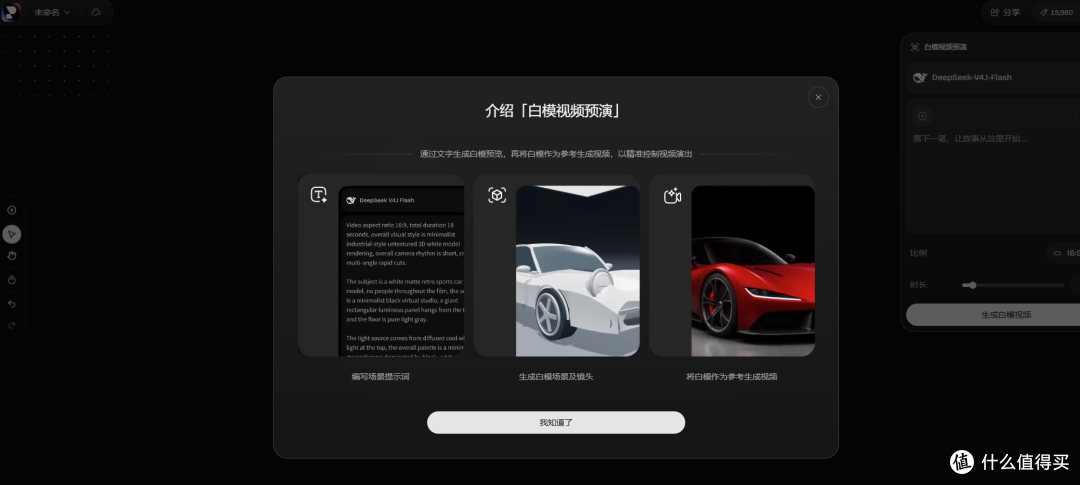
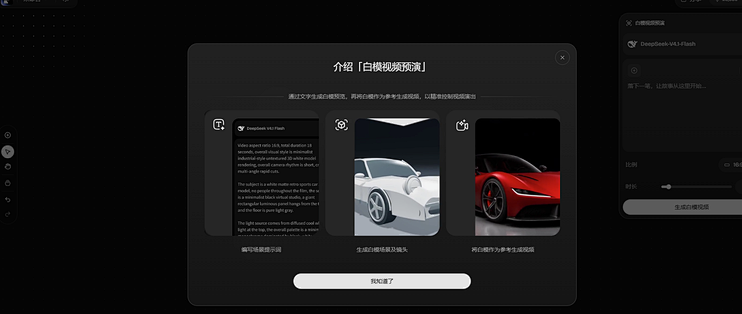
第一步,用文字生成白模预览。 你把 "什么场景、什么机位、什么运镜" 用文字描述出来,系统基于 Three.js 代码生成一版白模动画 —— 纯色、无纹理、只有结构,像施工图一样清晰。
第二步,调整白模。 觉得机位不对、站位不合理、运镜太快,直接在白模上改。改的是 "拍摄方案",不用重新抽卡。
第三步,白模作为参考生成视频。 把白模交给 AI 视频模型,让模型照着这套结构渲染最终画面。人物位置、空间关系、镜头运动,都以白模为准。
一句话概括:先用白模把镜头 "拍一遍",再让 AI 照着生成。
它解决的是 AI 视频最烧钱的问题
AI 视频真正烧钱的,不是第一次生成,而是无效抽卡——AI 根本没理解你想怎么拍,你只能一遍遍重抽,预算全浪费在 "听懂人话" 上。
白模就是那个 "让 AI 听懂人话" 的中间层:
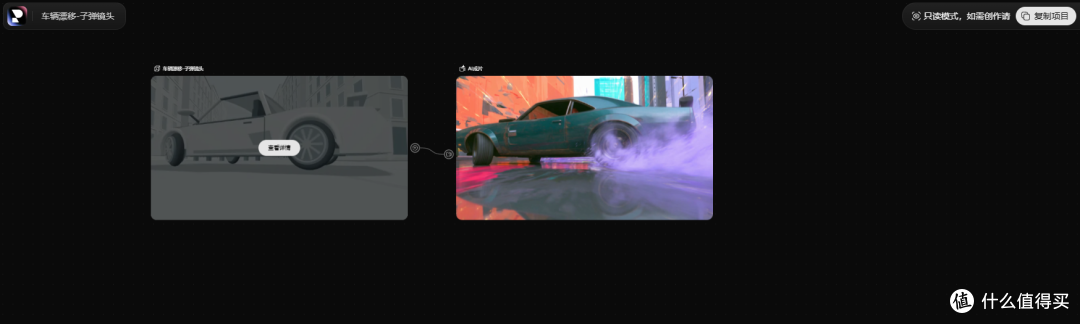
复杂运镜有谱了。 希区柯克变焦、迈克尔贝环绕、子弹镜头、穿越机追车…… 这类镜头以前全凭运气,现在先在白模里把运动轨迹定死,AI 再离谱也不会跑出这条线。
空间关系不乱套。 双人对话、打斗、追逐戏里最常见的穿帮 —— 人物突然左右互换、桌子凭空消失 —— 根源就是没锁定空间。白模把站位、朝向、间隔全部写死,场景结构就不会再乱变。
连续剧情接得上。 上一镜男主在左、女主在右,下一镜全对调?用同一版白模做参考,分镜之间的空间关系是连续的。
页面上已经有几十个示例可以直接试:汽车棚拍运镜、颁奖典礼运镜、跳伞运镜、车辆漂移 - 子弹镜头、长廊侧向跟拍、穿越机追车…… 从名字就能看出来,全是以前只能靠运气、现在能靠规划的镜头。
哪些人最该用
做 AI 短剧、连续剧情的人:人物站位和空间连续性是你最大的痛点,白模正好治这个;
做广告、产品片的创作者:汽车环绕、产品展示这类镜头对运镜要求极高,先白模后生成,效率翻倍;
被 "抽卡" 抽到怀疑人生的人:把时间从 "反复重抽" 挪到 "一次排好",才是省钱的思路。
两句实话
白模管空间和运动,不管画风。 最终画面的质感、光影、风格,仍然由 AI 模型决定 —— 白模负责的是 "演得准",不是 "长得好"。
它适合有规划的创作。 如果你只是随手生个几秒的氛围片段,直接写提示词就行;当你要做多镜头、多角色的完整内容时,白模预演的价值才会完全体现出来。
AI 视频,正在从 "生成" 走向 "导演"
前两年大家玩 AI 视频,像开盲盒 —— 写句提示词,看 AI 心情。
现在的变化是:工具开始给创作者 "导演权" 了。 镜头怎么走、人物怎么站、场景怎么摆,创作者说了算,AI 负责把方案变成画面。
PixTV 的 3D Previs 就是往这个方向走的一步。入口在这:https://www.pixtv.art/zh-CN/3d-previs
如果你手头有一段一直抽不到理想运镜的内容,试试先给它排一版白模。你会发现,"拍" 和 "赌" 完全是两回事。