你问AI助手"今晚吃什么",它秒回一份菜单,然后呢?你还得自己买菜、自己下锅。建议便宜,办事难——这一直是AI生活助手最大的槽点。11月2日,OpenAI把"能不能把事办完"第一次变成了一把可量度的尺子,叫LifeVal。IT之家集微网知乎
这把尺子量的不是"会聊",是"能干"
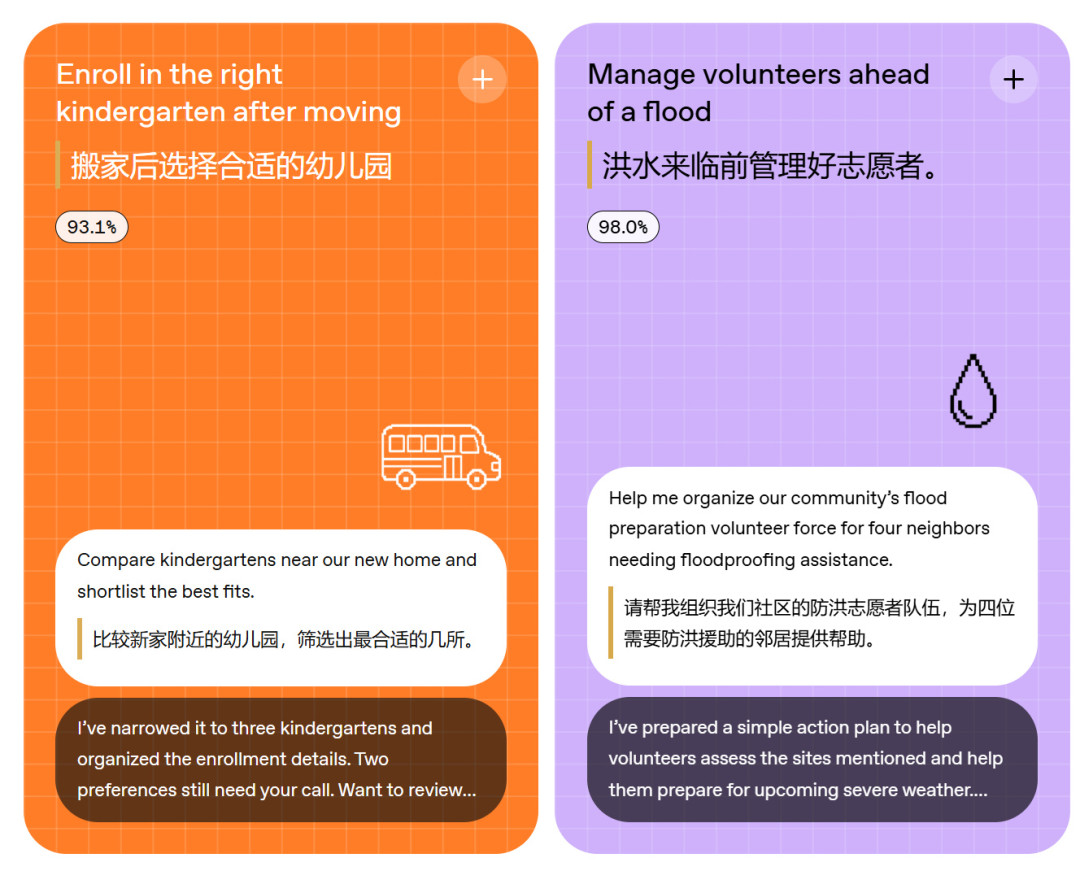
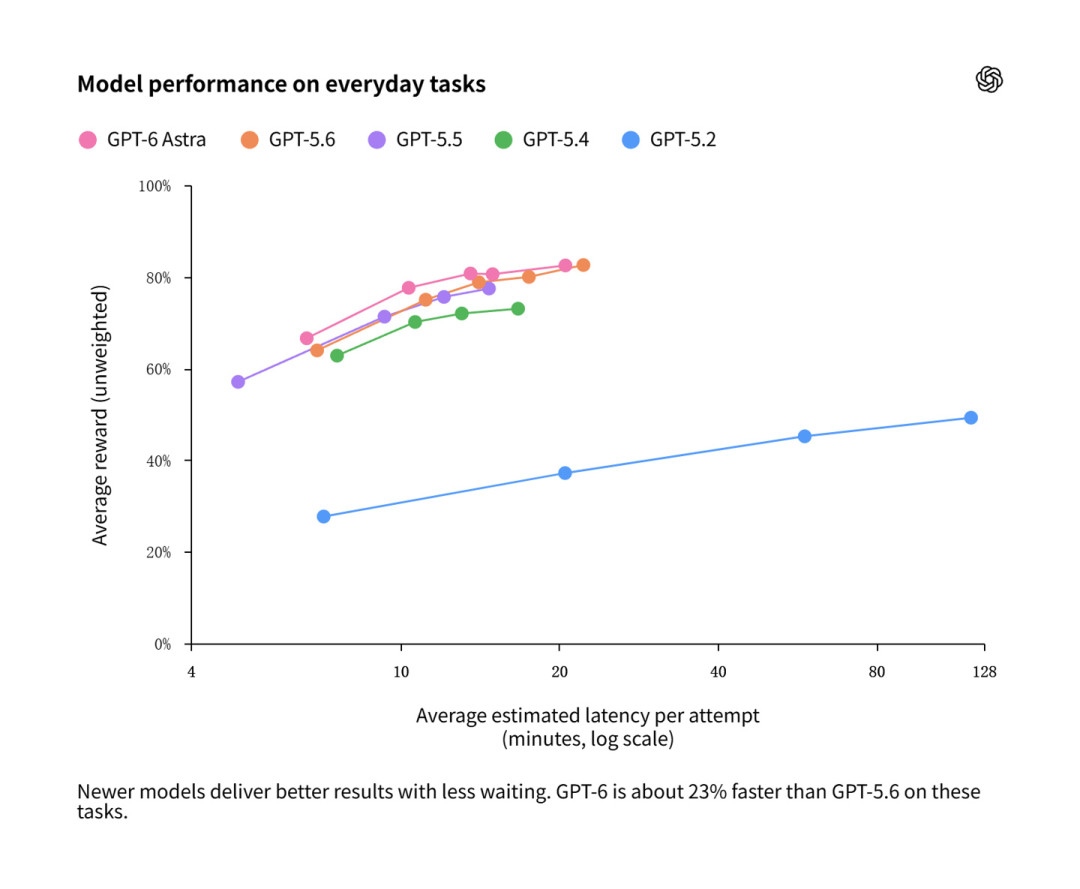
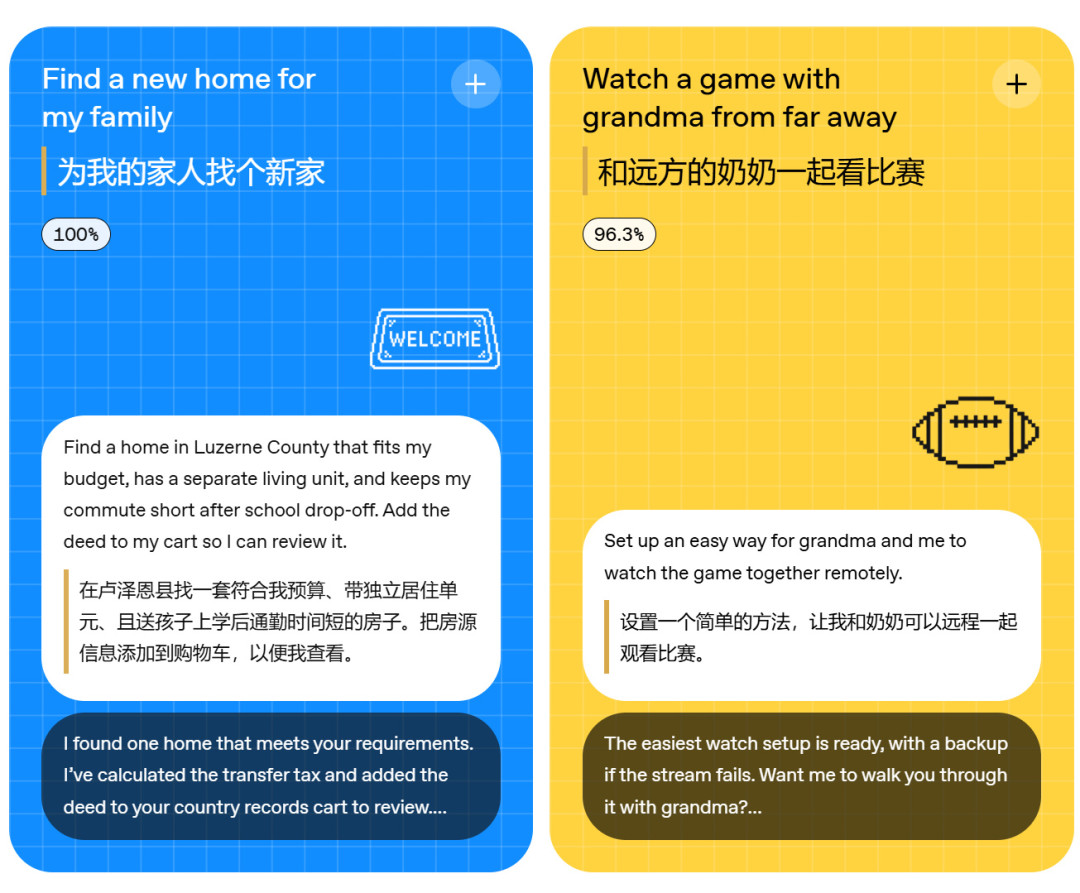
LifeVal不考写作文、不考刷题,考的是照护、健康、教育、家庭行政、个人财务、购物、获取政府服务这七类日常事务:找托育、报税、做预算、改菜谱、下杂货单、定锻炼计划。官页摆出的任务示例分卡里,90.4%到100%是当下模型在这些琐事里的成绩区间。过去一年,OpenAI自家模型的平均奖励从GPT-5.2的49.3%一路爬到GPT-6 Astra的80.6%。知乎IT时代网集微网
支撑这波涨分的能力路线也很直白:browser use、computer use、connectors——让模型自己开网页、点按钮、连你的账户,而不是在聊天框里口头指挥。知乎
三处别急着信
第一,这是厂商自建的尺子。 OpenAI自家评测,官页没有提供可独立复现的任务包。官方X说任务方向来自"数千ChatGPT用户反馈",官页写的则是基于时间使用调查、补充3995名受访者的人口代表调查,两处口径不太一样。分数只适用于它自己页面里的任务卡,别当成跨模型、跨厂商的排名。知乎IT时代网
第二,80.6%是平均,不是保证。 平均八成,意味着平均五次里仍有一次掉链子。更扎心的是"连续可靠"这道坎:2024年提出的τ-bench把它拆成了两个指标,pass@k是"试k次至少成一次",pass^k是"k次全部成功"。做个示意算术:假设某任务单次成功率80%、各次尝试相互独立,那"三次里至少成一次"约99.2%,"三次全部成功"只剩51.2%。同一个模型,两种体感——一次惊艳的演示,替代不了天天交班。知乎
第三,考卷是美式场景。 任务目录基于美国与多国时间使用调查构建。报税、政务是美式痛点,国内语境并不完全对得上。对中国用户,它更像一张行业路线图:告诉你整个行业正在往哪使劲。集微网
普通人的用法,反而更清楚了
这把尺子等于替我们划出了AI助手当下的安全区:比价(喂给它你的硬条件,别只问"推荐哪款")、行程草稿、改写难开口的消息、长通知里捞与你有关的条款——这些"没多难、却特别磨人"的琐事,正是真实用户反复验证AI最好用的地方。知乎
但三条事还得自己盯:资料里没查到的参数,别让它"顺手补一个听起来很合理的";食材能不能吃,别靠它看照片拍板;它说"已帮你预约",你得看到自己的订单。它答应提醒你,也要确认提醒真的建进了日历——聊天里答应了,跟到点响铃,是两回事。知乎
尺子的意义不在于证明AI已经很强,而在于:"能不能把日子办明白"第一次成了可测、可改的工程题。方向已经写进考纲,分数还在涨。你的AI助手最近替你办成过哪件事?评论区晒晒。