让AI查个东西,它沉默两秒,你八成以为它掉线了——这是语音AI被吐槽了三年的老毛病。过去一周,厂商们的说法突然变了:从9月15日开始,"边想边说、后台办事、随时打断"成了语音模型发布会上的统一话术。
先把时间线摆清楚,因为这轮密集程度属实少见:
9月15日,谷歌同天发布 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款实时对话模型;还是这天,阶跃星辰一次上线 StepAudio3 系列五款(Realtime、ASR、TTS、Gen、Music),全部接入自家开放平台。一天之内,7款语音新模型。知乎微博
9月16日,vivo 发布蓝心大模型矩阵,语音大模型和3B端侧模型一起亮相。
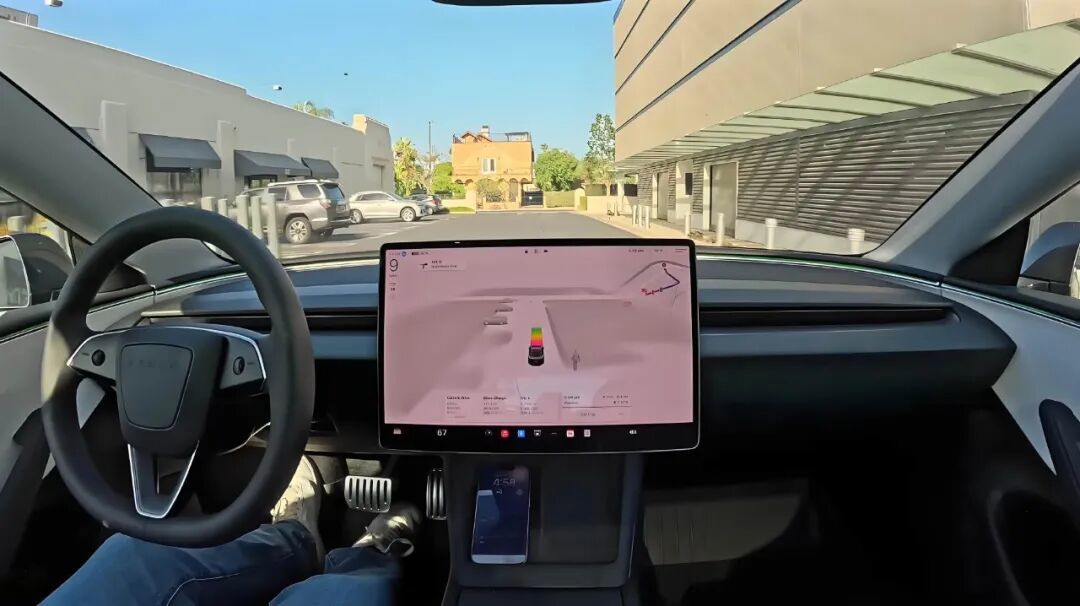
9月18日,特斯拉推送 2026.26.200.11 软件更新,为更多车型上线豆包大模型语音助手,还支持夜间自动安装。知乎
微博、知乎、B站的相关讨论两天内集中冒出来,机构闭门会的标题甚至喊到了"从多模态到全模态,大模型如何获得现实世界接口"。但如果你因此得出"AI语音已经等于真人通话",我建议先把这篇的三笔账对完——哪些体验门槛这轮真过了,哪些还根本没摸到门。
三个体验门槛:这次过的是哪两个
拿"对讲机式语音AI"当基线,人话交流至少有三道门槛:
不用等它说完——你能插嘴,它能停;你说"嗯"“对”,它不会误以为你要抢话。
不用干等结果——它要查资料、调工具时,是一边说一边算,而不是死机式静默。
不用只靠嘴——对话里能接住你递过去的画面:菜单、图纸、手写草稿,边看边聊。
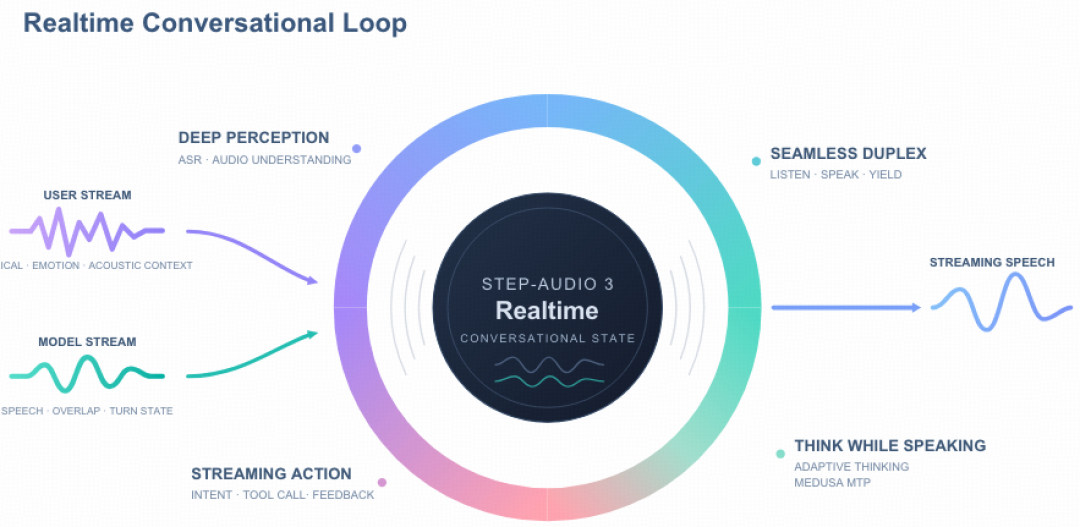
这轮发布里,第二道门槛是实质突破。谷歌 Extended Thinking 版本的核心卖点是"后台规划+语音进度播报":多步任务执行时同步告诉你进度,检索、调用工具在后台并行跑,对话不断。OpenAI 更早在 GPT-Realtime-2(今年5月)上就用过同款思路——所谓"前导语"机制:模型要先说一句"让我查一下",同时并行发起多个工具调用。阶跃走得更极端:官方论文把"边想边说"做成双脑并发——Formulation Brain 在后台生成私有推理链,Articulation Brain 不等推理收尾,靠当前已有的部分结果一段一段往外说。三家在不同产品里做出同一个设计,说明"用语音填充等待时间"已经从各家秘密变成行业共识。更有意思的是论文附赠的一个反常识数据:强制模型"不思考直接说",在忠实度类话题上只比完整思考低1.72分,但在推理类话题上差距拉到11.37分——也就是说,日常对话里大多数话轮根本轮不到深度推理,系统最终只在51.5%到82.0%的话轮上才真的调显式推理。“边想边说"的第一层含义,其实是"该不想的时候别装想”。知乎知乎
第三道门槛也在标配化:Gemini 3.8 Live 支持近实时视觉输入,边打电话边看懂你展示的画面,同时覆盖97种语言。知乎
第一道门槛——也是用户感知最强的一道——恰恰是这轮最没过关的。 这就要说到那个反常识的事实。
四拨"全球第一",对完榜单只剩一句话
各家通稿里的成绩单长这样:
模型 | 榜单 | 成绩 | 出处 |
|---|---|---|---|
Gemini 3.8 Live Extended Thinking | Artificial Analysis 语音对语音质量指数 | 82.6,第一 | 第三方榜单 |
OpenAI GPT-Live-1 Astra | 同上 | 81.5% | 同上 |
xAI Grok Voice Think Fast 2.0 | 同上 | 81.3% | 同上 |
GPT-Realtime-2 | Audio MultiChallenge | 平均通过率48.45%,第一 | 第三方评测 |
Gemini-3.1-flash-live-preview(Thinking) | 同上 | 36.06% | 同上 |
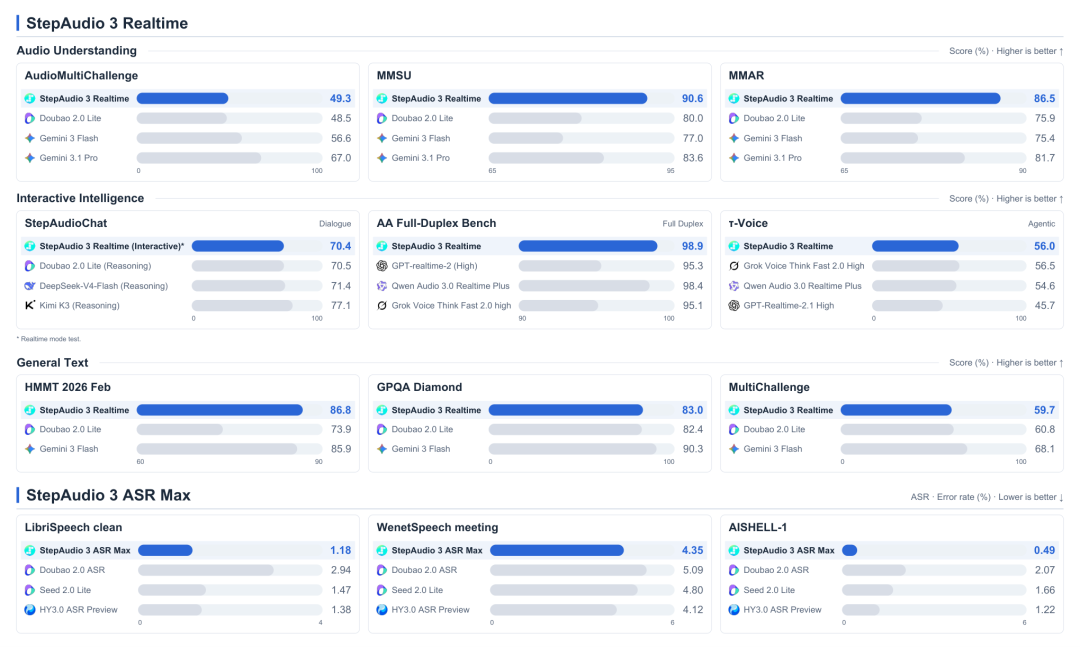
StepAudio3 Realtime | Conversational Dynamics / Speech Reasoning | 98.9% / 99.7%,均第一 | Artificial Analysis(官方发布口径) |
StepAudio3 ASR | 非流式语音识别准确性 | WER 1.7%,并列第一 | 同上 |
三个值得细品的地方:
头部差距不足1.5分。语音质量指数上前三名挤在一起,"第一"和"第三"在体感上大概率分不出高下。知乎
换一张考卷,第一就换人。质量指数谷歌登顶,Audio MultiChallenge(考多轮复杂任务)却是 OpenAI 48.45% 对谷歌36.06%的差距——注意后一项还是上一代 preview 模型的成绩——不同测试项目之间的排名差异,说明"谁是第一"取决于考什么题。“谁是第一"取决于"考什么题”。
同一家发布,通稿和转发先打架。阶跃发布当天,有微博转发称"Realtime在两个榜单全球第一、ASR词错率1.7%“,次日另一帖改成"ASR和TTS拿下全球第一”。对完官方发布物料,真实口径是:Artificial Analysis 的 Conversational Dynamics 98.9% 和 Speech Reasoning 99.7% 两项 Realtime 排全球第一,非流式 ASR 词错率1.7%是"并列"第一。注意这三项全在语音交互类子榜——谷歌82.6那个是语音对语音质量指数,又是另一张卷子。每家的"全球第一"都指的是不同子榜,看榜单不分子榜,等于没看。华军软件园
真正的分水岭:“边想边说"不等于"能抢能让”
9月15日那场在B站被搬运的演讲里,语音模型公司 Gradium 的创始人 Neil Zeghidour 给了个很扎心的数字:人和人打电话,约20%的时间是双方同时在说话的;而今天所有出货的实时语音模型,都是半双工——要么在听、要么在说,永远不能同时。这就是"对讲机"说法的来源。哔哩哔哩
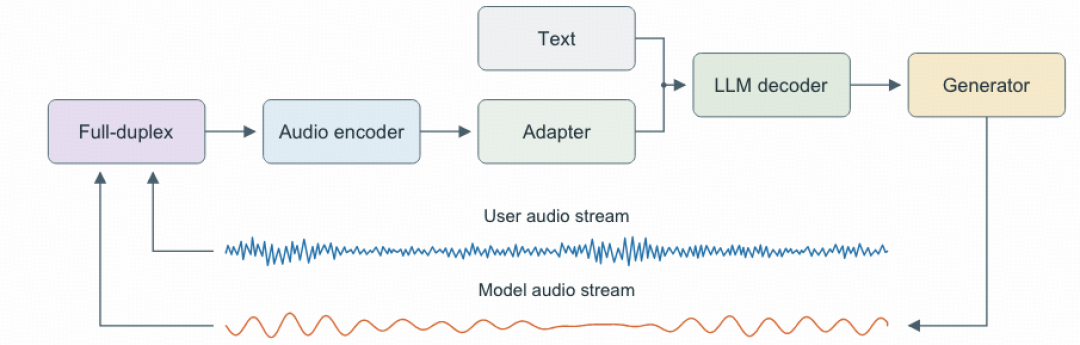
为什么难?他把账算给你看:8个词说出来约3秒,按24kHz采样是72000个时间步,注意力机制的计算量随序列长度平方增长——直接把原始音频塞进大模型,成本天文数字。Neural codec 把声波压成 token 才让这件事变得可学;而"全双工"还要再进一步:同时建模两条 token 流,让双方都能发声、静默、重叠。更麻烦的是话轮判断——用户一句"right",可能是认可你刚说的解释,也可能是纠正你上一句的开头,离开对话上下文,光看波形或光看转写都消不了歧。阶跃论文里管这叫 backchannel 误判:你的"嗯嗯"很可能被当成抢话,AI 就闭嘴了。哔哩哔哩
这轮发布里最接近"真全双工"的,是阶跃公开的架构设计:把音频切成320毫秒的时序块,系统同时接收用户语音流和模型自己的音频流,它说出来的话会回流进自己的耳朵,成为理解你插话的上下文条件;官方还晒出了超过10000小时的合成全双工交互数据,专门训练"句内停顿还是说完了、'嗯’是捧场还是要抢话"这四组判断。这是论文自述,产品实测成色还得等第三方数据。而谷歌和 OpenAI 的"边想边说",严格说解决的是"等待静默",不是"同时说话"。Zeghidour 还点了另一层残酷现实:固定参数预算下,听说能力和推理能力是零和博弈——语音模型的"自然"和"聪明"目前很难同时拉满。所以他给行业指了两条路:要么暴力 scaling 端到端语音模型,要么学 Moshi+RAG 混合架构,轻量全双工接口管聊天,复杂推理和工具调用异步外包给后台文本大模型。知乎哔哩哔哩
一句话总结这代产品的真实位置:嘴上的静默解决了,话轮的重叠还没解决;但两件事在不同玩家手里,确实不是同一个承诺。 看到"全双工"三个字,先分清它说的是哪种。
普通人现在能白嫖什么:入口分三档
第一档,现在就试:手机上的 Gemini app 和 Search Live,Extended Thinking 的"边想边说+报进度"是消费端直接可用的,97种语言、对话中可打断、可递画面;注意一个细节——模型生成的所有语音内容会自动带AI水印用于溯源,这是谷歌这轮发布里容易被忽略的合规设计。国内用户按各家app实际推送范围为准。知乎
第二档,看你手上有什么设备:特斯拉车主,9月18日这版 OTA 之后豆包语音助手覆盖更多车型,车机这个"双手被占用"的场景本来就是语音交互的真实考场;更猛的是9月17日豆包与火山引擎联合发布"豆包座舱助手",直接宣布与上汽合作、首款车型荣威家越07开启预售,官方卖点里白纸黑字写着"全双工对话,随时打断、随时追问,还能主动接话找话题"——车厂开始拿"打断让话"当核心卖点,恰好印证这道门槛的分量。手机侧,豆包系(9月16日发布的努比亚 NaviX Ultra 直接预装了豆包手机助手)走的是系统级语音入口,端侧还有 vivo 蓝心这类选项,弱网和隐私敏感场景更从容。TMT星球微博
第三档,两个坑先标记:一是 Claude 语音模式今年7月虽然扩到了 Opus/Sonnet 全系列、能语音调用 Gmail/日历/Slack,但支持语言目前11种、不含中文——英文工作流用户狂喜,中文用户再等。 二是各家"全球第一"的子榜口径混乱,选型前先想清楚自己考的是哪张卷子:日常闲聊看语音质量指数,多步任务看 MultiChallenge 类基准,中文识别自己去对词错率。想先体验阶跃这套的,官方给了三个入口:语音体验中心在线试、开放平台接 API、Realtime 用 WebSocket 长连接调用。知乎
要做语音Agent的开发者:上线前先测这三件事
企业侧数据看着很热:有报道称语音AI已接管近两成来电,而企业真正的短板不在模型层。市场研究机构 Astute Analytica 估全球语音Agent市场从2025年约30亿美元涨到2035年451亿美元(CAGR 31.1%),Gartner 甚至预测对话式AI今年会给全球联络中心省下800亿美元人力成本。但别忘了阶跃自己的成绩单:语音智能体任务成功率 56.0%——榜单第一的模型,“办成事"也就刚过半。谷歌新模型通稿里那句"行业洗牌在’好用’与’能用’之间展开”,翻译过来就是上下文管理、工具调用可靠性、多语言覆盖和成本结构这四件事,榜单不考、发布会不讲,全在落地时见真章。知乎知乎知乎
所以接新模型之前,拿这三个动作做验收,比跑分管用:
插一句"嗯"——看它是把话头让回来还是直接闭麦(backchannel 误判现形);
任务跑到一半改需求——看异步工具执行会不会把新指令吞掉;
断网/弱网——端侧兜底是蓝心这类3B小模型的主场,纯云方案这里最容易露馅。
选路线就是选上面那道"零和题"的答案:端到端scaling赌下一代模型,接口-智能分离的混合架构赌工程确定性。没有标准答案,但你至少要知道自己在赌什么。
接下来盯这几个信号
真全双工何时产品化:阶跃的双流架构目前只有论文自述,第三方实测重叠对话表现才是成色判据;
各家子榜成绩复核:Artificial Analysis 更新后,对号入座看"全球第一"能不能续上;
中文覆盖补课:Claude 语音11种语言里何时加中文;
车机与端侧的节奏:特斯拉这次是"更多车型上线",下一步看语音助手能不能和车辆控制权限打通——8月接入时双方口径都是豆包只管"嘴和耳朵",不碰驾驶。
这轮语音模型潮,把"边想边说"从演示视频变成了可用功能,也把"随时打断"的营销话术和真实能力差距赤裸裸摆上了台面。对普通用户,值得现在就去试试新版语音对话,但别拿它跟真人通话较真;对开发者,验收清单比发布会PPT值钱。AI 拿到"现实世界接口"的路上,嘴确实张开了,耳朵还没完全长好——先看清这条缝,再决定把你的麦克风交给谁。