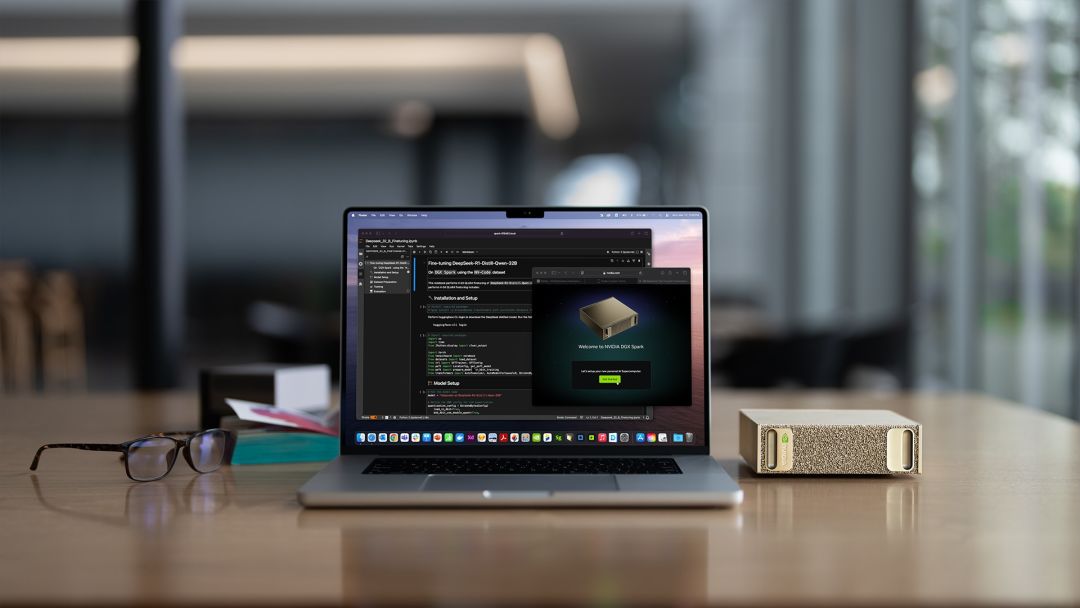
9月10日,英伟达和华硕联合办的第三届DGX Spark黑客松宣布名额接近报满。差不多同一时间,一个月前3.4万入手Spark的朋友发帖:短短一个多月,它涨了快20%,“又一个理财产品"的说法重新流行。评论区两边吵得很:一边喊"端侧AGI时代来了”,一边是竞赛文章下面14个赞的最高评论——“普通人拥有?😭”知乎知乎
大家想上的车不是盒子,是9月中旬开源权重的DeepSeek-V4.1-Flash:约552B的主干参数,还带着巨大的Engram记忆表,两张查找表总规模超过200GB,整个模型文件约510GB。这是第一次,一个带视觉、带工具调用、接近前沿闭源能力的开放权重模型,理论上站在"一套桌面设备够得着"的门槛上。但这场社区竞赛算到最后是个数学题:四条路线的实测速度差了一千倍不止,而3万块在不同路线上买到的完全是不同的东西。我把实测帖、仓库数据、厂商白皮书和涨价行情全拉了一遍,先算账,再谈上车。知乎
一、先核对速度的账:23秒和94个token,都是同一个模型
最朴素的买盒子裸跑,这周传开的中字视频是海外实测23秒一个token。不用怀疑设备坏了,这是"能点亮"的真实体验价;随后社区仓库用SSD流式把它优化到2.7 tok/s左右——中间一百倍的差距,吃的全是工程。单台128GB的Spark装不下510GB的模型文件,跑出可用速度目前只有两条社区路线,而且都带隐藏账单。哔哩哔哩知乎
方案一保全部专家:在统一内存里建Expert Arena,按校准语料的统计把高频专家先驻,其余留在NVMe按需换入,3926个槽位记录到约83%的专家命中率,decode约2.7 tok/s,而一次2048-token的prefill还要7.2GB临时空间——适合离线验证和质量对照,不适合日常对话。方案二反过来,接受"这个模型不是原版":让每层约36%到40%的专家常驻统一内存,decode阶段命中100%,速度想上到十几甚至几十tok/s;代价是模型在稀有token和子词边界上开始出错,例如把函数名写错。想要快的模型,和想要满血的模型,在128GB上二选一。知乎
真正被压测验证"能打"的路线是集群:四台Spark、200G RoCE、TP4加DCP4,不删权重,只把每台约47.2GiB的Engram表放到本地NVMe、和GPU计算重叠。这套配置的单流速度按任务类型在31—94 tok/s之间波动:计数类90—94、表格约88、数学约81、代码约64—78,普通散文只有31—35;差异主要来自DSpark推测解码的接受率,代码、表格一次可能接受5—6个草稿token,自然语言通常只接受约2个。六个任务并发聚合吞吐185 tok/s,540个混合请求压测下来0错误、0挂起、0输出检查失败。所以"94 tok/s"和"31 tok/s"是同一台集群,任何只报一个tok/s的数字,先问它跑的是什么任务。知乎
还有第四条路:Mac统一内存。Redis作者antirez没有继续做通用框架,而是写了专用引擎DwarfStar(DS4),用2-bit/8-bit不对称混合量化把DeepSeek V4家族塞进96GB以上的Mac,内存不够再SSD流式,两台128GB还能RDMA张量并行。但注意时间差:截至目前DS4公开README明确列出的主要适配对象仍是DeepSeek V4 Flash、实验性Vision和V4 Pro,V4.1还要再等等。知乎
二、再核对钱的账:3万是门票,13万起步才是那台"能用的"
涨价把决策变得更难受:入手价3.4W、现在奔着4W去的只是Spark,这轮整个行情都在疯,“我的A4000,京东7000买的,现在20000+了”,“6000 PRO 从7万涨到18万了”。四台Spark光机器就是13万到16万,还没算200G RoCE的网络设备;三万预算在这条路线上连点亮资格都要打问号。B站三万预算选题的视频下,最热的一条评论就是一句反问,问3万块到底能不能买到——3万你能买到m5 ultra的mac studio。知乎哔哩哔哩
厂商白皮书是另一种叙事:按它的显存需求矩阵,FP8约330 GB、INT4约175 GB,顺便告诉你单张4090"基本无望——FP16下单张4090连7B参数模型都喂不饱"。这句倒不是吹牛——510GB的权重文件对24GB显存不是够不够的问题,而是根本不在一个数量级。但白皮书本质是给企业采购的话术,个人玩家的真实档位就是上面那四条路。二手党会提"双路x99八卡2080Ti"的梗,社区真有人8张22G拼出176G跑GLM-5.3-Flash,短文本30 tok/s、33K长文解码18 tok/s——注意,那是GLM,想跑这尊552B的DeepSeek,老卡池同样塞不进。知乎哔哩哔哩
另外,被营销吹成"端侧AGI"的AMD 395小主机(128GB统一内存),实测跑的是Qwen3.8-Flash-Next的量化版:54.5GB权重驻内存、38.4GB放在SSD,合计承载约92.9GB的模型才换来21 tok/s的体感速度。机器是真香档,但别让它替V4.1-Flash背书:这台小主机没有资格出现在那510GB的账里。知乎
三、冷的那盆水:不追的人,账也是对的
有一条14个赞的评论说得很直白:DeepSeek v4系列都是不低的权重和极轻的kv,就是给高并发maas服务设计的,自己部署并发上不来纯亏,不如直接api。这条14赞评论戳中了单人流量的本质:十几万的集群摊到单流,对比云API按量计费,回本周期长得没法看。只想要模型干活的人,这轮确实不用动。知乎
但这场竞赛剩下的部分,不是API账单能覆盖的:为只有48个SM的GB10重写top-k路径、抓出那个在短输入完全正常、长prompt一次性prefill却输出无关内容的SM121竞态bug——靠单卡对拍工具一个个输入规模比出来的。这轮开源真正的新闻不是"个人拥有了前沿模型",而是"前沿模型的桌面推理链路第一次被个人一段一段救活"。买盒子的人是先锋,等的人是坐享其成,两样都不丢人,但要清楚自己买的是哪个。知乎
四、四类人的账,拿这页对号入座
3万预算、就想跑V4.1-Flash的:你买到的会是2.7 tok/s的"能跑"或删专家的"快但变笨",不是可用。涨价当口不建议接盘,观察信号是官价回到3.5万以内、二手价跌破入场价——"理财产品"逻辑松动时才是上车点。
小团队、Agent长任务并发的:四Spark集群是目前唯一有0错误压测数据背书的本地路线,但先评估自己能不能伺候200G RoCE,这套东西是机房不是外设。
有96GB以上Mac Studio的:DS4先跑V4家族和GLM 5.3,V4.1适配落地前,你就是"等版本"的人,盯发布页比盯车商便宜。
手上27B单卡够用的:你现在的机器就是日常主力,这轮竞赛是围观素材——Engram-on-SSD方案哪天变成一键部署,再来算要不要换车。
最后留三个继续盯的信号:DS4正式吃进V4.1;专家裁剪路线出现保住质量的公开评测;Spark供货放量、价格跳水。本地部署这行的老规矩没变——权重塞得下只是入场券,跑得快、跑得对、跑得值,是三本不同的账。