一个解压器,跑了很久的模糊测试都没出事。Claude 接手后,团队让它证明:只要输入小于 64MB,这个入口就不会崩。
证到一半,证明推不下去了——程序里真有一条路会崩。触发它,需要一份大约 20MB、布局极其刁钻的文件。而过去的 fuzz,通常把输入卡在 1MB 以内。知乎
这是 Anthropic 10 月 22 日公布的研究:它和 Theorem 合作,让 Claude 给 123 个 OSS-Fuzz 开源库的 239 个测试入口写证明。
几周后,交出了约 1.8 亿行通过机器检查的证明。团队称,这是首次把 AI 形式化验证大规模用到生产级软件的可执行文件层。量子位知乎
先别被“1.8 亿行”吓到。测试和证明的区别,不在数量,在覆盖方式。
模糊测试往程序里扔大量半随机输入,扔得越多,撞上问题的概率越高;但它只能说“这些输入没出事”。
证明要按分支把输入空间盖完:x<0 返回 0,x>100 返回 100,其余返回 x——三条分支合起来,才敢说任意 x 都落在 0 到 100。
这不是让 AI 读一遍源码,然后说“看起来没问题”。
他们先把库连同 ASan 编译成 RISC-V 可执行文件,取出真正要跑的机器码;再用 Theorem 的指令集和 Linux 语义,把“小于 64MB 的输入不崩”变成形式化规格。
Claude 写证明,Rocq 的内核逐步核对。写证明的是模型,盖章的是检查器。
也正因为证明要求覆盖所有输入,它反过来成了找 bug 的工具。证明推不动,往往意味着还有一条会崩的路径。Claude 顺着这些卡点打补丁,再对修完的程序重新生成规格、继续证。
最后挖出几百个 bug,不少是普通 fuzz 很难碰到的:有的要 64MB 输入外加超过 2GB 内存,有的要对同一个文件按特定顺序开两个 handle。
但“形式化验证过”不等于“没 bug”。知乎
这次证明的对象是单线程、静态链接、固定内存预算的 RISC-V 二进制,链的是 musl;多数人实际跑的是 x86 或 ARM,动态链接 glibc。
证明覆盖的是指定入口,不是整个库;ASan 也抓不全所有内存问题;调用方不按约定使用,照样可能把内存写坏。更重要的是,Rocq 只能保证证明符合规格,保证不了规格写对了。
规格漏掉一条关键要求,证明再漂亮也白搭。
成本也还没到“随便用”的地步。单条证明中位数约 60 万行,覆盖的机器码中位数约 1.8 万条指令;10 亿行草稿里只有 1.8 亿行过关。
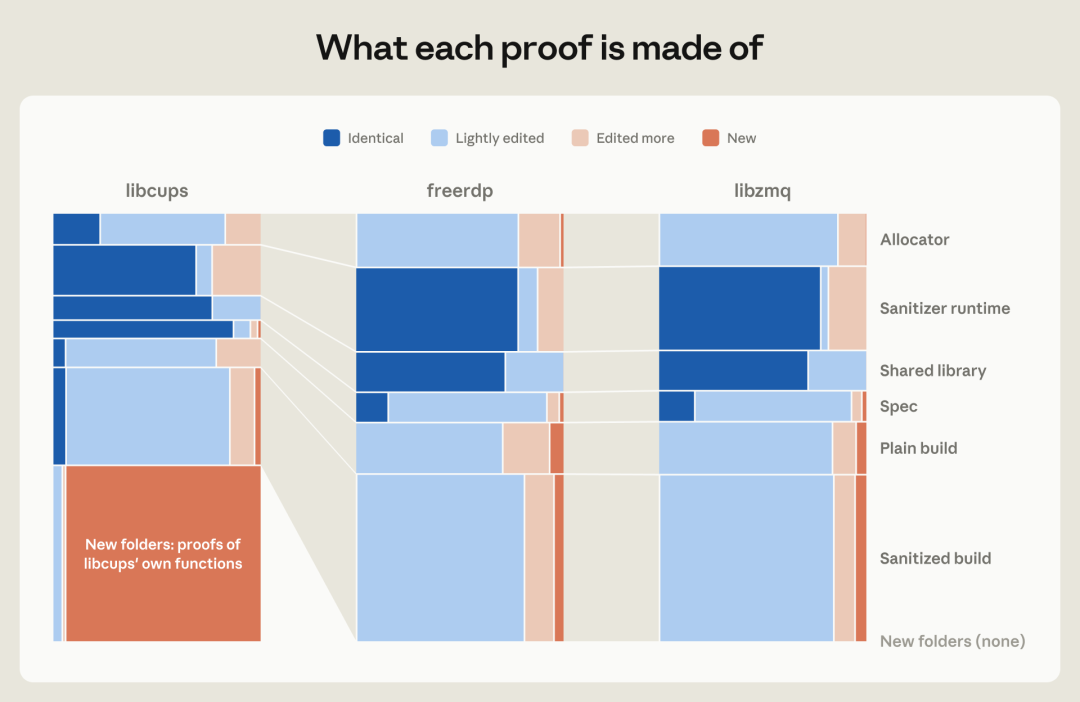
好消息是证明能复用,共享部分让同一组任务少用了 17% 的 token。量子位
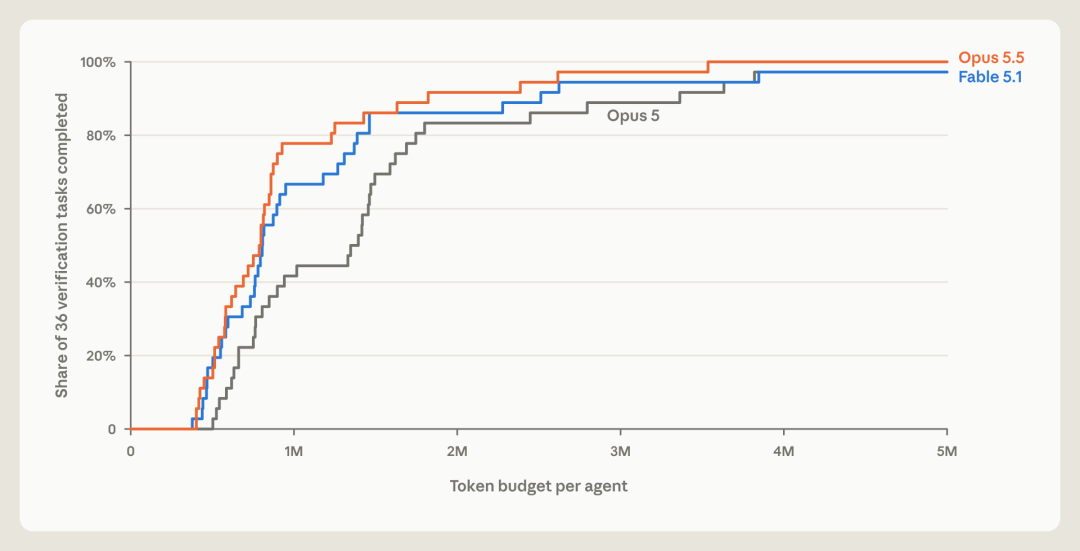
Anthropic 还测了模型升级的收益:完成一半小型验证任务,Opus 5.5 所需的 token 比 Opus 5 少约 40%。
目前公开的是 25 个库、60 个入口的证明,开发者可以下载接着改。它是研究方披露的工程案例,不是独立复现,也不意味着模糊测试可以全部删掉。
这件事真正改变的地方,可能不是“AI 会写证明了”,而是“证明变便宜了”。过去形式化验证是操作系统、编译器、密码库才用得起的手段,得靠少数专家手写规格、拆证明目标。
现在 Claude 能把其中很大一部分重复劳动接过去,普通开源库也开始有机会被验证。
对写代码的人来说,问题也跟着变了。AI 把“写出能跑的代码”变得便宜之后,更稀缺的是说清楚“什么才算对”:这个接口在什么输入范围内、必须满足什么性质、哪些假设可以接受。
编码问题基本解决后,测试、基准、规格说明才是团队更该投入的地方。哔哩哔哩
回到那个 20MB 的解压器输入。它提醒人的不是“AI 又赢了”,而是一个更朴素的事实:没测到的地方,不等于没问题。以前我们只能祈祷它别出事,现在至少可以试着证明它不会。