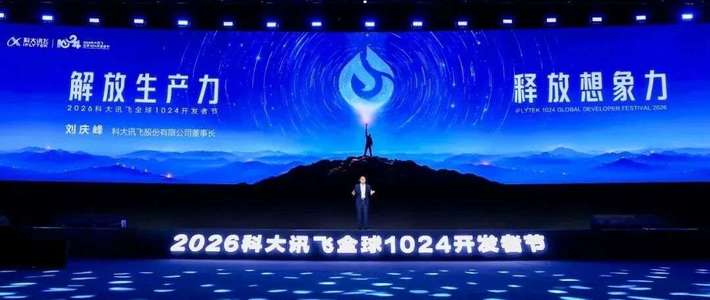
这条热榜话术其实是连续三句话的节选,被省掉的前半句是"承认"。10月22日,2026科大讯飞全球1024开发者节在北京国家会议中心二期启幕,采用北京、合肥双会场联动形式,这也是大会主会场第一次从大本营合肥移到北京。主论坛上,科大讯飞董事长刘庆峰表示,国产算力目前对标全球还有两代左右的差距,但他相信差距很快会缩小到一代、半代,“一定会有并跑甚至领跑的一天”。三句话拆开看,真正需要回答的是三个问题:差两代差的是什么、说领跑的底气从哪来、还差哪些条件。知乎·刘维一知乎·深水财经社微博·腾讯视频科技
"差两代"差在硬件,卡脖子的却是生态
所谓两代,指的是国产芯片与全球领先水平在单卡性能和带宽上的代差,这一点连产业观察都没替他遮掩:N卡的性能和带宽确实比国产GPU要领先很多,用它训练大模型的速度也更快。但刘庆峰在台上说了一句比硬件差距更重的话,“只有星火一家是用全国产算力训练的,其他全是在 N 卡上训练,而且科大讯飞的尺寸是最小的”。他同时点出了差距的另一半:当前国产算力生态中,真正愿意在大模型训练上花力气的企业还不多。没人用卡,生态就无法在使用中迭代——这才是他呼吁更多企业和开发者进场的真正所指。知乎·深水财经社知乎·刘维一微博·文欧价值
"领跑"的依据:用系统工程压缩有效算力差距
承认差距的同一天,他给出的另一组事实是全国产算力训练的星火X2.6。训练侧,通过长程任务动态并行训练技术按序列长度自适应分配算力,以飞星二号万卡集群为例,训练2000B参数、256K长度的数据从4个半月缩到1个多月。推理侧,基于国产集群的自适应存算协同推理与四层KVCache技术,把长程任务推理效率提升了4.5倍。这些数字没有抹掉单芯片的代差,它们指向的是另一种算法:决定实际产出的是有效算力,而工程效率正是差距可以被压缩的地方。知乎·深水财经社知乎·百数朝智网
端云一体:他押注的换道方案
发布会的另一条主线是架构。讯飞为星火X2.6首次推出了端云一体协同架构,让任务按难度、隐私和成本在本地与云端之间分工。刘庆峰给出的目标是:六成应用在本地完成、三成端云协同、剩下的一成交给云端大模型。需要注意,这是发布时给出的目标而非已经落地的现状。但它把"领跑"叙事从拼芯片代际换成了拼落地成本:数据不出设备、推理费用下降,教育、医疗、法律这些最敏感的领域才敢把大模型放进核心流程。知乎·新智元知乎·刘维一
生态的账:开源、迁移与自主可控的门槛
生态这一侧也有可核验的进展。9月1日开源的星火X2.5-4B,下载量已进入全球端侧模型前四。新一代端侧模型星火X2.6-4B则把端侧可完成的智能体任务覆盖度做到了41.9%。而在刘庆峰的标准里,全栈自主可控不止于推理跑在国产卡上,更要能在国产平台上完成训练。按公开报道,讯飞已经从飞星一号集群磨到飞星二号,并把工程经验迁移到寒武纪、海光等多个国产芯片平台。知乎·刘维一知乎·百数朝智网知乎·深水财经社
"领跑"要补的条件,比口号更值得盯
绑定国产路线是一个带条件的承诺:"全国产算力训练"意味着讯飞在算力供给上绑定了国产芯片路线,一旦产能或良率出问题,模型迭代会第一个受到牵连。产业现实同样不允许乐观提前:今明两年国产算力芯片需求支撑仍在,但近期算力卡的供给问题已经压制了部分基础设施需求。同样要留余地的还有两件事:"缩小到一代、半代"没有给出时间表,"唯一全国产训练的主流大模型"是企业口径下的自我陈述。接下来值得盯的,不是那句领跑的口号,而是三个信号:愿不愿意有第二家、第三家用国产卡训练大模型,下一代国产集群的交付节奏,以及X2.6在第三方评测里的真实成绩。知乎·邬话不说知乎·经济观察报