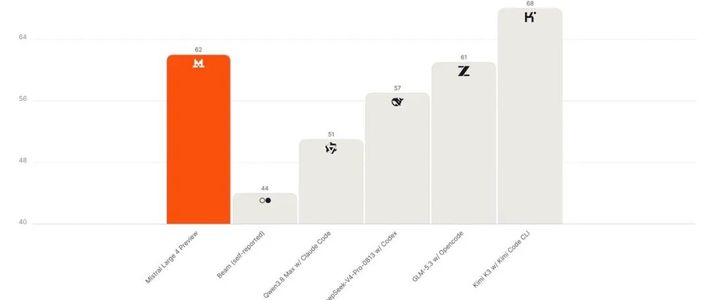
欧洲AI公司对标中国模型,这次最值得看的一句话不在发布稿里,而在模型卡里:这是西方开源最高分,但领先的中国开源模型分数更高。 10 月 29 日,Mistral 把 Large 4 的权重放上 Hugging Face,1.05 万亿总参数、每 token 激活约 520 亿、100 万 token 上下文,原生多模态。 它是在欧洲的数据中心,用约 3800 张 Grace Blackwell 训出来的。知乎微博36氪
第三方榜单也没给面子。Artificial Analysis 智能指数只给 26 分,21 个开放权重模型里排第 9;DeepSeek V4.1 Flash 和 GLM-5.3 都是 32 分,Qwen3.8 Max 34 分。 所以 Mistral 换了一套说法。它强调编码代理指数 48%,与领先的开放权重模型接近,每任务 token 比 GLM-5.3 少 47%;Terminal-Bench 4.0 也从预览版的 28% 升到 41%。 它不再争总分第一,而是争干完同一个活谁更便宜。知乎微博
这套打法的底层,还有一处更少被提及的趋同:Large 4 的注意力部分直接用了 DeepSeek 的 MLA 加稀疏注意力 indexer,自己只加了跨层共享 KV 和 NoPE 层。 换句话说,欧洲旗舰开源模型的注意力骨架,用的是中国团队先走通的那条路。知乎
对普通开发者,第一道门槛不是分数,是硬件。权重仓库约 1.06TB;SGLang 已验证的部署组合是 FP8 8 张 B300,或 NVFP4 4 张 GB300。 按目前的配方,一台 8 卡服务器是团队的起点,不是个人的起点。“开放权重”在这里更像一种企业部署格式,不是免费本地模型。知乎
第二道门槛是许可,而许可不是“随便用”。它是修改版 MIT,下载、自部署、微调、内部使用和不少嵌入具体功能的商业产品都可以;但如果经营模型即服务,要另签许可,也不等同于 OSI 定义的开源。 做个产品通常够用;想转卖 API,这条就是红线。微博
第三道门槛是账单的算法。官方 API 每百万 token 输入 0.70 美元、输出 2.10 美元;按每任务成本算,Large 4 是 2.06 美元,GLM-5.3 是 5.00 美元。 成本数字是官方口径,第三方还没全部复现。但它指出的方向很清楚:长任务里,少 47% 的 token 比多 6 分更能决定账单。只做短问答,26 分和 32 分的差距可能比价格更显眼;跑几小时的编码 Agent,token 效率才是主变量。知乎
那普通开发者到底受什么影响?对多数在国内做应用的开发者,今天最直接的变化接近于零:Mistral 不是默认选项,1TB 权重也装不进你的机器。会传过来的,是两件更慢的事。一是价格竞争多了一个参照系;二是选型方法要改——别只看榜单,拿自己的任务跑一遍,把重试、上下文和人工修正都算进去。
如果你做的是面向欧洲企业的产品,Large 4 值得放进候选:它是少有的、能在欧洲境内完成训练和部署的开放权重模型,采购和合规上更好讲故事。 但欧洲公司自己也不一定买账:德国搜索引擎 Ecosia 转用中国模型后,成本减半、效果更好。36氪微博
所以,这条新闻的重点不是“欧洲超过中国”,而是“欧洲开始用中国开源模型的打法比赛”:开放权重、按任务成本、拼后训练。对普通开发者,这意味着选择更多、价格更低,但“开放”不等于“你能用”。下一次看到万亿参数开源,先问三个问题:我的硬件跑得动吗,许可证允许我这么卖吗,它在我的任务上真的更便宜吗。