这周的迷你主机圈,流行比参数。
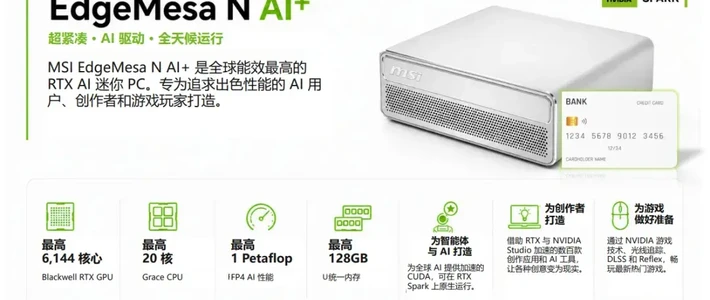
10月9日,极摩客拉着AMD和京东在深圳开发布会,主角EVO-X5 Pro,宣传语最狠的一句:192GB统一内存,本地离线跑3200亿参数大模型。京东当晚开预约,价格46999元。知乎
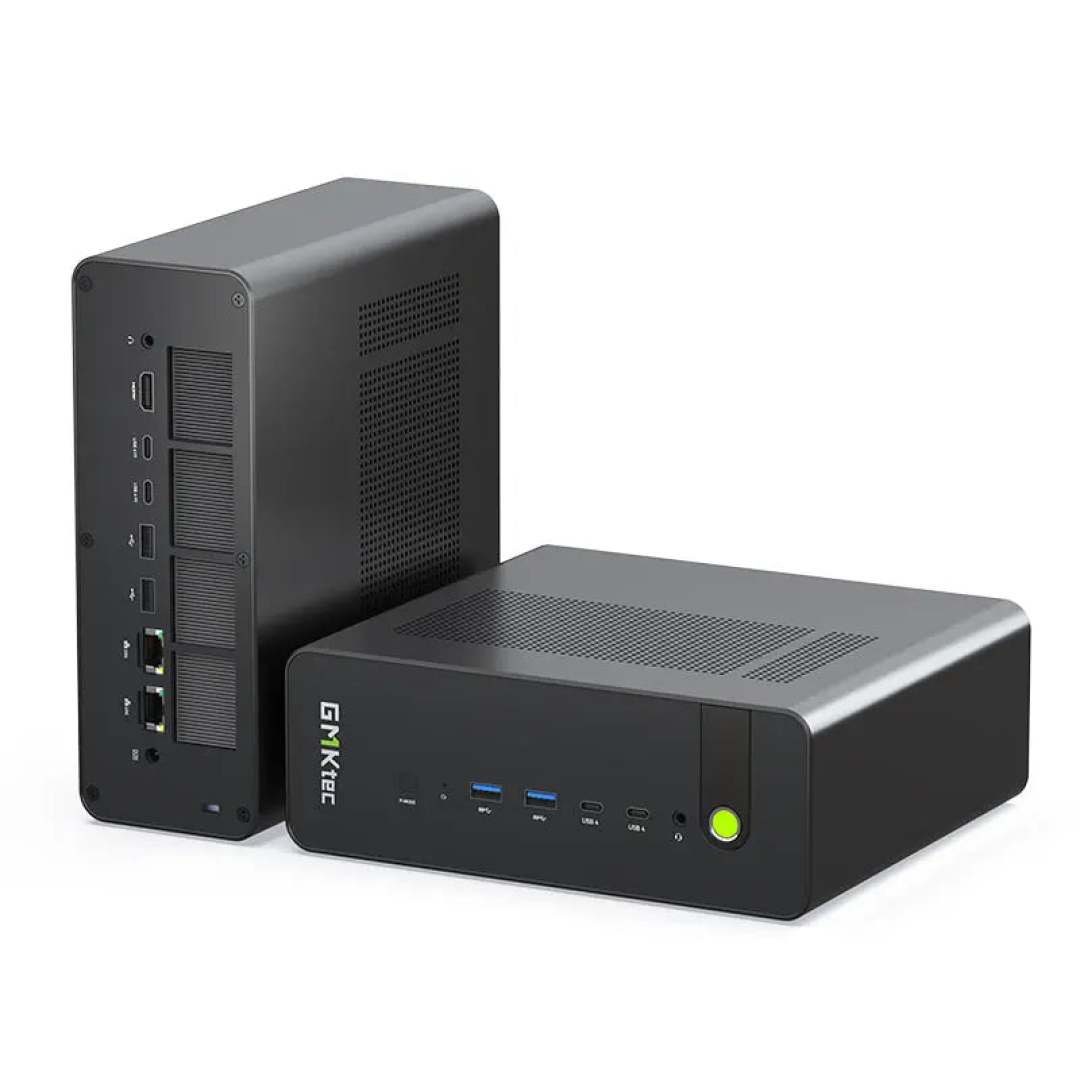
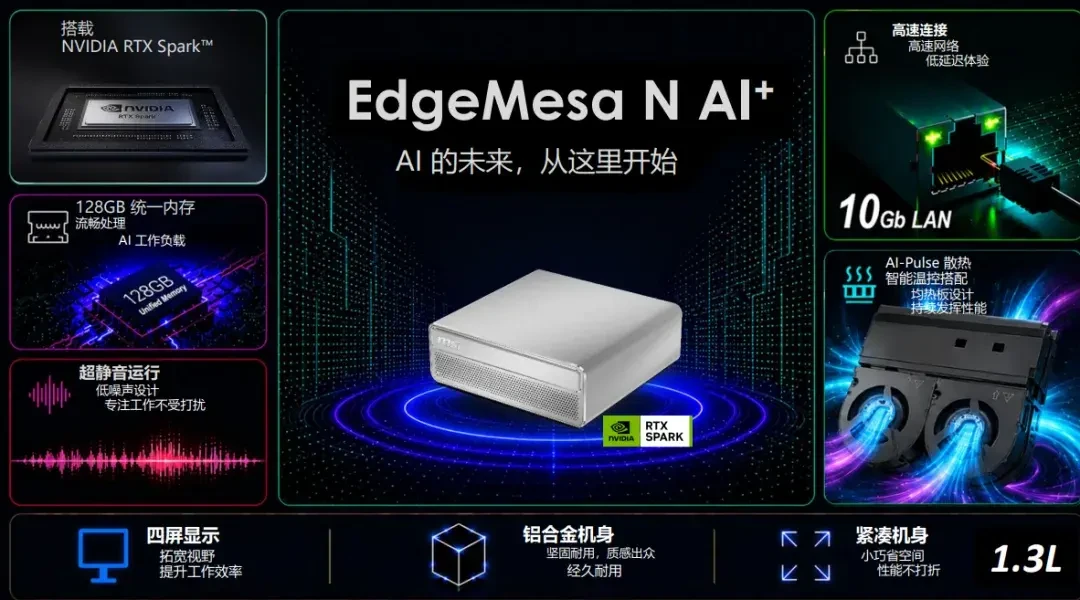
微星也没闲着,借着NVIDIA RTX Spark平台发了台1.3L的EdgeMesa N AI+。有意思的是,官方通稿标题喊"本地运行200B大模型",正文写的是"最高128GB统一内存,流畅运行120B参数"。同一篇文章,两个参数口径。微星官方太平洋科技
但你别说,两边的话都"成立"——关键在于,"跑"有几种跑法。
装得下吗?勉强。 320B参数按4-bit量化,每个参数约0.5字节,光权重就要160GB,而官方规格页写的正是:192GB LPDDR5X统一内存、最高160GB可分配显存。正好塞满,一克余量没有,上下文还得从同一个池子里抠。这就是为什么这一代的升级不在算力在内存:新芯片锐龙AI Max+ PRO 495把统一内存上限从上一代395的128GB拉到了192GB。上一代连DeepSeek-V4-Flash都启动不了——128GB装不下权重;这一代,装得进了。装下,是这场参数竞赛的全部门票。极摩客官网36氪知乎
跑得快吗?这才是痛的那笔账。 装下靠容量,跑动靠带宽:这台机器内存带宽约273GB/s,对面Mac Studio M5 Max是614GB/s,两倍多。受邀博主的单机实测显示,跑"128GB装不下"那个级别的大模型,生成速度约14 token/s,属于"能用但不算快",预填慢,长上下文等首字需要耐心。换轻量的MoE模型(Qwen3.6-35B-A3B-MTP),直接从62 t/s拉到90 t/s。同一台机器,两个世界。微星通稿把"流畅"两个字给120B、不给200B,就是这个道理——200B是"塞得进",120B才是"用得动"。知乎
那这46999谁买? 极摩客这篇实测的结论说得很直白:目标人群是需要本地跑大参数模型、对数据隐私和合规有硬性要求、又不想养专职运维的企业。企业化包装也齐了:双10GbE网口、8TB×3共24TB存储、AMD DASH带外管理、独立安全芯片,还支持扩展2U机柜集群。IT开机就能用,买的是合规证加人力。知乎极摩客官网36氪
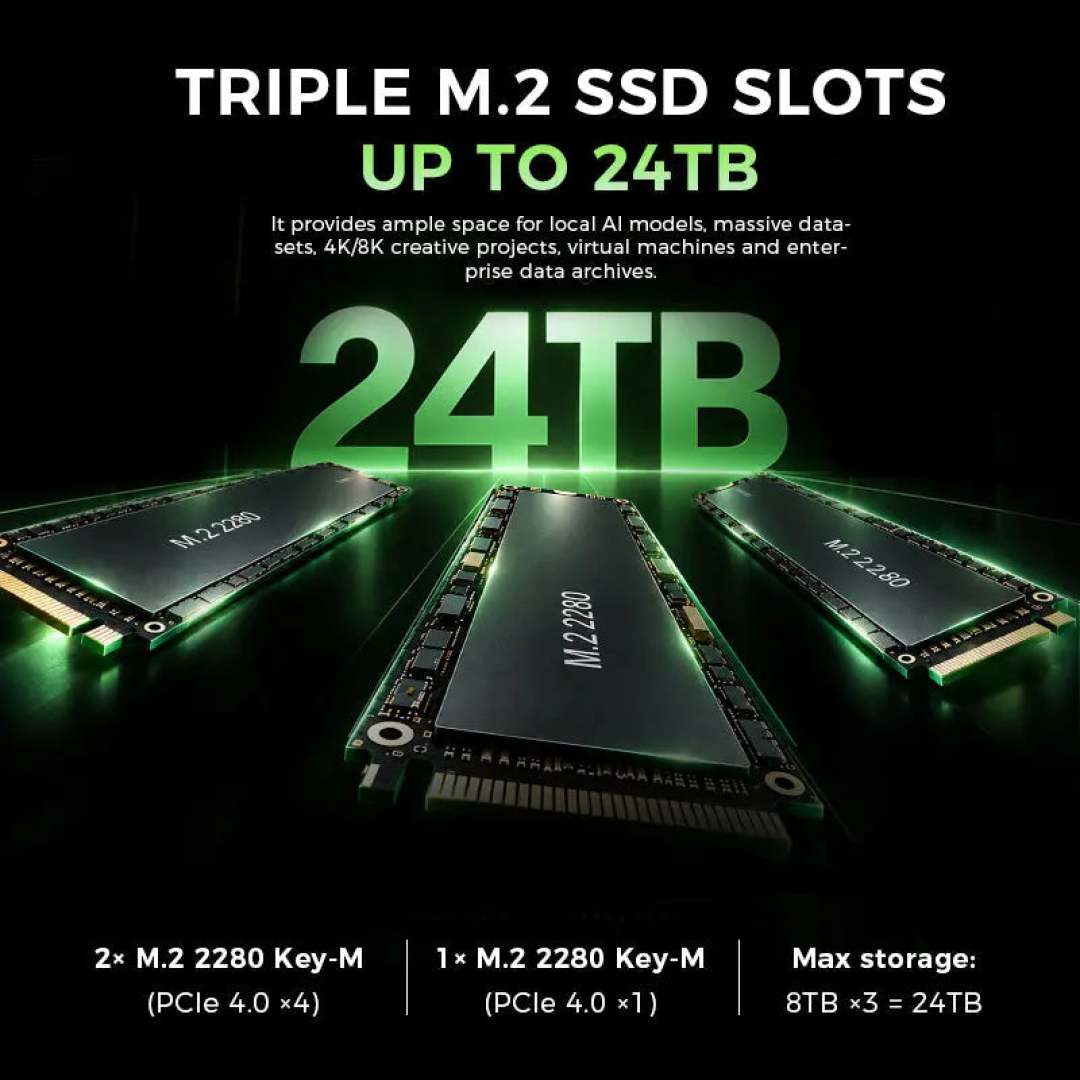
不够还有:一台不够,就插一柜子。
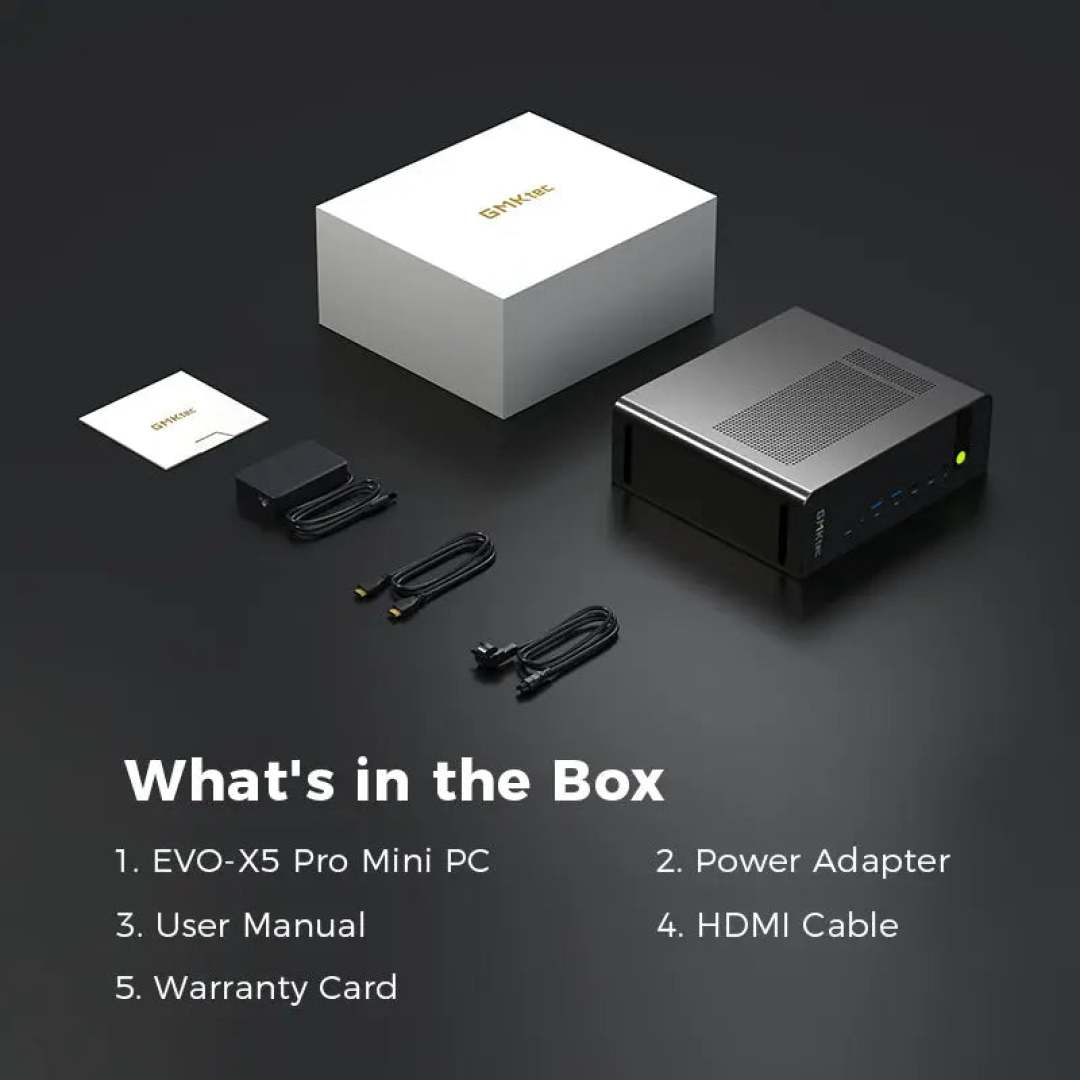
个人发烧友就别硬上。真上车,需求分层:只想尝鲜小模型,微星给教育爱好者档留的位置是内存为普通笔记本的2-4倍、可运行8B~14B模型。想要"说话跟得上"的体感,钱花在35B级MoE比花在320B上值——参数买的是入场券,体验看的是带宽。微星官方
一句话收账:这拨迷你主机没有让"大模型"变好用,它只是让"大"变成了卖点。看宣传先拆三个数——内存容量决定装不装得下,带宽决定跑多快,激活参数决定你等不等得起。下次再刷到"本地跑320B",先别激动,问一句:一秒吐几个词?