这周知乎那个老问题——「2026年下半年了,codex已经超越claude code了吗」——又冲上了一波高赞。这次置顶的不是站队文,而是一个做GPU计算开发的工程师晒的实测经历,具体到让我印象很深:
他让Codex做一版底层算子,初版交出来守恒性完美,解析案例一遍过;结果上到工程项目,4090的功耗只跑到100瓦左右——代码太"防御",性能根本压不上去。换Claude Code接手,功耗直接拉到420瓦,然后又花了很久做"代码卫生",中间还伴随小bug和性能回退,需要他人手动维护细节。他的结论也很不客气:「codex不适合许愿,但很适合当牛马」「许愿的人声量大,大多数人只是拿来做玩具的,真正干活的人不吭声。」知乎
这句话基本点破了这场持续半年的"超越之争":吵排名的人,和真正靠这两个工具交活的人,问的根本不是同一个问题。干活的人问的是——哪个活给谁干,token花在哪,账单怎么摊。
不是谁更聪明,是两种花钱方式和两种犯错方式
把最近几个月知乎、小红书上的一手实测拼起来看,这两个工具的差异根本不是"智商",而是token消耗结构和出错风格完全不同。
那位GPU工程师的总结很精辟:CC需要把更多token花在算子测试上,Codex则需要把更多token用来"洗干净代码"。展开说就是:知乎
Codex:防御性拉满,事无巨细地审查,算子基本不会有bug,你把接口给它,它完成得很严谨。但代价是架构写得稀烂——同一个底层算子,哪怕只多了一个签名,它都会本地再复制一遍;里面莫名其妙塞一堆if,异步调用基本没有,整体性能和可维护性巨差。这是O家模型的"遗传通病",防御性表达写文档是优点,写代码就是冗余。
CC:架构漂亮,“老码农的感觉”,后期维护基本只用看最底层。但如果你拿它"许愿"——不设计测试、不做验证,前期库会很漂亮,后期排任何一个bug消耗的token不亚于重新做一个库,更糟的情况是它自己排不出来,得你手动看。
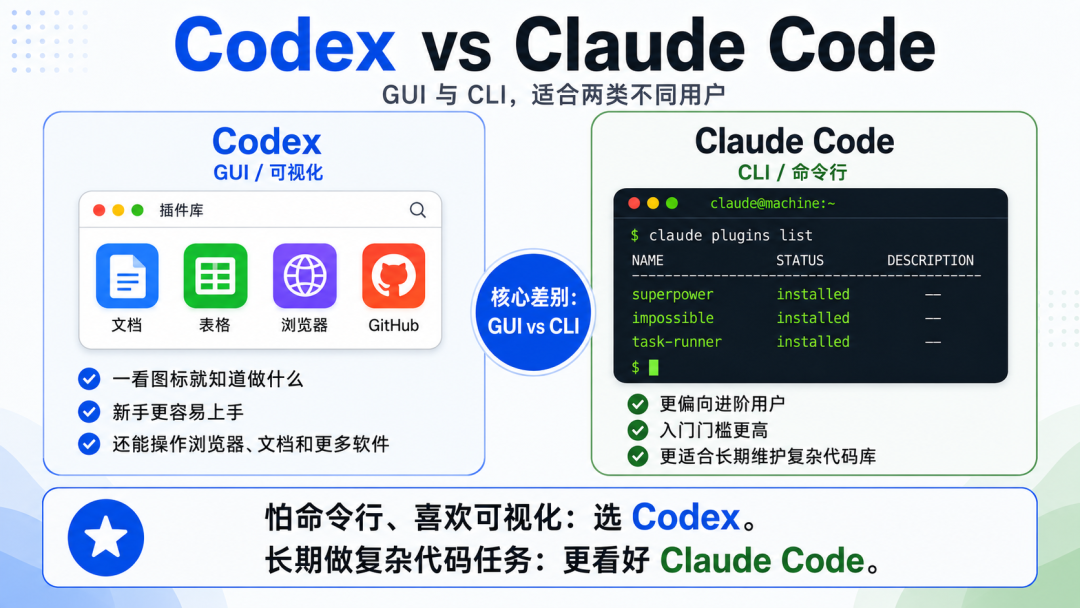
小红书上的实测者从另一个角度给出了几乎一样的结论:CC读大项目、想架构、做重构很稳;Codex上手快,适合搭脚手架。还有一条622赞、1126收藏的帖子说得更直接——Opus做架构师,GPT做代码执行者,各干各的擅长事。所以"谁超越谁"这个问题,在重度用户那里早就失效了。就像你不会问"锤子和螺丝刀谁超越了谁"。小红书
重度用户的分工,收敛成了同一个三层结构
我把这半年能找到的完整工作流帖翻了个遍——非程序员用双工具做产品的、拿"一生一芯"(中科院处理器芯片科普项目)练手的、多模型协同做网站的——发现大家的分工惊人地一致,基本都收敛成三层:
第一层:想清楚(规划层)。 一位352赞的"非程序员搞开发"用户的全流程是:先和Codex讨论需求,形成harness文档;再让Claude对文档提意见,让Codex反驳;如此交锋几轮,意见收敛后定稿。全程plan模式,一行代码不写。文档越细,后面开发越不容易跑偏。知乎
第二层:做出来(执行层)。 定稿之后交给一个工具分模块开发。做"一生一芯"的那位(665赞)用的是builder-reviewer工作流:Claude按章节文档构建代码,每个模块完成后由Codex审核。他的insight是——“Claude是很聪明的模型,适合快速写代码和做计划;codex是很严肃的模型,思考强度非常高,适合拿来review和debug”。这套loop最长一次连跑了10个小时。知乎专栏
第三层:挑毛病(验收层)。 小红书上那位「我终于把Claude Code和Codex协作搞定了」的楼主,定的边界最狠:CC不改代码,只看、只评、不动手;改代码全权交给Codex。 理由说得特别实在:“两个人都写代码=代码库变战场,你不知道谁改了什么、为什么改、出了bug找谁”。小红书
10月5日新出的一篇《Claude+Codex+Grok,就是王炸》又往前走了一步:CC当总协调,Codex管执行和初审,遇到重大决策或者Codex额度不够,再拉Grok顶上。楼主的定位是"不懂编程但一直用AI做网站"——连纯小白都开始给自己的AI团队排班了。知乎专栏

双引擎真正的门槛,不是钱,是"交接"
看到这里你可能觉得:双持订阅就完事了?先别急。所有跑通过的人都会告诉你同一个教训——双工具最常见的翻车点不是账单,是上下文断裂。
那位小红书楼主的原话:“一个在规划,一个在改代码,一个在验收,我在两个窗口之间切来切去,把CC的分析复制给Codex,再把Codex的报错贴回给CC,脑子里的上下文飘来飘去,根本接不上。工具越多,人越累”。小红书

他卡了整整一晚上的坑,说出来你可能不信:项目目录放在另一个Git仓库里,Codex改完代码没法生成独立diff,CC验收时看不到改了什么。最后把项目迁成独立Git仓库、补齐审查包、测试和修改记录,流程才真正闭环。他的总结值得抄下来:“工具协作的基础不是你多会用工具,是项目结构干不干净。”
所以想上双引擎,先把这几件事做了:
项目独立Git仓库,保证每次改动能出干净diff;
定好"谁能写代码"——最好只有一个工具有写权限,另一个只读;
每次改动推送前更新CHANGELOG,把"为什么这么做、放弃了什么方案"写下来,不然下次新开窗口,AI看着觉得奇怪,顺手给你"优化"掉了;
换电脑/换会话前生成交接文档(HANDOFF.md),别指望聊天记录。

账单怎么摊:谁值得双持,谁千万别
先说钱的痛点。B站这两天报道GitHub爆火项目OpenRig(把CC和Codex组织成"一个开发、一个检查"的小团队)的视频,开头一句就是:“20 美元不够用,100 美元太多”。这大概是双持潮最真实的推手——主力工具的额度永远差一口气,升档又肉疼。哔哩哔哩
双持的性价比逻辑其实很清楚:审查任务的token消耗远小于开发任务。 把"挑毛病"这一层分给另一家的模型,等于用一份低强度用量,买一个不会被同一套思维盲区糊弄过去的第二双眼睛。这比把单一订阅从20刀升到100刀划算得多。
但有两类人要泼冷水:
国内普通用户,别硬上双持。 一条659赞、208评论的回答说得直白:Codex只支持ChatGPT系模型;而你在境内能合法合规买到、能用上的所有国产模型,对CC的支持都好于Codex。如果你的主力方案已经是CC接国产模型,再叠一个Codex意味着双份海外订阅、境外手机号、境外卡、网络环境——每一项都是持续的成本和封号风险(这季度Claude的封号潮大家都看到了)。知乎
需求还在"许愿"阶段的轻度用户,先别学排班。 三层分工的前提是你有明确的需求文档和验收标准。没有这些,两个工具只会以两种方式跑偏,你还得付两份钱。
时间窗口的背景数据也值得记一下(引自8月那条323赞的退订讨论,供参考):Codex周活6月已破500万、5个月增长730%;CC份额约14%、网传出现退订潮;GitHub Copilot约42%、Cursor约18%。模型能力在收敛,用户迁移成本低得离谱——今天用Claude,明天换Codex,比你换手机壳还快。这正是"分工"取代"站队"的底层原因:既然谁都能干个七八成,那让不同的家伙干不同的活,比赌一个全能冠军稳得多。知乎
接下来盯什么
三个信号,值得双持党和观望党都留个心眼:
OpenRig这类"Agent组队"项目:CC当负责人、Codex当检查员、固定角色和地址、断电重启能接着干——方向对,但还很早期:依赖tmux、只支持macOS/Linux,Windows得走WSL。先围观,别急着把它架到生产项目上。
GPT-6系订阅渠道提速:10月6日的消息,GPT-6 Astra与GPT-6.1 Sol订阅渠道默认速度提升约50%,无需改设置。Codex侧的体验可能又要变一轮,"严肃但慢"的刻板印象或许要更新。哔哩哔哩
CC的Mods生态:Claude Code刚开放Mods插件(能拦截危险命令、改写工具调用行为),如果审查、验收这些环节未来能被插件接管,"第二双眼睛"是否还需要另一家订阅,会是个新变量。知乎专栏
最后说一句我的判断:「超越之争」还会吵很久,因为排名的谈资永远有市场。但对真正靠AI交活的人,问题已经换了——不是谁更强,而是你的工作流里,谁负责想、谁负责做、谁负责挑毛病,以及这三份活,你准备各花多少钱。
420瓦和100瓦之间差的不是智商,是分工。