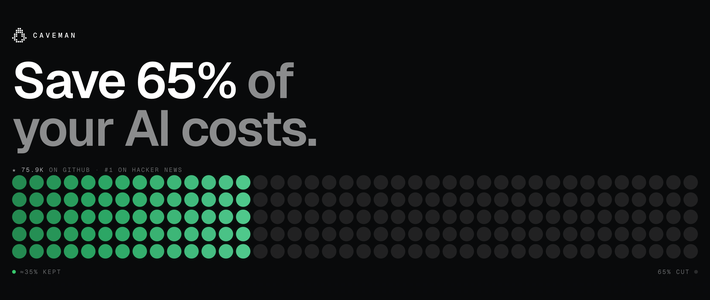
今年4月4日,有人往GitHub上传了个仓库,里面是一份十分钟写出来的提示词,名字很糙:Caveman,原始人。口号是句语法不通的英文:“Why use many token when few token do trick”——为啥要用多token,少token也能干活。知乎
半年后,这个"玩笑"长到了11.2万颗星,最近几天又冲回GitHub热榜,全网视频文章扎堆。它干的事一句话:让AI编程助手学原始人说话,少废话、省token,也就是省钱。一条命令装上,Claude Code、Codex等30多个AI编程助手通吃。知乎哔哩哔哩哔哩哔哩
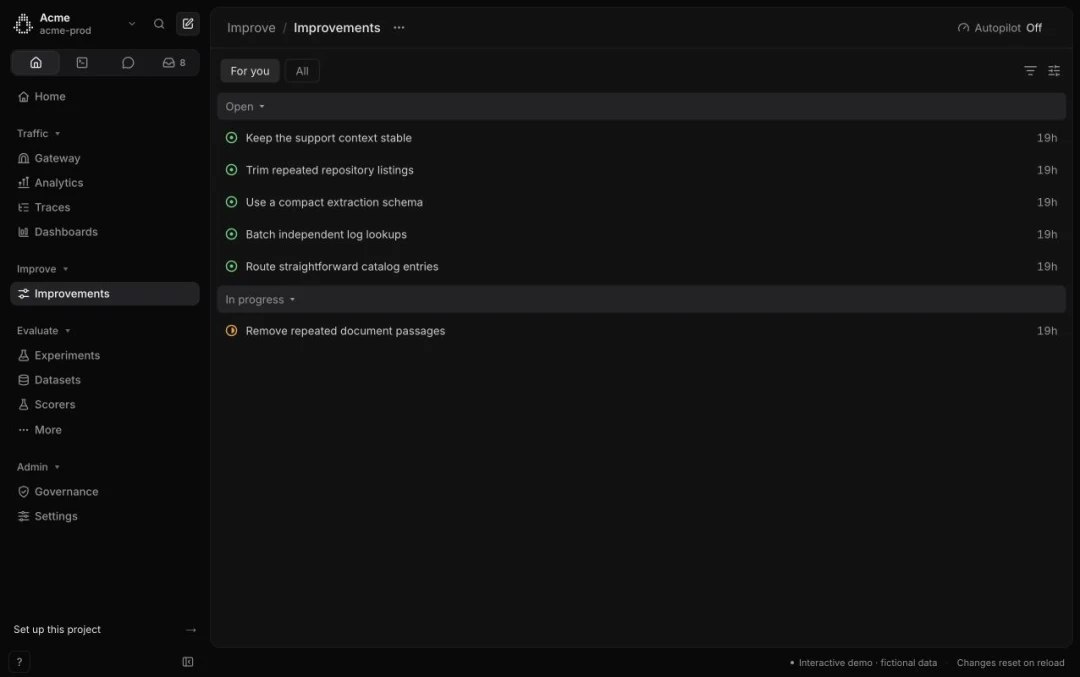
但好笑的是,它到底能省多少,成了一桩悬案。
五个数字,四个说法
翻开它的门面,数字一个比一个唬人:最早宣传省75%,仓库简介现在写省65%,官方文档说整个会话的输入token少33.2%。知乎哔哩哔哩
然后JetBrains在7月下场,做了这个品类里最狠的配对实验:86个真实编程任务、3轮约240次计费运行,烧掉106美元。结果——输出token只降了8.5%;带Caveman的账单40.60美元,比不带的36.39美元反而贵了11.6%。知乎
倒挂哪来的?一个涉及长上下文的审计任务越过了200k token定价档,单次烧掉8.29美元,对照组同一任务只要0.33美元。一个任务,掀翻了整轮实验的账单。知乎
JetBrains的结论相当扎心:“安全、对风格诚实,但对节省的说法过度销售”。原因是结构性的:Agent会话里token的大头是代码、diff和报错原文,Caveman按设计一个字节都不碰;它能压的只有工具调用之间的叙述,而"叙述本来就不多"。知乎
但它也不算骗子
有意思的是,质量真没垮。82个配对任务里64个打平、8个更高、10个更低,统计上判定"无可测退化"。Adobe研究院的论文也发现:压缩AI的输出确实能省1.4到2.4倍成本;但压缩喂给AI的输入是"严格的输-输",净成本平均反升1.15倍——因为模型会用更长的回答来补偿。知乎哔哩哔哩
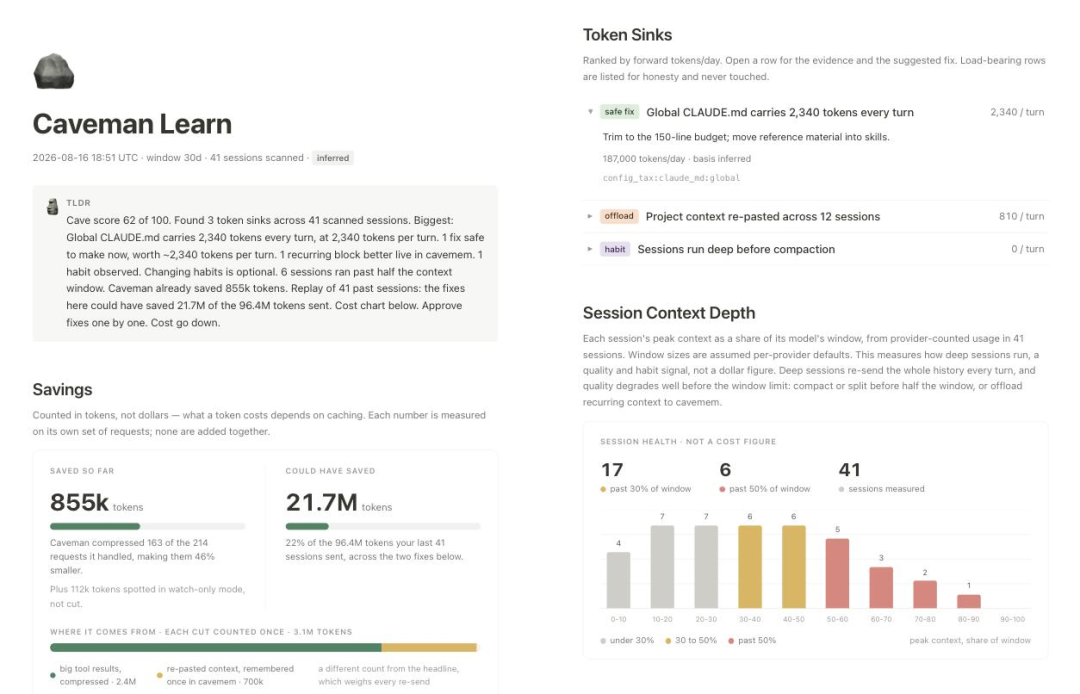
项目方倒坦率,专门开了个"诚实数字"页面:它的规则每次要注入约1160个token当"入场费",如果你的问答本身只有一百多token的输出,省的还不够付入场费。亏损案例一条条列着issue编号。知乎
维护者甚至说过一句自嘲:“想让石头管用,不会让石头真的管用”。知乎
装不装,先看计费方式
把两边的数据摆在一起,账就清楚了。
三种人别装:
按请求、按消息计费的(比如Copilot的premium request):回答再短也是同一次请求,一分钱不省。哔哩哔哩
短问答为主的:输出不到150个token,入场费都赚不回来,官方自己承认净亏。
固定订阅包额的:省的token未必变成省的钱;而Auto模式要登录,会把你最新的问题连同CLAUDE.md、记忆文件一起发到它云端,隐私敏感的慎开。知乎知乎
一种人可能真省:按token计费、工作流里全是测试日志、CSV、JSON的长会话。官方那个33.2%就是在这类场景测出来的,其中日志压掉一半、CSV压掉55%;但注意HTML反而多花9.9%,不是万能药。知乎哔哩哔哩
最后给个现成的验收方法,也是官方给的:拿你自己的真实项目,开与不开各跑一遍同样的任务,对比账单——账单升了,就关掉它。知乎
这比信任何一个宣传数字都管用。