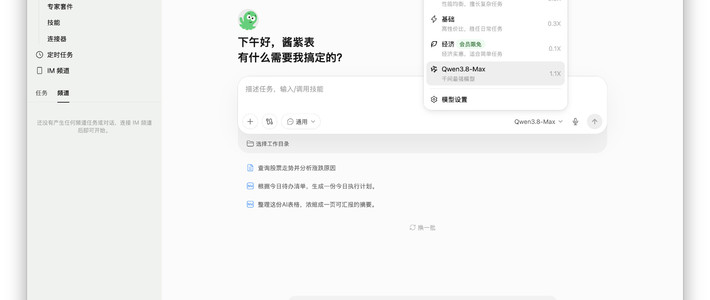
先把两张截图摆在一起看
9月15日,小红书推荐流里照常躺着两条新货:一条叫「自媒体10大神级Skill!创作者遇瓶颈建议收藏」,一条叫「Codex十大Skill,一条线管选题到复盘」。往前翻两个多月,是这个赛道最吓人的一页:一位同时跑十几个账号的博主晒出自己搭的「起号运营Skill」,她的原话是"最累的不是写稿,而是每天重新判断:现在什么值得发?这个热点适不适合我?"。 单篇收藏28,681,比点赞18,199还高出一大截,转发3,898;短视频侧更夸张,抖音一条"codex超好用skills,使用频率高,不吃灰"拿到26.5万赞、20.3万收藏。 做自媒体的都懂"收藏大于赞"意味着什么——大批人打算回头照做。小红书抖音
但9月开始,风向变了。9月上旬,Eric Provencher 写给 Codex 用户的指南《为GPT-6 Astra重新思考你的skills和提示词》在中文圈刷屏,知乎相关问题浏览量冲到18.4万。紧接着9月12日,一位开发者没凭感觉,直接打开Codex本地会话数据库,统计了5.1周的真实调用记录,装了一堆的Skill里,31个一次都没被读取过。 同一条问题下另一位用户的回答很扎眼——“我的AGENTS.md只有10行,16个skills加起来也就24kb,足够用了”。知乎知乎
清单党还在量产,官方和老用户已经动手删。如果你是自己管一到十个号、在Codex、Claude Code或WorkBuddy这类桌面Agent里装过"必装十大"、并且周额度总莫名其妙见底的创作者,装下一份清单之前,建议先把这三本账对完。
第一本账:额度——你买的Token,很多没花在"写"上
清单帖都写"一句话开工",没人写开工的价签。9月11日一篇知乎复盘里反复提到一种群内反馈:一个看起来不复杂的小程序,跑着跑着,一周的额度就没了。 复盘结论是:真正完成目标的修改并不多,大头消耗在任务之外——重复扫描已经读过的文件、把局部修改顺手扩成全量检查、把完整日志和大diff原样搬进上下文。同一位作者转述了一个社区自报案例:把原始输出换成摘要和关键字段后,单日Token从约1.38亿降到约2000万。这是自报数字,没有公开A/B验证,只能当方向,不能当承诺。知乎
外部也在收紧:8月25日Codex恢复对Plus用户的5小时窗口限制,产品负责人给出的理由写得直白,9月11日又传出暂停200美元新Pro订阅的消息。 额度不是无限背景板,是排给你我的稀缺资源。微博微博
还有一层更隐蔽的:重量级流程Skill会在每次会话开始时强制注入。有博主实测,225个文件的Superpowers,有个规矩苛刻到"哪怕任务只有1%的可能和某个skill相关,也必须先调用那个skill",加上动辄半小时的头脑风暴,把一句"帮我做个素材库"的小需求,一路选择题膨胀成"好几周工程量"的方案——他管这叫"面对选择题,人人都是甲方"。 替掉它的,是正文不到10行的grill-me:同样问问题,但每个问题附推荐答案、替你先砍第二阶段需求。转引的第三方测试里,同一个需求Claude自带Plan Mode问0个问题、Superpowers问6个、grill-me问37个。问得多不等于更专业,问得准才等于替你踩刹车。知乎
第二本账:噪音——为什么装得越多,稿子反而越"像模板"
这是清单帖绝对不会展开的机制题。Skill是两段式加载:名称和描述常驻上下文,正文按需读取——模型决定用不用某个Skill,靠的是它读到的那一句描述。而OpenAI那份精简指南点破了数量带来的连锁反应:描述一长、一多,就会被系统截短,模型更分不清该开哪份;描述互相打架时,不该加载的也会被拉进来。微博
它给的负例很具体:一个Postgres迁移Skill,描述写成"碰到数据库、查询、模型、持久化就用",结果模型在任何摸到数据库的时候都把它打开。 那位清理31个Skill的开发者给了个本土样本:他装的frontend-patterns主要面向React和Next.js,实际项目却大量是Vue和uni-app,“虽然提供了一些通用思路,但不是最匹配的前端知识源”,模型的框架习惯照样被套进他的活里。 9月16日凌晨,还有人在微博发出真实崩溃现场:“真是要被这个美化搞疯了codex我装的skill你咋不用啊”。 装得多不等于用得上,用不上还占着你的上下文和额度。微博知乎微博
所以"高星"“全家桶”“很长的规则文件"都不构成安装理由。判断标准只有一条:它有没有进过你的工作流。那位清理者的做法也很克制:有真实使用记录的Skill不因为功能重叠就立刻删,删除的门槛是"先观察后续一个月再决定”。知乎
第三本账:营销——"收藏帖"背后是谁的生意
晒单帖经济学在这波里原形毕露。8月2日微博上"把排版、配图、发布做成Skill"的安利拿到1224赞。 9月15日知乎有人晒"99.9元的AI工具,卖了6万"——把Skill本身当货卖,已经是这门生意的下一环。 而清单帖的引流钩子高度雷同,就三种信号:微博知乎
文末送资料:“整理成了文档,私信领取”,甚至直接挂网盘链接——有的"实测复盘"原文末尾写的就是"我放在夸克网盘了,有需要的可以私信领取",自己就是活教材。知乎
黑话扣字:“评论区扣【矩阵】上车”,话术全部指向私域。哔哩哔哩
换皮清单:MoneyPrinterTurbo、MediaCrawler、Postiz、TrendRadar这批开源项目名,在小红书、抖音、B站、知乎的清单帖里轮换成"十大"“九个”“6个必装”。 项目是真的,"必装"是他们说的。小红书
今年"流量主晒单帖"那波已经验证过一轮:晒收益是口号,卖课才是生意。Skill清单是同一套剧本换了道具。
还有一条硬边界别踩:多个平台今年已公开点名处置"AI托管"类内容。分发、排期、自动发布这类托管动作风险最高;选题判断和表达终审,无论哪个清单说得多神,都不外包。
回到操作:一次审计,三个动作
先做使用记录审计,别凭印象。“用过"的定义只认会话里实际读取过那份SKILL.md——安装在目录里、出现在可用列表里,都不算使用。翻你最近一个月的Agent会话记录,没触发过的先删:那位开发者5.1周审计出的结论就是保留少量高频通用Skill,再补一两个真正贴业务的专项,胜过几十个"暂时用不到的全家桶”。知乎
装新Skill前自测三问:这件事做完需不需要留下一套文档,给团队或三个月后的自己看?当前需求你能不能说清三条验收标准?两个都答得含糊——那你缺的不是第11个Skill。知乎
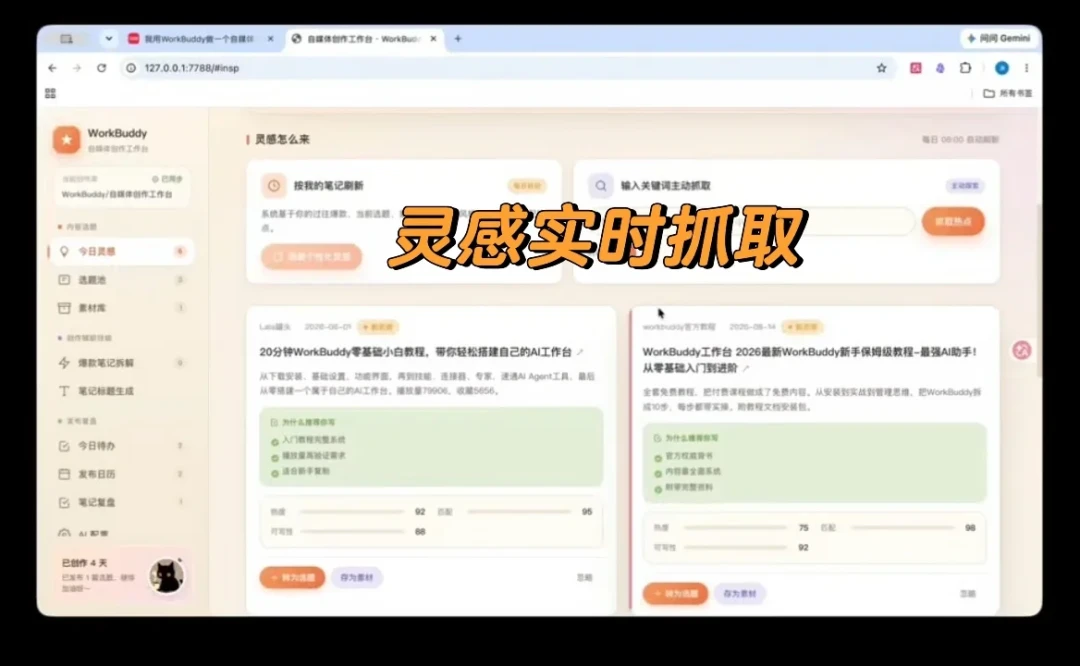
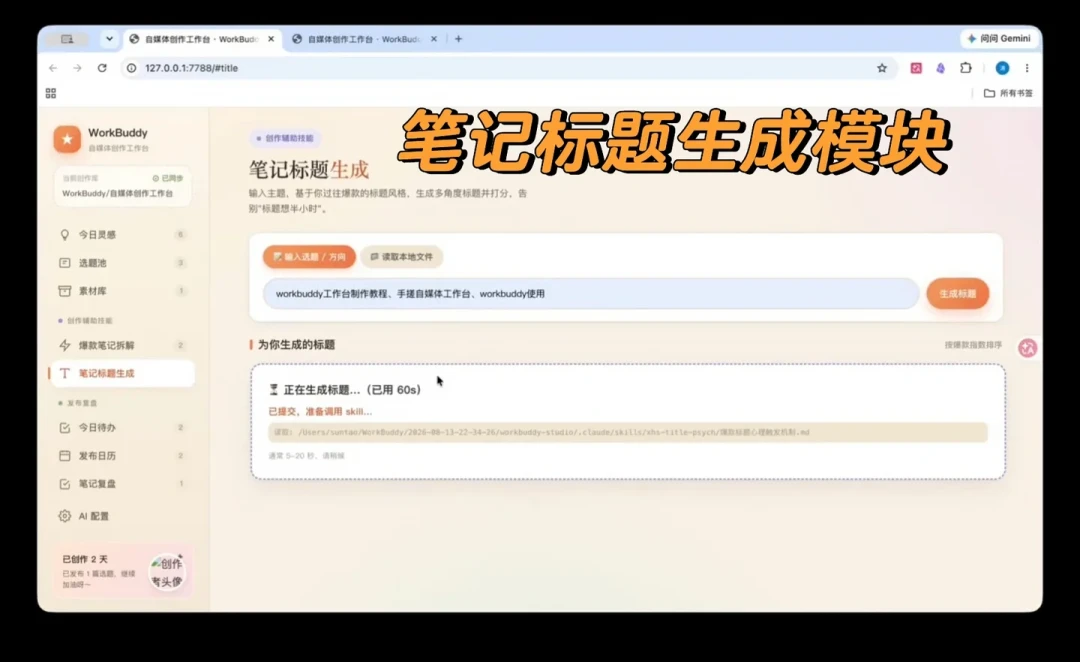
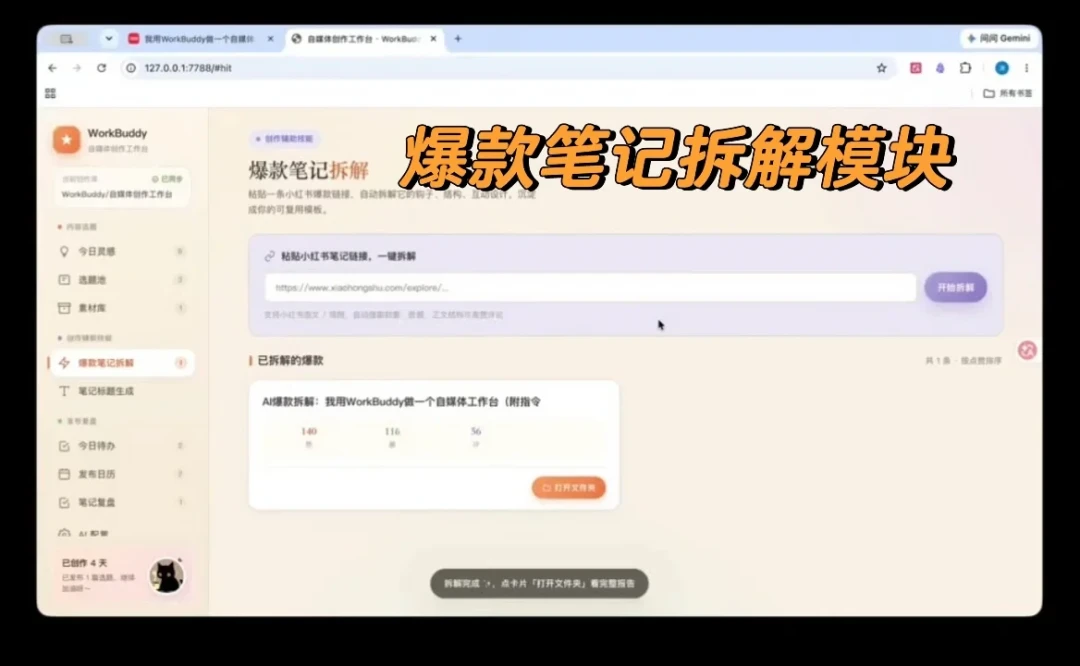
先跑通一个模块,再谈组合。那个全网超2万人看过、收获487条评论的开源"自媒体工作台",就是一块一块拼起来的:灵感收集、爆款拆解、标题生成——每个模块单独跑顺,才有资格串成生产线。小红书
至于怎么判断这个圈子是否真的转向:不用数又出了几份清单,去翻老清单的评论区——当问"怎么打包"的人开始变少、问"为什么没触发""额度去哪了"的人开始变多,退潮就算坐实了。
数据截至9月16日采集,互动量为抓取时点数值;文中星数、Token自报数、测试题数均为信源转述口径,已按此标注。清单会继续量产,你的额度不会。