

昨天到今天,同一个基座上,两拨人交出了两份方向完全相反的作业。
先说轻得离谱的那份。HuggingFace 的 harness-hub 这周放出 Qwen3.8-27B-pi-adapted:一层秩 32 的 LoRA 适配器,底座权重一个字节没动。官方口径里,SWE-bench Pro hard-51 从 39.2% 提到 64.7%,Terminal-Bench 2.1 从 39.5 提到 55.8,单任务 token 消耗降了约 4.5 倍。反直觉的地方就在这儿:这组分,是把思考模式关掉跑出来的。不是让它想得更久,是让它别想了,直接动手。哔哩哔哩哔哩哔哩哔哩哔哩
再说重的那份。RadixArk 11 月 18 日发布 DaisyRose-27B,底座同样是 Qwen3.8-27B,但走的是全量强化学习:1200 个精选任务、144 块 H200、训 18 天,折合 6.3 万 GPU 小时。Terminal-Bench 4.1 的 pass@1 从 5.6% 干到 12.0%,SWE-bench Pro v2 从 91.3 到 94.7,七项基准全涨,BF16、FP8、NVFP4 三个精度的权重一次性全开源。知乎
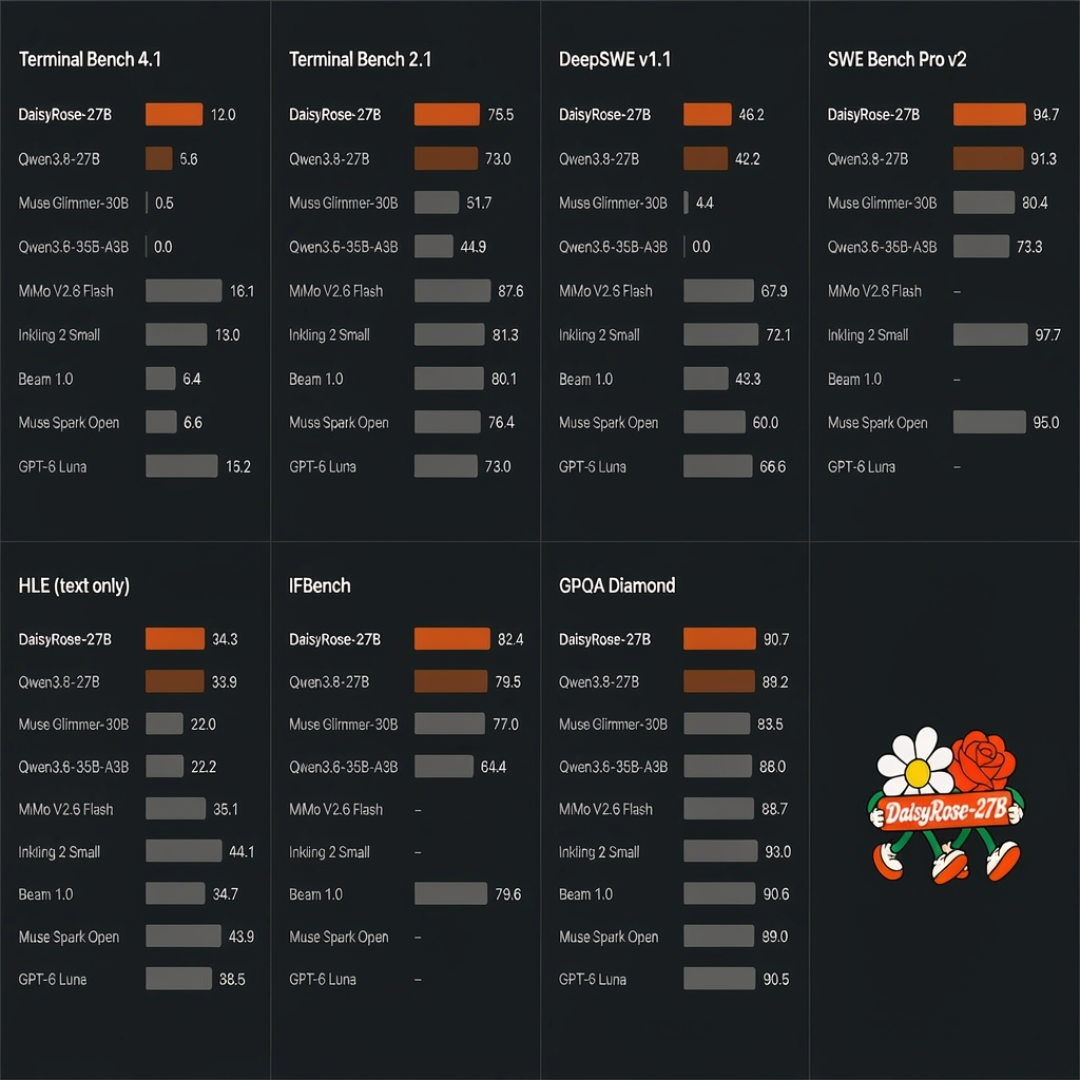
6.3 万 GPU 小时,和一层秩 32 的适配器,前后脚摆在了同一周。
先别急着比分数
这两组数没法直接对着看。基准版本就不是一回事:一边是 SWE-bench Pro hard-51,一边是 v2;一边 Terminal-Bench 2.1,一边 4.1。更要紧的是,两组都是项目自报——DaisyRose 那组,转述的人自己就写明了「以上数字全转述自RadixArk官方博客,我没跑过复现」。而 SWE-bench Pro 这套题,今年 7 月还被 OpenAI 自己审计过,结论是约 30% 的任务存在缺陷。所以跑分只能当一个信号:值不值得花十分钟下载。当不了结论。知乎微博
真正要算的是三笔账
第一笔,你的显存够不够。
Qwen3.8-27B 的 4bit 版本大约要 15~17GB。8G 显存的游戏本可以直接划走。知乎
Mac 这边有第三方实测:llama.cpp 加载 Q4 量化再挂上 LoRA,上下文开到 256K,输出约 28.9 token/s。说实话,这个数字比 64.7 分更让人想动手。哔哩哔哩
也有人拿一台 12G 显存的 RTX 3060 迷你主机,用 RAMDeck 把另外三台设备的内存凑起来才跑通,速度是每秒 1.92 token。能跑,但没法用。知乎
第二笔,这层 LoRA 认不认你的工具。
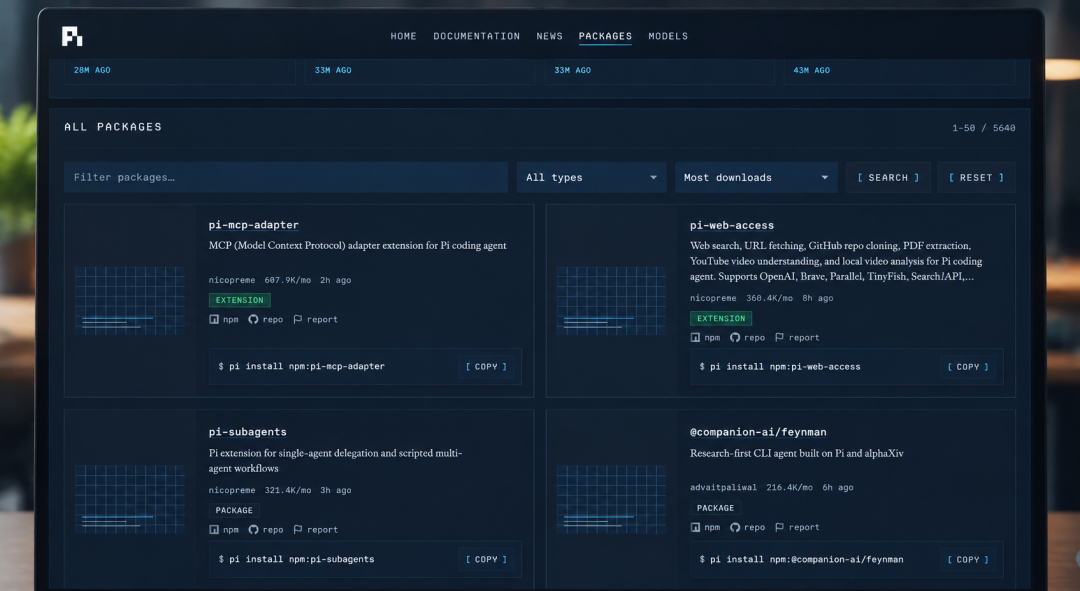
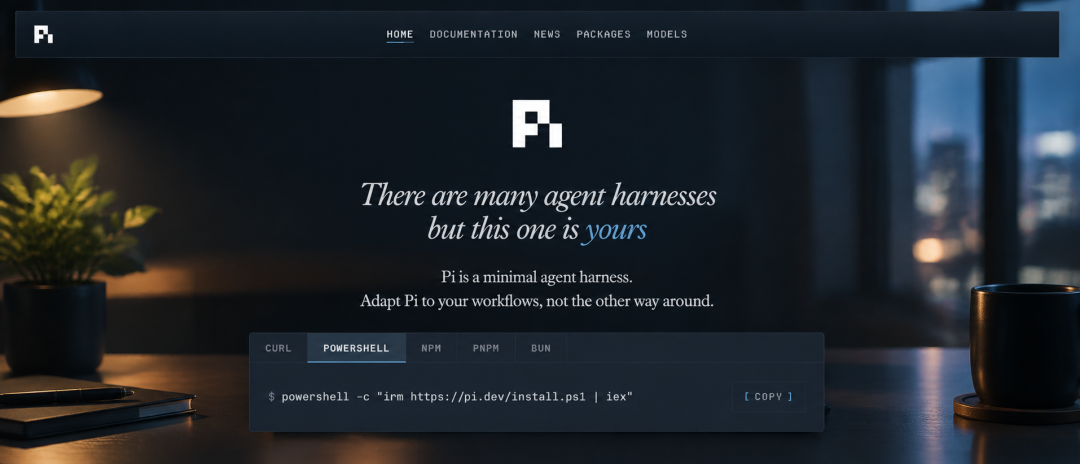
pi-adapted 是照着 pi 这套 minimal agent harness 训的,而 pi 有多极简?在 coding agent 形态下,它默认只给模型 read、write、edit、bash 四个工具。视频评论区里排在前面的一条,问的正是这件事:这个 LoRA 只对 Pi Agent 有用吗,放其它 Agent 用是不是得寄?官方模型卡自己就写明了两条边界:跨框架过拟合,以及 GGUF 量化的适用范围。所以如果你手上是 Claude Code、Codex 或者 opencode,别指望白捡这 25 分。知乎哔哩哔哩哔哩哔哩
第三笔,你到底该下哪一个。
想马上试的,拿 LoRA,Apache-2.0,挂上去就能跑,成本是零。要在自己机器或者服务器上长期部署的,DaisyRose 给了三个精度档:24G 显存这一档看 NVFP4,服务器上看 FP8。顺带交代一下背景,RadixArk 就是开源推理引擎 SGLang 背后的团队创办的公司,这次训练用的异步强化学习框架 Miles 也是他们开源的。工程侧的可信度不算低。哔哩哔哩知乎
最后一条建议
别看榜。从你自己的仓库里挑三个真任务——一个改 bug,一个加接口,一个跨文件重构——两份权重各跑一遍,记下 token 数和返工次数。这半小时,比任何跑分都值。
当前文章无评论,是时候发表评论了