10月9日深圳,极摩客拉着AMD和京东开了场发布会,主角是台巴掌大的盒子——EVO-X5 Pro,官方宣传里最抓眼球的一句是"192GB统一内存,本地离线运行320B参数大模型",售价46999元。现场真有人跑了。受邀到场的博主Genima用机器预装的推理引擎实测,DeepSeek-V4-Flash-0731这个级别的模型只有14 token/s,属于"能用但不算快"。同一台机器换个轻量MoE模型,速度直接从62 t/s拉到90 t/s,差出六倍多。他的结论很干脆:“这是273GB/s带宽的物理现实,和调优关系不大。”知乎

第一笔账:多付的钱买的是容量,不是算力
46999元这台搭载的是锐龙AI Max+ PRO 495,极摩客称全球首发。它比上一代强多少?看另一台机器更直观。
BOSGAME M5 MAX,同一颗495,128GB版3099美元,192GB版6199美元——多出64GB,多掏3100美元,折合人民币两万多。这台目前只有海外预售,国内没有官方渠道。小红书
那这两万块换来了什么?NPU从50到55 TOPS,核显FP16从60到61 TFLOPS,官方标称的模型上限从200B写到300B。算力基本没动,翻倍的是内存那一栏——用阿亮学长测评的话说,“这不是给你用的电脑,是给模型住的房子。房子按面积卖,内存就是面积。”小红书
第二笔账:装得下和跑得快是两件事
495这代把内存上限从128GB提到192GB,频率8533MT/s,带宽约273GB/s;上一代395最高只支持128GB、带宽约256GB/s。容量决定模型能不能启动——Genima提到,那个只有14 token/s的模型在395上根本启动不了,权重太大,128GB装不下。带宽决定你等不等得起。知乎
长文档场景最明显。猛犸哥学AI拿一台128GB的395机器塞进20万token做检索测试,埋的8位暗号四次全找回来,一个字没错;但预填充大概1,325 tok/s,20万token光读进去就要两分半。他的形容是:“盯着屏幕,跟等水烧开一样。”小红书

参照系:Mac Studio M5 Max的内存带宽是614GB/s,495的两倍多。知乎
第三笔账:标称内存不等于可用显存
EVO-X5 Pro标称192GB,官方口径里还有一句"最高160GB可分配显存",售价46999元。中间那32GB,是系统和桌面要占的。知乎
划分还是个手动活。猛犸哥在BIOS里给显存固定64G、给Windows留64G,“分错了会直接卡死,我卡过两次”。模型加载卡住时更别强杀,他那次硬杀之后,残留的显存让下一次加载直接崩了。小红书
想估自己能跑多大模型,有条经验公式:可跑模型规模约等于(可用显存或统一内存减12GB)除以每参数字节,再乘0.8留余量。每参数字节,FP16是2,FP8和INT8是1,4bit约0.5;KV Cache和系统本身还要吃掉8到16GB。知乎
提出这条公式的作者把"拿标称内存当可用显存"列为第一个坑,建议下单前只问一句:标称容量里最多能划多少给GPU?知乎
散热也别按"安静小盒子"预期。猛犸哥那台满载时GPU读数到过103℃。EVO-X5 Pro这侧是VC均热板加三风扇、120W持续释放,长时间跑模型不降频。小红书知乎
现在该不该买
内存还在涨。DDR5合约价已经连涨9个月,价格约为去年底两倍。零售端更直接,到11月初一套32G的DDR5套装报价已经突破3000元。小红书知乎
需求那头,业界预计2026年AI数据中心将消耗全球约70%的DRAM供应。今日头条
供给这头,原厂把产能切给了AI的高带宽内存,每产1GB HBM要让出3GB普通内存。小红书今日头条
大内存迷你主机的溢价,短期不会松。所以两件事分开算:只为"装得下",看容量;要"用得爽",看带宽。273GB/s这一档,问答够用,秒回别想。
预算有限还有条路。同样是Ultra X7 358H,32GB+1TB的阿迈奇F2A国补价只要7649元。今日头条
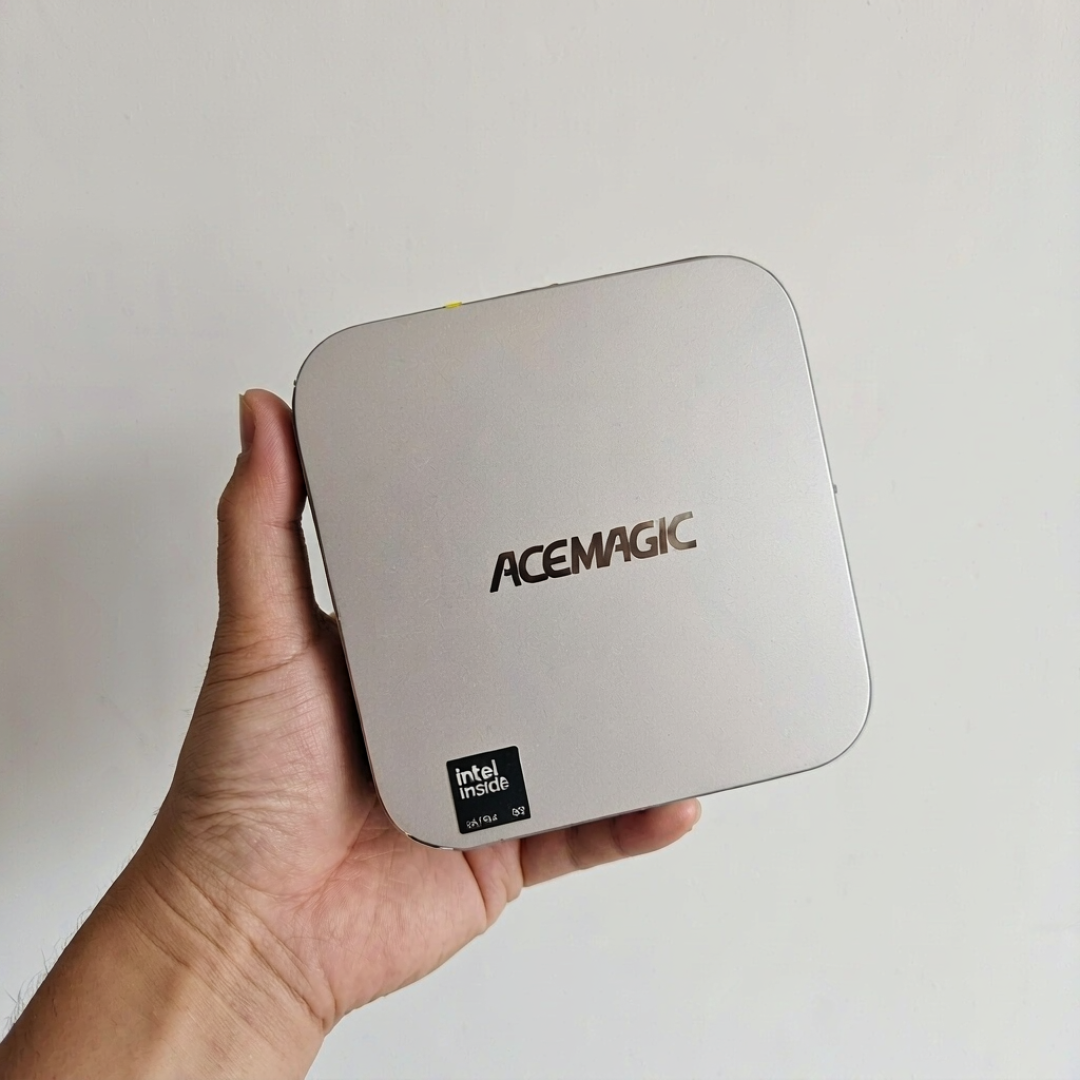
它实测GPT-oss-20b能跑到15.32 token/s,同一台机器上Qwen3.8-27B只有3.32。模型之间的差距,有时候比机器之间还大。十几token/s这个量级,日常问答够用,当生产力不够。今日头条
本地跑模型这件事,"能跑"和"好用"之间,隔着一条内存带宽。