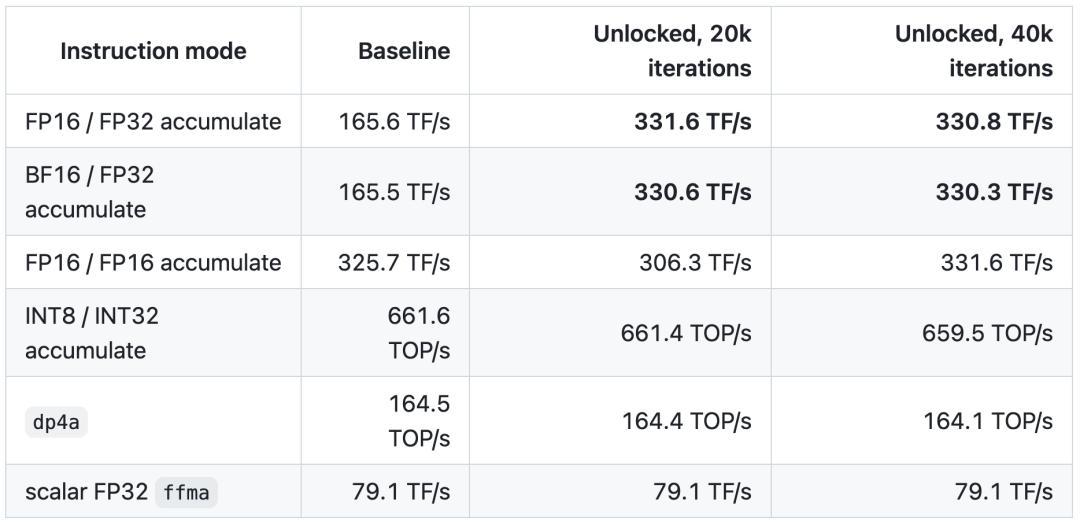
开发者JustAResearcher把同一张RTX 4090插回同一台机器,450W功耗墙没动,FP16输入、FP32累加的Tensor吞吐从165.6 TFLOPS跳到331.6 TFLOPS。36氪
卡没换,BIOS没刷,英伟达官方驱动照常加载。 变化发生在驱动接管之前。GitHub
一个叫nv-uefi-unlocker的开源项目,把程序写进U盘,以UEFI方式启动,在系统和驱动加载前改写显卡里几个控制指令发射速率的寄存器。断电,一切复原。
10月下旬,GitHub上先后出现gpu-unlock、gpu-unlock-ada和nv-uefi-unlocker三个项目,分别走Linux内核模块、40系专用和UEFI启动三条路。
到11月5日,仅nv-uefi-unlocker就攒了1746颗星。截至11月初,英伟达没有公开回应。
最先沸腾的是跑分。RTX 3090 Ti的BF16矩阵吞吐从87.5涨到157.4 TFLOPS。 RTX 3080从65.4到113.4;一张22GB显存的RTX 2080 Ti改卡,也从55.7拉到91.4。36氪
看上去像白捡一张新卡。但换成真实任务,数字立刻缩水。
同样是4090,cuBLAS矩阵乘法只快12%到34%,而且矩阵越大,增幅越小。 逐字生成大模型时,它几乎不动。 游戏帧数更直接:零。36氪知乎
原因不复杂。被锁的只是Tensor核心的一条路:FP16、BF16、TF32输入,FP32累加;40系还多一条FP8。INT8、FP16累加、普通FP32和FP64,本来就是全速。知乎
游戏主要吃FP32光栅化和FP16累加,不在被锁的路径上。大模型逐字生成卡在显存带宽,算得再快,也要等数据从显存搬过来。36氪
真正受益的是图像和视频生成、LoRA微调、长文本预填充。这些活大量走被限速的矩阵乘。知乎
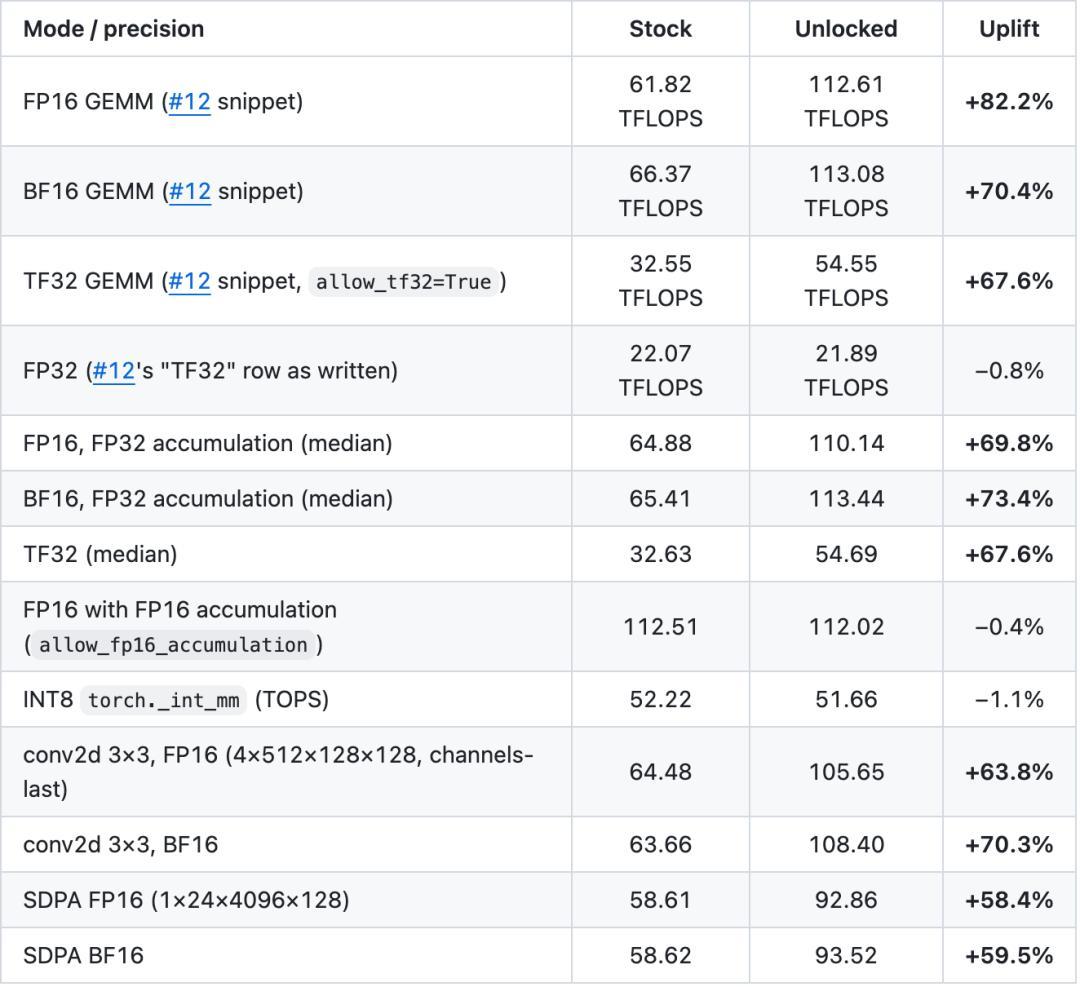
项目说明给的区间是:图像/视频生成提升14%到75%,LLM预填充最高19%,逐字生成约5%。 公开实测里也有反例。一张4070 Ti SUPER跑ComfyUI,整条工作流只快了5.3%。GitHub知乎
四张4090 48G改卡做FP8量化推理,PR只涨约10%。 同一张卡,换个任务,收益能从“翻倍”掉到“聊胜于无”。哔哩哔哩
所以先别急着插U盘。手上是30系、平时在Linux里跑FP16/BF16训练或SDXL出图、卡也过了保,这类人最容易吃到肉。攒了几张二手3090跑本地模型的,收益更直接。
只打游戏、用Ollama或llama.cpp跑量化模型聊天、手上已经是50系的,基本可以关掉这个页面。50系不在支持列表里,项目作者说防护比预想严,暂时看不到支持的时间表。
代价也要写清楚:要关Secure Boot,或者自己给EFI文件签名。 U盘版每次冷启动都得重来一遍;20系和40系的实机样本还不如30系多;黑屏、进不去系统、多卡掉线都有人报告。知乎
保修大概率不认。有外媒提醒,保修期内的卡要做好被拒保的准备。项目才上线一周多,作者自己也在收集失败案例。这不是一个“装完就忘”的工具。
它赶在一个显卡涨价的节点。10月底,华强北商家说RTX 5060两周内从3000元站上4000元。 11月第一周,渠道又传出提价,RTX 5080上调2500到2800元,5070上调600到900元。第一财经知乎
新卡越卖越贵,旧卡被锁住的那部分算力就显得扎眼。但别把顺序弄反:先看自己每天跑什么,再决定要不要折腾。
为了一个跑分数字去买二手3090,很可能买回来的是一张电费和噪音都更高的卡。
英伟达没有解释,为什么消费卡的这条路径只有半速。项目作者的说法是市场细分:想要满速,去买贵几倍的专业卡。这个解释没法证实,但几个寄存器值确实能被改写。
比“白捡性能”更值得记住的是另一件事:你买到手的算力,有一部分是出厂时用软件关掉的。下一次为涨价买单前,至少先弄清自己需要的是哪一半。