你囤的不是电子书,是几百张"书的照片"。扫描PDF里的文字本质是图片,手机上没法读、不能划线、不能检索。丢进手机或墨水屏的小尺寸里,固定版式还会乱成一团。小红书上有人求助"到底怎么把pdf转成txt",115个赞、44条评论在陪着崩溃;更多人惦记的是——AI现在连这活儿都干不了吗?微博小红书小红书小红书
能。这个秋天,书虫们实际跑出了三条洗书路。
路线一:微信读书直接导入PDF,最省事。9月有人晒出扫描书导入效果:正文被识别、排版干净,连朗读、繁转简都能用,原帖292个赞。但评论区马上补上真相的另一半:"我导入的正文和脚注混成一坨。"连发帖人自己都测出了边界:脚注多的无法识别,效果有偶然性。微博
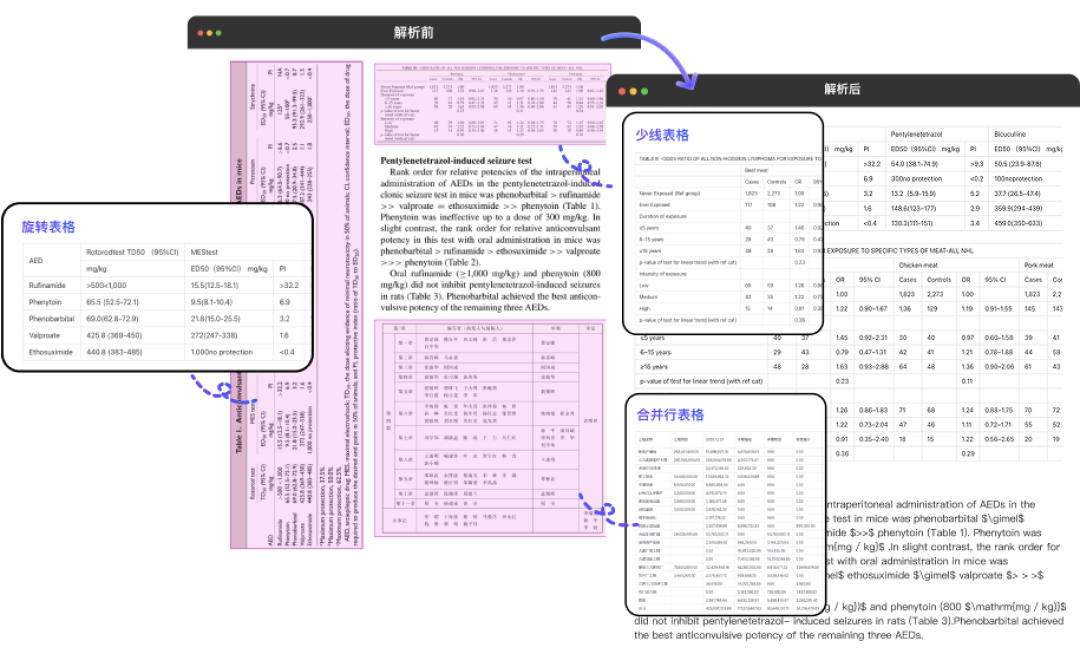
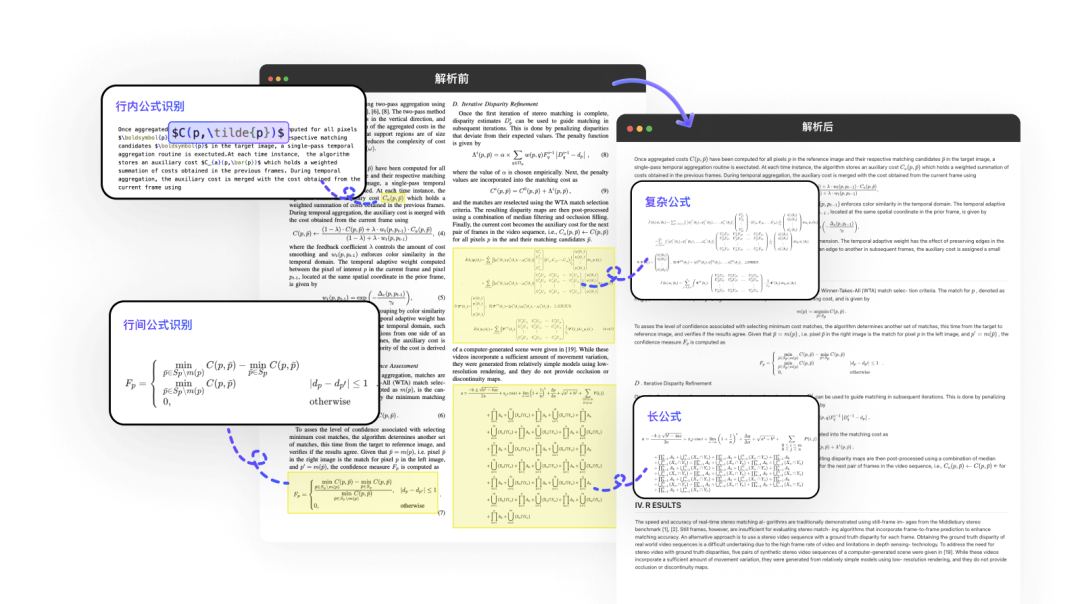
路线二:本地开源工作流,最稳。小红书有人晒出一套开源工作流:PDF丢进去直接输出带目录、可跳转、图片全保留的EPUB,一本书400页一般30分钟就转完了。全程本地跑,书不用上传云端。作者和评论区也划出了能力边界:普通排版"基本全对",复杂排版卡在跨页衔接;数学物理公式在多数墨水屏阅读器上难显示,换成支持JS的readest这类才稍好。注意,MinerU、PaddleOCR识别虽准,输出却只有md/json,离EPUB还差一步转换。小红书小红书
路线三:AI Agent洗书Skill,最新潮。10月1日一条254赞的帖子:扫描PDF拖给Agent,一句话转成EPUB,导回微信读书再用固定字体"骗"过识别,划线、夜间模式都能还原,工具已开源。不过另一个人用Codex复现时的吐槽很真实:“文字排版总是很糟糕”,最后还是自己搭的流程。能用,但要准备好自己收尾。微博小红书
动手前,4个坑收好:
复杂排版=重灾区:脚注、跨页表格、公式最容易翻车,要有"洗完了还得修"的预期;
时间即成本:一本书半小时起步,如果它家有正版电子版,先比个价再决定值不值得动手;
格式不对口:OCR成品多是md/json,转EPUB那一步别漏;
只洗你有权持有的书:最近流传的"10万本免费书库"帖子,看看就好,别下载别传播。微博
一句话选型:手机党先试微信读书导入,追求稳定走本地工作流,本来就在玩Agent的直接上Skill。双11刚收墨水屏的朋友,建议先学会洗,再疯狂买——设备不贵,读不了书的憋屈才贵。