10月24日到26日这三天,把知乎、小红书、B站、微博按“Agent 开发”关键词翻一遍,会有种一夜之间字典被重写的感觉:提示词工程刚听懂,上下文工程(Context Engineering)还没背熟,现在带头的新词变成了 Harness。
先看数据面。B站一周内“Harness”词条返回的40条视频里,约35条是 DeepSeek Harness(社区叫 DSH)的安装、插件、皮肤教程;小红书一条“每天一个名词解释:什么是 Harness”969赞、861收藏,一条“Harness 的6层结构”也拿了702收藏。 微博上南风窗10月20日发的那篇“为什么AI越来越聪明,我们要付出的学习成本,却越来越高?”也拿了上千赞。 但知乎是完全相反的景象:高赞文章标题直接写着“那些让人头大的Agent术语(Skill、Rule、Loop、Harness…):一切,都是为了让LLM好好干活”。 Google官方Harness课被搬运过来,评论区问的是“这词到底是什么、和Context工程差在哪”。教程供给已经饱和,概念解释还在补作业——供给端和内行,对同一批词的判断是反的。小红书微博知乎
这篇不教安装、不卖焦虑。对已经会搭RAG、接过工具、跑过OpenCode或DSH的中级开发者,这轮新词潮只需要看懂三件事:一张地图、一张分数表、四条脚注。
第一,词是新词,活是老活:Harness只是把“模型外面那一圈”单独立了账
现在被引用最多的一代际切法是:提示词工程管话怎么说,上下文工程管让模型看到什么,Harness工程管模型在什么环境里可靠干活。 知乎上流传的《大厨、厨房与餐馆》更直接,原作者用这个比喻“层层剖析了 Interface、Harness、MCP 与 Agent 之间的边界与关系”,而这词在海外技术圈“引发了广泛的讨论与争议”。知乎知乎
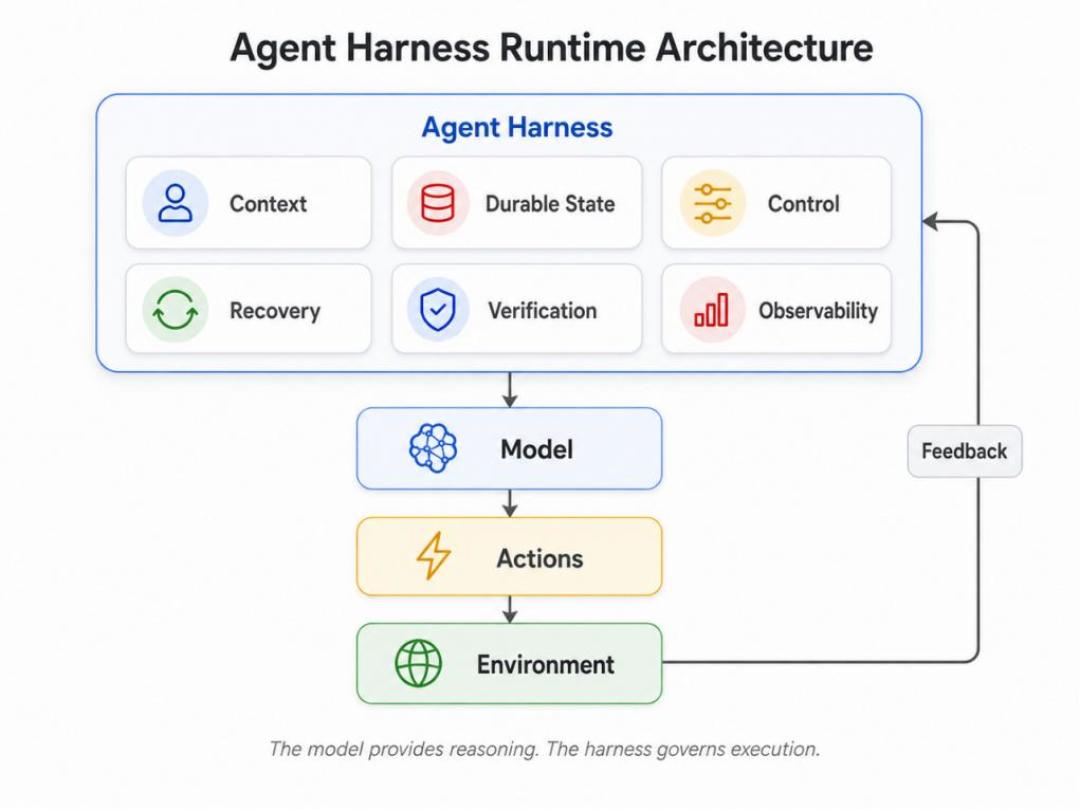
听着玄,但把Google论文对harness的官方拆分打开看,就是八个文件:系统提示词、护栏、记忆、工具指南、子智能体、技能、脚本、插件中间件。 只要你在项目里改过AGENTS.md、裁剪过工具描述、拆过记忆分区、建过skill文件夹,你就已经在做Harness工程了,只是没人给它开过发票。这也是为什么Google官方课(context and memory那套四件套)对老手是复习、对新人是预习。 入门第一步不是背名词,是把名词映射回你碰过的对象。36氪小红书
第二,为什么这一层突然热:有人第一次把“不动模型、只换外壳”做成了带分数的表
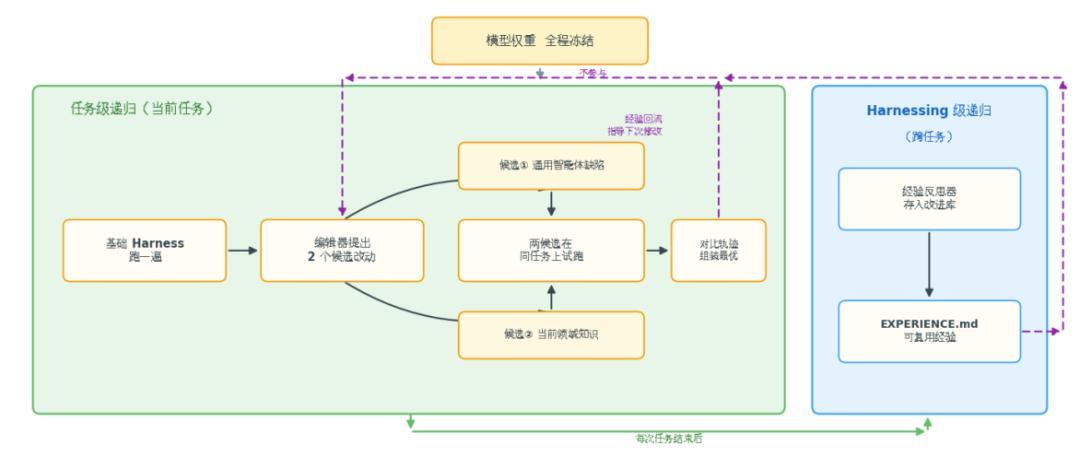
10月9日,Google Cloud AI Research和西北大学的论文《Harness²: Recursive Agent Harnessing for an Open World》挂上arXiv,10月19日36氪报道的标题很直白——不改权重也能变强,让智能体自己改自己的“外壳”。 数字值得抄下来(全部来自论文自测、取三个基准的最大值,不是每道任务都涨):36氪
GLM-5配OpenCode执行器,WorkBuddy-Bench单步优化从64.2跳到75.7,+11.5分;
Gemini 3.5 Flash在代码/网页/办公三个领域分别到80.8/78.3/83.4,比基础配置+7.4~+9.4分。知乎
Harvey法律基准LAB部分通过率+11.8个百分点;论文自测里四组模型-执行器组合全部提升,无一例外。36氪
最有意思的是“弱者收益更大”:GLM-5经过一步优化,反超了未优化的Gemini 3.5 Flash默认配置。 翻译成人话:模型能力只是下限,外壳质量决定你摸得到多高的上限。36氪
同层信号是成簇的,不是孤例:清华×智谱的HarnessPro让Agent分析自身执行轨迹不断修改和优化Harness,“同时提升任务成功率、降低执行成本”。 arXiv的Self-HPO交替改外壳和训策略,“在三个编码基准上,该框架把平均解决率从57.8%提升到64.8%,且收益可迁移到分布外任务”。 往前还有斯坦福Meta-Harness、谷歌自家只改记忆的ReasoningBank。社区侧同步热闹——有UP主实测,“GitHub上搜这个名字能搜出一百二十五个仓库,头部竞品一百七十多颗星”。 学术密集和教程饱和同时发生,才是一个词真正热起来的完整信号。知乎B站B站
连“用RSI训模型”都开始出产品:10月22日田渊栋创业公司Recursive开源首个模型Flint,“总参数400亿,单个token生成只激活25亿”,搭配优化后的推理引擎“在MacBookPro上能跑至少125tokens/s”。 这个方向从一篇论文变成一条赛道只用了两个月,名字都起好了:递归自我改进(RSI)。36氪
第三,分数表下面有四条脚注:看完再决定跟不跟
这是和搬运号拉开差距的地方,论文自己写了。
脚注一,成本翻倍。 改外壳靠“提方案—试跑—比行为差异”(Propose-Probe-Compose),整个过程不需要标准答案,靠对比行为差异来判断哪个改动真的有用。 代价是每个任务要多跑几遍,token成本和延迟都上去,做实时场景的暂时享受不到这张表。36氪
脚注二,改外壳的质量取决于“改它的模型”有多聪明。 编辑器默认是Claude Opus 4.8——对,谷歌的框架用Anthropic的模型当编辑器。 Harness优化不是免费午餐,它把成本从“训练”挪到了“执行”。36氪
脚注三,官方免责声明。 论文写明这不是谷歌官方支持的产品,不享受漏洞奖励计划。 框架会自动改写执行环境周围的文件,沙箱得你自己配。36氪
脚注四,最大值≠平均数。 这些数字是不同配置下的最大值,不能理解为每个模型、每类任务都会提高同样幅度。 论文自选的三个基准和真实世界的脏活累活之间还有距离,WorkBuddy-Bench这类基线能不能被社区搬进真实业务,是下一步的验证题。知乎
名词本身也要打个折:去年Context Engineering也被喊成共识,今年已经需要一句“三代术语切法”的科普来划清边界。词的半衰期短,对象的半衰期长——为名词下注,是最容易后悔的那种学习。
看完三件事,三类人分别怎么办
新手/转行:别先背课里的名词。动手搭一个能看见的harness:写一份AGENTS.md、拆一次工具描述、跑通同一任务,搭完再回头看厨房比喻,全懂。B站那35条DSH教程里挑一条跟着跑完就行,教程不需要集邮。
已有在跑Agent的中级:装任何新框架之前,先跑一次民间版Harness²——固定同一个执行器,换两套系统提示词+记忆分区跑20条任务集,看分数差。差距小,说明你的外壳已经成熟,这轮新词焦虑可以关掉;差距大,那不动权重只换外壳,就是你今天最便宜的一笔投入。
带团队的:注意成本结构在变——微调要数据、算力、周期,改外壳只要几次试跑;当“换壳收益”被论文连续验证,模型的差异化优势会被外壳层进一步压缩,采购还是自研的口径需要重调。
下一步的观察信号:社区版WorkBuddy-Bench这类基线能不能被搬进真实脏活累活;像DSH这种把外壳彻底打开的产品,其“一切皆插件”的核心设计理念,就是从模型、工具到最核心的AgentLoop,都拆解为可独立、组合的插件。 它会不会直接内置“自己改自己”那一层,值得盯。钛媒体
最后说个细节:小红书那条“Harness 6层结构”被收藏700次,但评论区问得最多的是一句“这跟Context工程有啥区别”。这个问题本身就是答案——当一层东西被拆开单独计价,名词必然通胀;而你自己搭过的那部分,永远不需要名词解释。你的Agent实测过这种账吗:同一个模型,换个外壳,分数能差出多少?评论区报个数,名词解释就不必了。