连研究AI幻觉的人,都被假文献唬了一把。今年5月《柳叶刀》刊发"AI引文造假"通讯后,《每日经济新闻》专访牵头人Maxim Topaz——这位哥大副教授、全球前2%顶尖科学家讲了亲身经历:他明知AI有幻觉,写评论时特意核对了所有引文,期刊编辑还是揪出一条AI"悄悄植入"的假文献。他后来说,比失误本身更值得警惕的是:连常年和AI打交道的专业人士都会中招,普通研究者更难幸免。中国新闻网
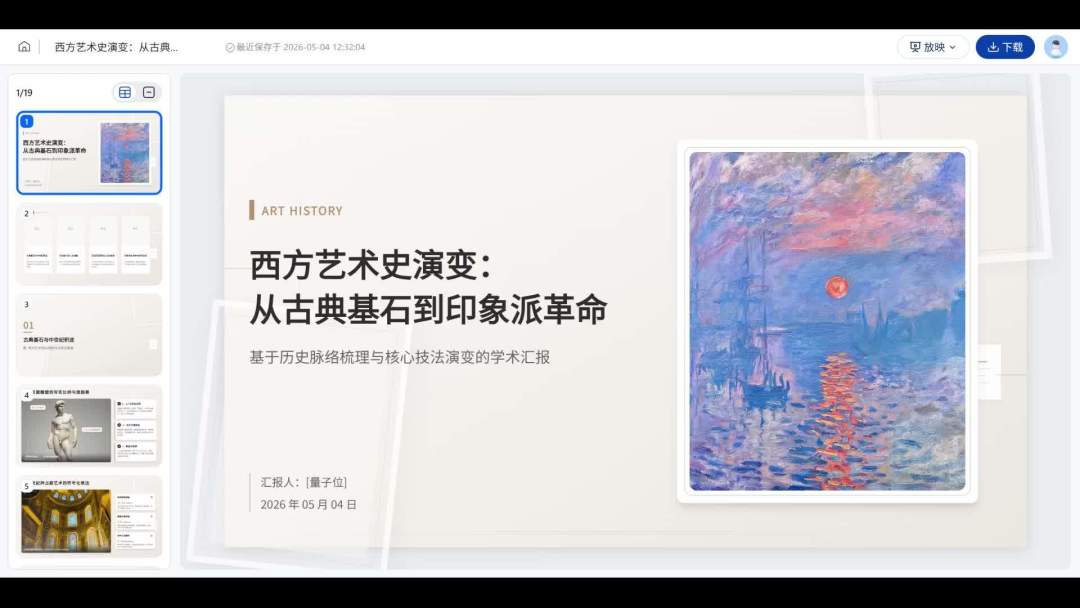
开学这两周,你多半正在干类似的事:几十篇PDF丢给AI文档助手,让它替你读、替你综述、替你排版——一句话下去,一份19页带图的学术汇报就躺在编辑器里,封面连世界名画都配好了。
AI读得又快又顺,参考文献列表期刊名对、年份对、连DOI都配齐。问题是:这份"顺",是2026年最危险的信号。
一、1.25亿条引用摊开数了一遍
这次审计的规模此前没人做过:2471758篇开放获取论文、超过1.25亿条参考文献,时间跨度2023年1月至2026年2月。结果摊开是几行数字:中国新闻网
识别出4406条编造的参考文献,分布在2810篇已发表论文里;
生物医学文献的假引文率,从2023年每万篇约4条涨到2026年初的每万篇56.9条——两年12倍,拐点和AI写作工具普及的时间严丝合缝;
综述类文章的编造率比其他文体高57%。知乎
第三条是对着文献综述党来的:你让AI替你综述时那个"我没读过但看着相关"的引用区,恰好是全数据库造假密度最高的文体。
更冷的一条:截至今年2月,查出含假文献的论文里超过98%无任何出版方处理——没撤稿也没勘误,继续被检索、被引用。“它被收录了"和"它是真的”,是两件事。知乎
假文献难发现,是因为AI编的不是胡话:格式正确、主题具体、署的是真实研究者、日期合理,唯一破绽是点进去论文不存在——而审稿人通常不点。极端样本:某论文30条引用18条疑似编造,照样发表。Retraction Watch的联合创始人Ivan Oransky,一个追踪撤稿的人,去年11月被AI"署名"进了一篇虚构参考文献。追假文献的人,自己被假了一次。知乎
二、"我没遇到过"为什么不能当结论
知乎那个78万浏览的回答说,20年刚开始用ChatGPT时会遇到编造参考文献,24年以后再也没有遇到。这条观察不算假:带检索的工具多了,凭空造文献的体感确实在降。但风险没消失,只是换了形状——变成三个更难逮的版本。知乎
1. "半真"引用。 西北大学学者Mohammad Hosseini批评这个审计只摘了"低垂的果实":真正的大头是真实存在、但不准确、有偏、不完整的AI生成引用——"我们连检测都还做不到。"文献是真的,但它撑不撑得住你转述的那句话,没有工具能替你判断。知乎
2. 数字错配。 9月7日一篇实践专栏(作者自述发布前经人工核对)讲过一个对账案例:一份材料说"覆盖三千二百多人",另一份说"查过两次的三千二百多人",看着同一个数,中间差着九百——根子是把记录条数当成了检查次数。两边都没算错,错在两个数说的不是一件事。AI不会替你想起问这一句。知乎
3. 把推断写成事实。 小红书4717赞、7577收藏的"用AI读论文两年半"热帖,它的12问prompt里专门加了一条硬性要求:严格区分"论文明确声称的、已有文献结论的、基于证据的推断、仍不确定的猜测"四类信息,“不要把推断写成事实”。深度用户最后防的,还是AI把猜测讲得像原文。小红书
这三样,没有一样会像"搜不到的文献"那样给你报错。它长得全对,读着也顺。
三、产品化越顺滑,交付前越要人核
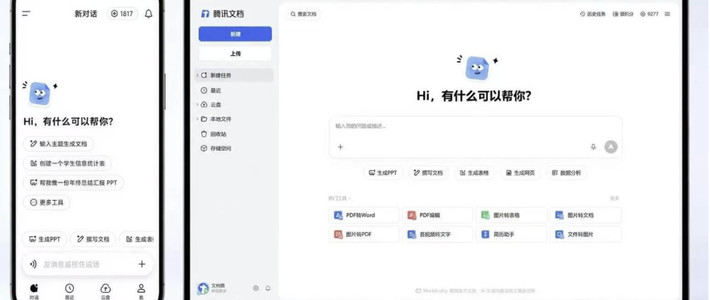
这两年国产文档AI收敛成了两种形态:一种是嵌在办公软件里的——WPS把AI直接放进工具栏,腾讯文档的AI入口把"生成PPT、撰写文档、PDF转Word"排成一排,底下标注"AI生成内容请谨慎参考";另一种是任务代理式的——讯飞智文这类产品,一句话下去,二十来页带大纲带配图的汇报已经排在左侧。
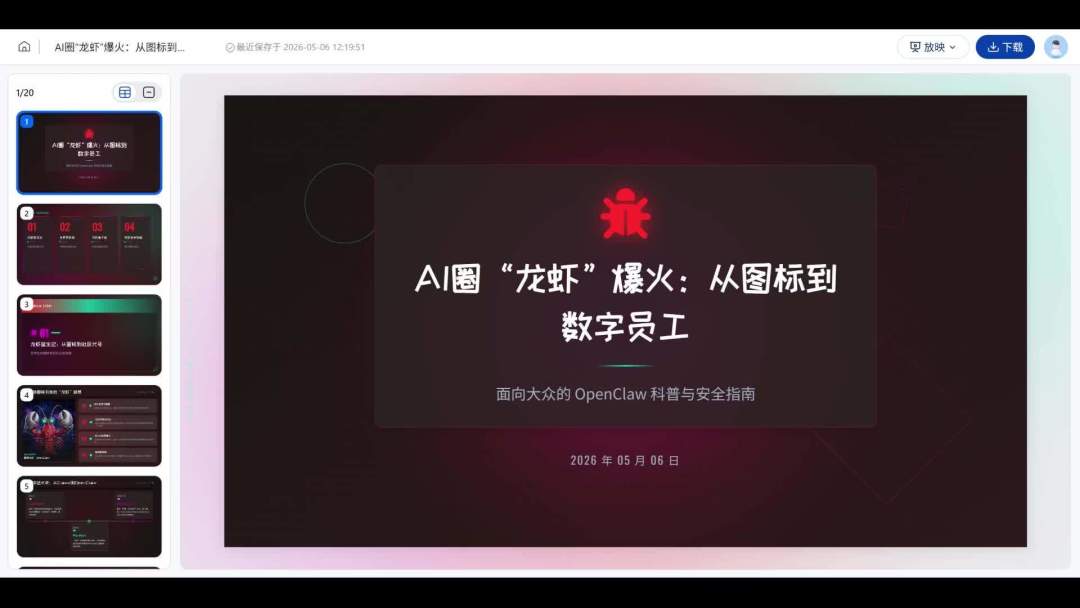
界面越顺手,风险就越往交付那一刻集中。今年7月6日,PNAS挂出撤稿声明:一篇去年9月底上线、讨论衰老大脑脑膜淋巴结构的评论文章被撤回——作者承认用Microsoft Copilot把粗略引文整理成格式化的参考文献列表,提交前没核实;文章的图1也是生成式AI做的,违反期刊政策。从发表到撤回,不到十个月。这是《美国科学院院刊》首例"AI编参考文献"撤稿,更是信号:撤稿理由正从"数据造假"这种重罪,降到"你没核过AI给的东西"这种本该人人会做的功课。新浪微博
别等编辑部替你核。上面那篇"核实过上百条"的专栏定了三条规矩,结合热帖实践,压成今晚可用的版本——
一查文献(抽验,不是全验)。 拿到带引用的AI结果,先抽2-3条,标题贴进PubMed或谷歌学术:标题、作者、期刊、年份四项全对上才算数。依据是专栏观察:"模型开始编的时候,往往一整批都在编,不会只编一条。“抽验全对,这批大概率能用;一条对不上,整批存疑重做。这比"花三小时核查AI三十秒写完的东西"省一个量级——实测五款国产AI写综述的知乎作者,原话是"心态崩了”。知乎
二追数字。 关键数字问一句"出自哪份数据、哪个版本、哪一页",答不到出处的当它没说过;前后出现的同一个数,对账。公认经典也一样——专栏原话值得抄在便签上:被引用得多,说明它重要;核实不到,说明它暂时进不了你的稿子——这两件事不相干。知乎
三看诚实。 让AI把没依据的判断标成"待验证",不许包装成定论;数据撑不起的,白纸黑字写"做不了"。AI产出可不可信,先看它敢不敢说自己做不了什么。
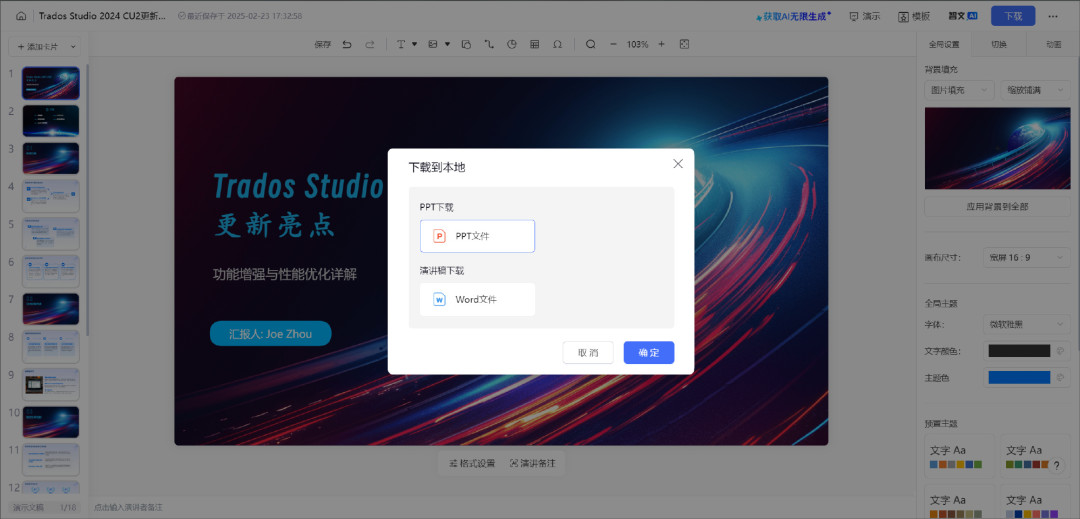
点"下载"之前,这三关跑完——下载出去的东西,很快就不只是你一个人的事了。出版方已经在集体动:Taylor & Francis投入了专职人员和筛查技术,含疑引用超过一小部分、或明显影响稿件完整性的,通常直接拒稿;PLOS在评估"全系统引文完整性筛查";Topaz团队建议把自动引文核验直接嵌进投稿流程、放在同行评审之前(AI初筛加人工校验,准确率91%)。中国新闻网
这条路眼熟吗?先是查重,然后是AI率检测,现在轮到引文。每一道都从自觉抽查开始,最后变成系统前置。等导师或编辑部拿着核验报告找你时,问题只剩一个:你核没核过。
国内也在发生:8月中旬,微博出现"豆包虚构DOI、虚假文献"的舆情整理帖。有意思的是那几篇时间线帖本身——正文是微博智搜生成的。连"讨论AI编文献"的内容都是AI写的,受害者名单你也得核。新浪微博
四、最后:按场景分个流
闭卷(上传PDF让它读)相对安全:文献不会凭空多出来,但页码跳错、数字抄串、推断冒充原文照样发生——引用前回到那一页看一眼,就一眼。
开卷(直接问它"这个方向有什么文献")危险区:检索增强只是降低、不是消除凭空造文献,出来的每一条默认待验,综述、研究现状这类"帮你想到你没想到的"任务尤其。
结论文句(AI替你归纳领域共识的那句话):AI只配给结构,引用点和落点自己补——“这条文献到底支不支持我这句话”,查重、AI率、引文核验三道门加起来仍然是空的那一格,永远只能作者自己回答。
今晚的动作:把最近一次AI给你的文献清单翻出来,随机抽两条去搜标题。习惯这个动作,剩下两条规矩自然跟上。接下来值得盯的信号:你投稿的系统里,有没有长出"引文核验"这道新关口。
评论区聊聊:AI给你编过最离谱的一条"参考文献"长什么样?知乎同名问题下面,已经有人的豆包把查不到的文献"重新发明"了一遍。