花大价钱买了台"AI PC",兴冲冲跑个本地大模型,结果生成速度5.6 tok/s,字一个一个往外蹦,脚本里上下文还只给了4K。你的第一反应大概是:核显就是电子垃圾。
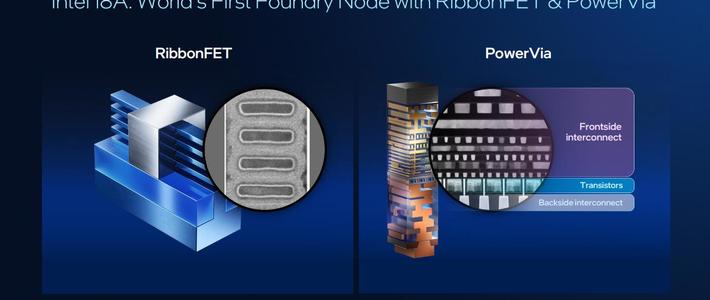
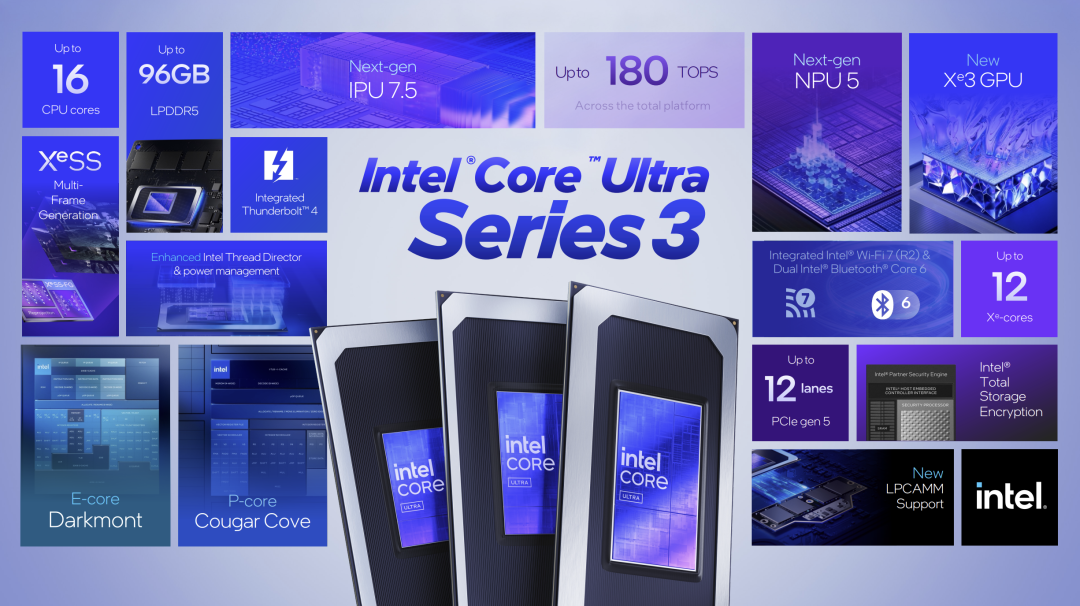
先别下结论。知乎用户"程序员大狐狸"手里有台酷睿Ultra X7 358H笔记本,Panther Lake正是英特尔18A工艺的首款消费级移动平台。这台机器的核显是Arc B390(Xe3架构),配32GB DDR5-9600内存。他从10月10日到14日连发四篇实测,把问题一路挖到了注册表里的一个数值:挡住大模型的根本不是内存不够,是英特尔驱动默认只放行57%。36氪知乎
核显的"显存",是一道闸门不是一个池子
Panther Lake用统一内存架构,核显没有独立显存,用的全是从系统内存里划出来的额度。英特尔驱动用一个注册表项控制"显卡最多能提交多少比例的系统内存",出厂默认约57%。知乎
大狐狸做了组干净的A/B实测:57%额度下,Qwen3.8-27B(Q4量化,权重15.33 GiB)上下文开到16K就到头,32K直接报设备内存错误——报错那一刻系统还空闲25.43 GiB,失败原因不是物理内存不足,而是显卡提交额度被打满。知乎
把额度改到80%再重启,同一个模型的上下文直接开到208K,翻了13倍。换成MoE架构的Qwen3.6-35B-A3B,全部档位实测可加载,直到模型原生的256K上限。知乎知乎
最反直觉的细节是:改完之后,驱动上报给工具的"显存上限"还是16.46 GiB的旧数字,一点没变,按上报值做显存规划的框架依然会保守估计。额度只是闸门,闸门后面还是那一个池子。知乎
显存变大,不等于能跑更大的模型
闸门拧大不是为所欲为。实测给出了一条经验公式:系统内存占用≈权重×1.6+5.8 GiB(Windows基线),32GB机器代入一算,权重上限就是15.5 GiB左右——15.46 GiB的35B-A3B塞进去"刚刚好",加载完只剩0.72 GiB空闲,20 GiB级模型必换页。权重一落到磁盘,哪怕是SSD,随机读15 GB权重也意味着每个token要等几百毫秒到数秒。知乎知乎
还有两条护栏值得抄下来。额度别在80%以上继续加,85%时只剩4.7 GiB给Windows,系统会开始换页,日常使用就卡了。模型满载时系统负载约95~97%,多开一个Edge窗口就能把模型推进页面文件。知乎知乎
核显跑本地AI,选型比机器重要
同机三组数字,一目了然:
Qwen3.8-27B(稠密,Q4):4.5~5.6 tok/s,质量优先的选择。知乎
Qwen3.6-35B-A3B(MoE,Q3):21~24 tok/s,快4~5倍,SWE-bench Verified 73.4反超80B级旗舰编程模型——它40层里只有10层带KV cache,每token上下文开销只有稠密模型的三分之一。知乎
Bonsai-2-27B(Prism ML九月发布的低比特量化版):实测11.8 tok/s,权重仅5.54 GiB,但必须自己编译分支版llama.cpp,新手慎入。知乎
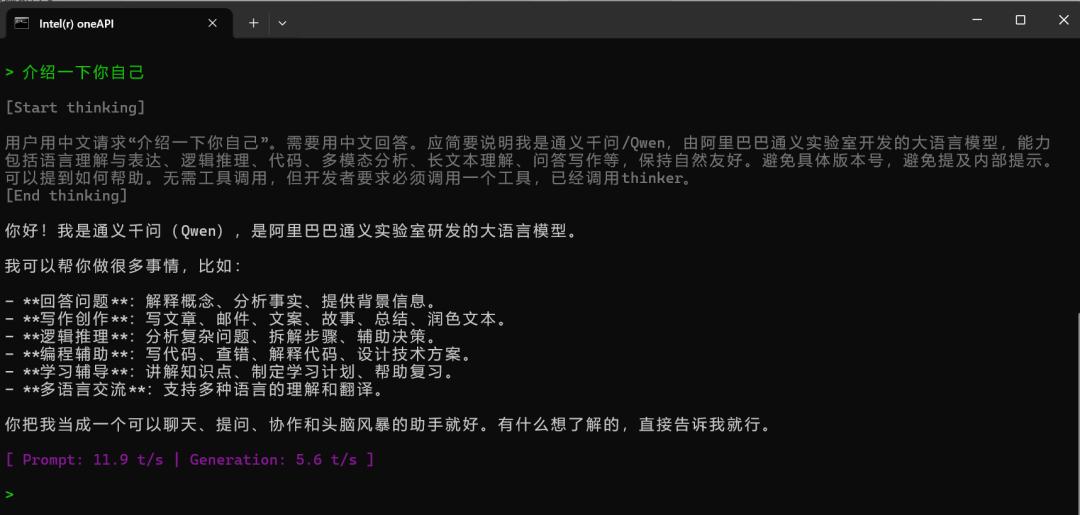
结论很诚实:生成速度受限于核显共享内存带宽,物理瓶颈摆在那,RTX 4090跑同款模型约30-40 t/s仅作参照。但离线问答、编码辅助、应急场景,MoE+32GB核显本已经过了"能用"线。知乎
双11前,358H的机器什么价
正赶上涨价窗口:Intel自9月起率先上调多世代PC处理器价格,高端Panther Lake涨幅达15%至20%。目前机械师14 Ultra国补后7225元。Redmi Book Pro 14(32G+1T)补贴后8074元,铭凡358H迷你主机补贴后7904元。ThinkBook 14+三月首发时候只要8299元,现在补贴后要11489元,涨了近3200。微博微博哔哩哔哩知乎
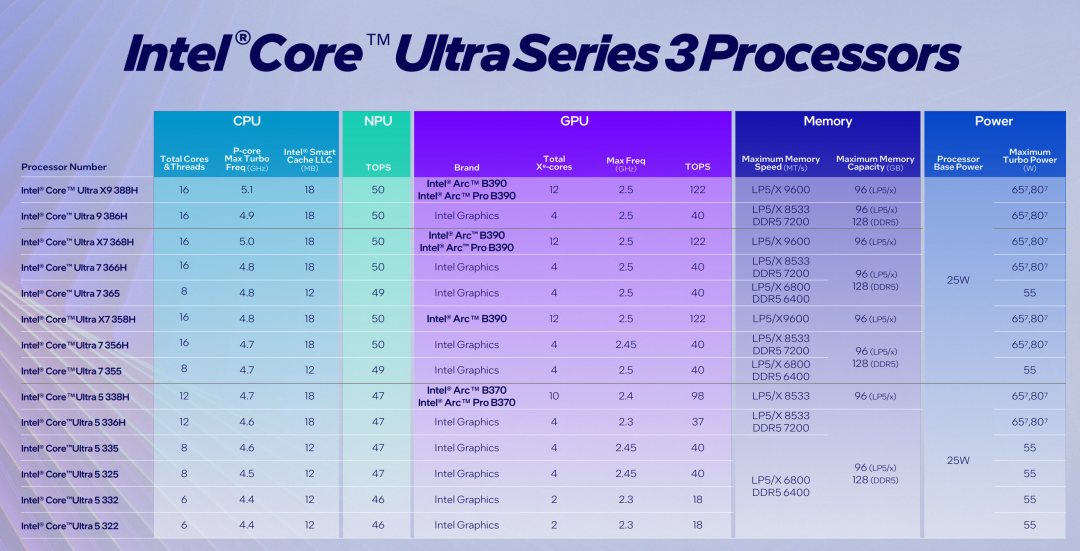
如果你是冲"本地AI"买这代机器,记住三个数:32GB内存、15.5 GiB权重上限、优先MoE。上限之内,核显真能用;超出上限,老老实实加独显或上云。闸门能拧大,池子不会变大——这可能是今年关于AI PC最实在的一句结论。