过去一个月,华为的AI芯片昇腾在大模型圈子里接连拿到了“排面”:9月30日,DeepSeek官宣开源面向昇腾算力平台的基础组件。10月20日,连自家线上在用的生产级推理框架DeepInfer也放了出来,昇腾在首批支持名单里。10月23日,MiniMax开源M3.1Flash模型权重,“Day1接入”名单上也站着华为昇腾。有人总结得直白:以前是大模型排队适配英伟达,现在是英伟达和华为昇腾一起被摆上桌。微博36氪知乎36氪
热闹是真的,但到底哪里真,咱们掰开看。
第一本账:这次开源的,真是“看家本领”
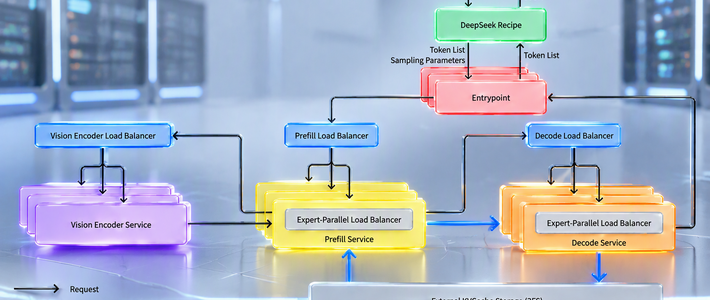
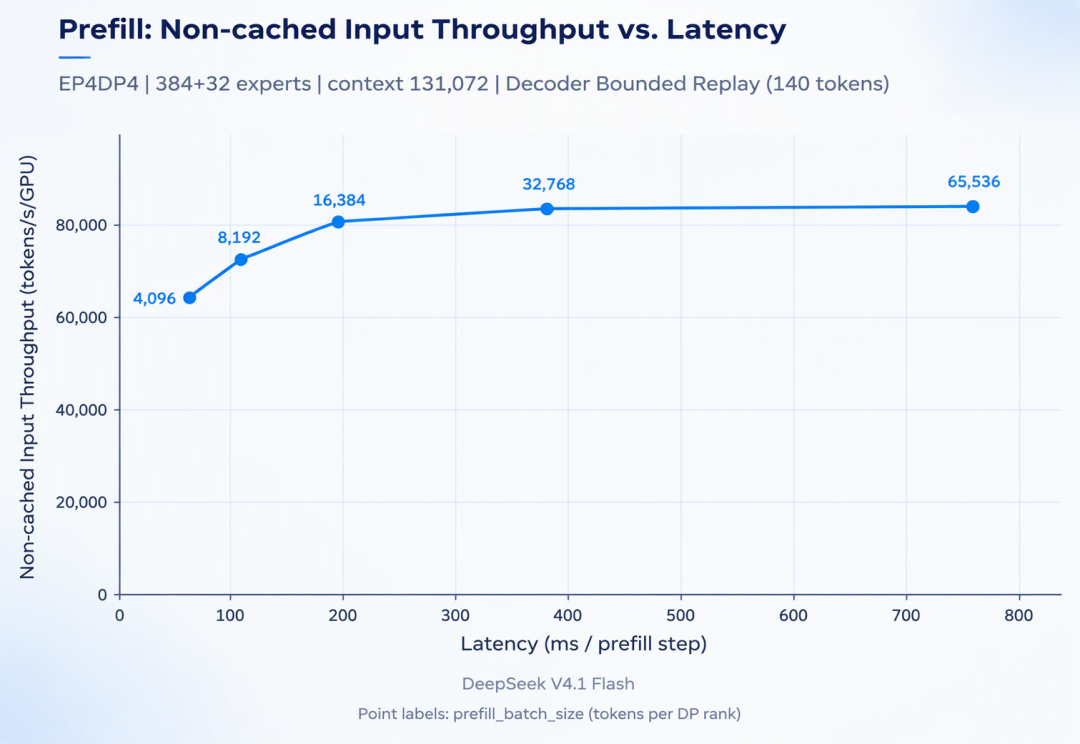
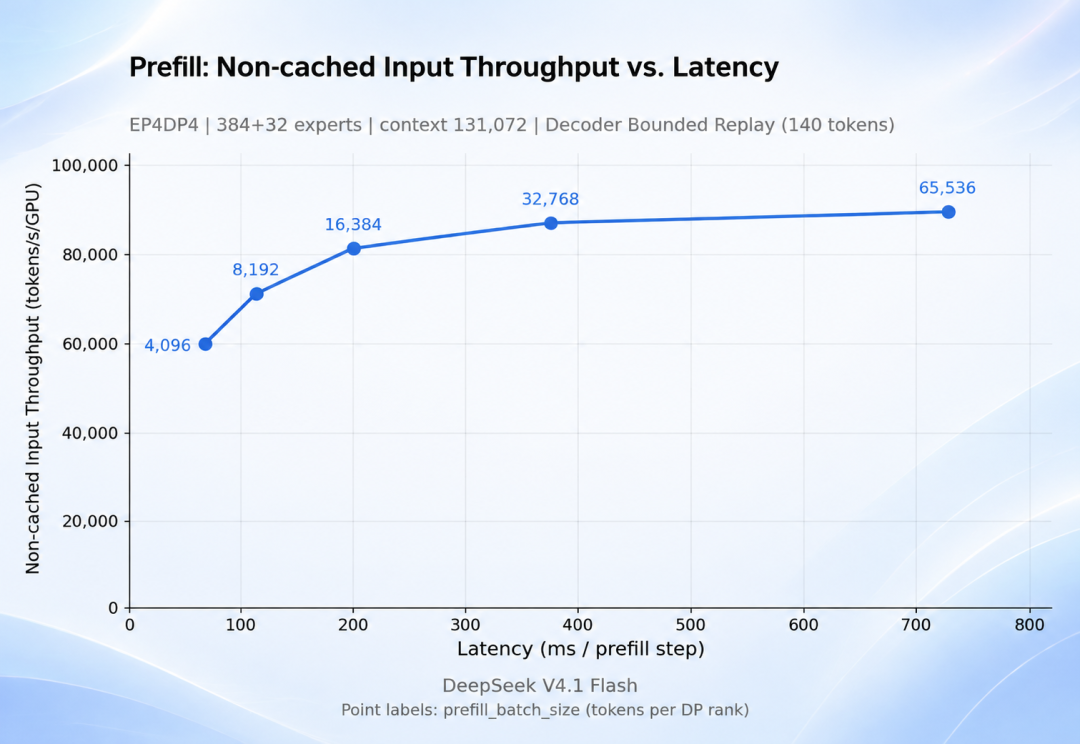
开源模型权重见多了,开源生产级推理框架的很少见。DeepSeek刚放出的DeepInfer,就是它线上真跑V4.1 Flash大规模服务的框架:单集群日吞吐155万亿Token,按谷电价算每卡每小时收入38美元。里面的招很实在——Prefill与Decode分开部署,SWA重算让整体Prefill计算量接近减半,投机解码用动态验证换来约4%—7%的吞吐提升。仓库给了两套构建入口:英伟达走CUDA 13,昇腾走CANN 9.2,整体按Apache 2.0开源——意思是:想私有化部署的团队,可以照着官方全套经验抄华为芯片的作业。36氪知乎
第二本账:“排队”背后,是推理成本的生死竞赛
MiniMax开源M3.1Flash是同一个逻辑:据官方披露,模型上线72小时已为真实用户处理超过100万亿Token。API输入价压到每百万Token 1元——芯片厂抢着适配不是做慈善,大模型竞争的主战场已经从训练转向推理,谁先把算子、框架、编译链调顺,谁就拿下一轮的入场券。36氪
华为自己最近也在交底:轮值董事长徐直军在全联接大会期间对外表示,昇腾在中国市场份额已超过英伟达。同期高通与华为达成多年期专利协议,开始给华为交专利费。微博微博36氪
第三本账:三处别脑补
不是“抛弃英伟达”:DeepInfer的硬件入口从一开始就同时包含英伟达SM100与昇腾950,昇腾拿到的是“平等待遇”,不是“独家婚约”。知乎
开源的是核心,不是全部:KVCache管理和负载均衡因与内部基础设施耦合较深尚未完整开源,自建完整在线服务仍要补作业。36氪
份额反超有前提:出口管制是重要推力,单卡性能差距仍在,昇腾产能也还紧张——徐直军自己的说法是“满足国内市场需求还远远不足”。微博
跟普通人有啥关系?昇腾不会装进你的手机,但你手机里的AI跑在云上:推理成本降下来,鸿蒙设备上的AI助手、云服务和开发者接的API才会更便宜、更快,这是实惠传导到终端的路径。至于要不要为“遥遥领先”的叙事买华为产品加情绪溢价——按需求算,别按情绪算,10月9日华为nova 16系列还整体上调了200至400元。36氪
热度是真的,差距也是真的。“中国英伟达”还得过产能和单卡性能两关,现阶段对读者最有用的,是分清哪些干成了、哪些还没。