有家公司的客服 Agent 里塞了 12 个专家子 Agent。品牌调性对不齐,延迟还上去了。Datawhale
Anthropic 应用团队说,配好 Skills 的单 Agent,往往比复杂的子 Agent 架构更好用,成本和延迟也更低。
2026 年 10 月 22 日,OpenAI 和 Anthropic 几乎同时发布生产级 Agent 的工程实践。两边说的是同一句:企业 Agent 架构,普遍做复杂了。
先看钱。10 月起,埃森哲给员工每月 29 美元的 Claude 额度,超出记到项目账上。Ramp 的数据更直接:模型托管和推理支出里,99.5% 来自花钱最多的那 10% 的公司。AI信息Gap

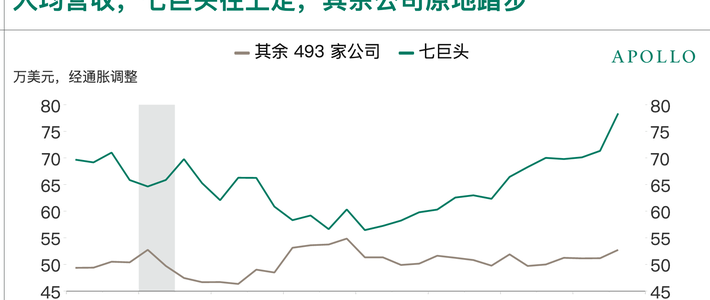
七巨头的人均营收从 2023 年初的约 56 万美元涨到约 78 万,剩下 493 家还在 50 万上下。模型买得起,卡住的是模型外面那层东西。AI信息Gap
OpenAI 的办法很土:派工程师进驻客户公司。一个半导体客户的驻场工程师此前没做过芯片设计,和客户一起搭评估体系,看 AI 能不能生成测试用例、诊断故障。
三到六个月,十几个用例上了生产。生成定向测试省下约 48% 的时间,内核优化带来 22% 的性能提升,几周的调试被压到几小时。再用 Codex 重构,定制代码砍掉约 90%。知乎
Anthropic 盯的是架构。中央编排器加一堆专家子 Agent,是最常见的画法。他们发现,模型够强后,渐进式披露加工具搜索的单循环往往更好,成本延迟都更低。知乎Datawhale

Claude Code 团队甚至把系统提示词精简了 80%。砍掉的内容改成需要时再加载。子智能体只留少数非它不可的场合,其余折叠回主循环。知乎
但同一周,另一批人在往反方向走。TrueFoundry 从开源 harness TrueForge 里总结规则:上下文是预算,沙箱是工具不是包装,只对不可撤销的动作设门。GardenSeed
14 个任务的 Enterprise-Bench 上,准确率与 Claude Managed Agents 持平,token 少约 62%,单次成本低约 28%。GardenSeed
华为开源的 Nexent 走得更远,把 harness 做成了配置。一个生产 Agent 就是一份 agent.json:提示词、工具、子智能体、max_steps、验证配置。客服宽松验证,财务严格验证加沙箱。AgentTeam2026
验证失败时它不抛异常,把原因写成 observation 注入下一轮,修不好就输出"受控失败"。AgentTeam2026
两边说的不是同一层。
OpenAI 和 Anthropic 在拆编排:谁调用谁、要不要中央调度器、子智能体怎么分工。这一层在变薄,因为模型自己越来越会规划、执行、检查。
TrueFoundry 和 Nexent 在加控制:模型能看见什么、能做什么、花多少钱、出错怎么停。这一层在变厚,活越重要,越需要外面有东西兜底。
Anthropic 平台工程负责人 Katelyn Lesse 说得更彻底:别把智能体关在盒子里,而是把"大脑"和"双手"分开,让它碰不到凭证。知乎
模型越强,控制越不能省。敢把重要的事交出去,才更需要一道能喊停的闸。

四件事。
第一,给每个子智能体找一个留下来的理由。能隔离上下文、能并行、能独占工具,才站得住。去掉它任务照样完成,就是多一个故障点。
第二,把不可撤销的动作挑出来,执行前设门。删库、转账、发邮件、改生产配置。其余步骤不必逐个审批,审批太密等于没有。
第三,验证失败别直接抛给用户,写成 observation 喂回下一轮。修不好就交受控失败,别让模型编一个像模像样的答案。
第四,评测看端到端。别报"组件准确率 95%“,报"这类任务完成率多少、单次成本多少”。
19 世纪末,工厂把蒸汽机换成电机,生产率几乎没变。直到厂房改单层,机器按物料流动重排,每台设备配小电机,效率才上去。AI信息Gap
换模型不重排产线,结果差不多。也别把 Agent 架构绑死在某个模型版本上。知乎
今天多的壳,明年可能就是负债。













