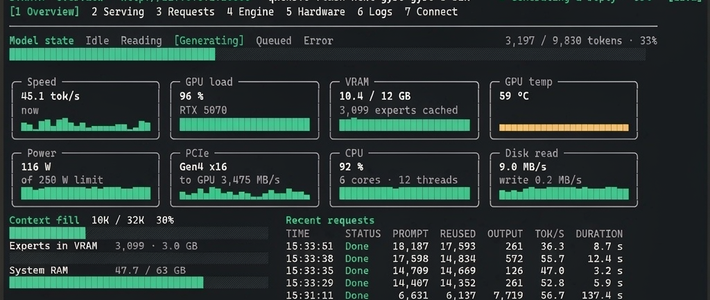
双11前的这三周,小红书上一条「12G显卡跑Qwen3.8 Flash,96 token每秒」的帖子拿了7800多赞、1.4万收藏。Strata 成了本地AI圈人人抄的新作业。但评论区反复出现的是同一批问题:“我64G内存只有8G显存,能跑吗?”“3060 6G呢?”“为什么UP主的速度我复现不出来?”小红书
这篇文章把没人算清的两张账单摊开:智商和内存。
为什么12G显存能跑千亿参数?
不是显卡变强了,是模型结构变了。Qwen3.8 Flash Next 是个 MoE:每层512个专家,每个token只调用其中10个。Strata 把全部专家塞进内存、按需捞进显卡——显卡是考生,内存才是题库。12G卡跑通的代价是:题库大小直接决定智商。GitHub
第一张账单:智商税,按量化档位明码标价
Strata 官方量化质量表里,对照 Q8_0 的逐位 top-1 一致率:Q2_0 只有80.6%,IQ3_XXS 84.46%,IQ3_S 87.69%,UD-IQ4_XS 88.91%,UD-Q4_K_XL 93.09%,Q6_K_XL 94.61%。哔哩哔哩GitHub
你看到的96t/s就是Q2_0档的速度——它吐字最多,也选字最错。低档位有翻车记录在案:官方 issue 里模型曾连续输出36,689个感叹号(#606),后续版本专门加了自动掐断机制。Coder 版本还留下了"中文答案会出错或循环、英文正常"的记录(#438)。中文重度用户,省哪档都别省到这档。GitHub哔哩哔哩
但也不必恐慌到非Q6不跑:IQ3_S 逐位选字虽然只有87.7%,官方规格表给它的定位却是"最慢,但最好——公开测试与满血版一致"。GitHub
真正的代价在速度:官方文档的实测表里,IQ3_S 档短上下文约53 tokens/s。同表 Q2_0 是94——智商税的另一面,是速度税近半。GitHub
第二张账单:内存预算,由文件大小反推
Q2_0 模型文件37.6GB,IQ3_XXS 47GB,IQ3_S 54.8GB,Unsloth 的高档位文件从93.7GB一路排到188GB。降档逻辑很直白:32G内存只配选最笨那档;想跑IQ3_S"满血",64G起步;要谈93%+的一致率,得128G级的机器。GitHub
反直觉的是:为速度加内存,是白花钱。B站UP主汇总的141份用户实测里,显存加内存之和与解码速度的相关系数只有0.13,基本无关。真正的大坎是显存16→24GB,提速73%;双卡提速1.2~1.8倍,第三张卡几乎零收益。内存决定你能跑哪档,显存才决定跑多快。哔哩哔哩
抄作业前,先校准预期
141份实测里,只有90份能算出解码速度。模型和版本还是混着统计的,UP主自己在评论区认账:“仅供参考”。你的3060、你的DDR4、你后台开着的其他程序,都藏在"其他"两个字里。所以别拿UP的数字做1:1复现预期,评论区最典型的追问就是"3060 可以吗 6GB"这种配置题。先对照自己的内存档位选量化文件,再自己实测。哔哩哔哩小红书
一句话收束:Strata不是免费魔法,只是把显卡的钱换成智商和内存来付——“快是真的,聪明是要付钱的”。96t/s是Q2档的速度,也是智商税的价格;双11买内存条之前,先决定你要跑哪一档。哔哩哔哩