同一个任务电费8分、API七毛:本地大模型为啥还有人劝退?
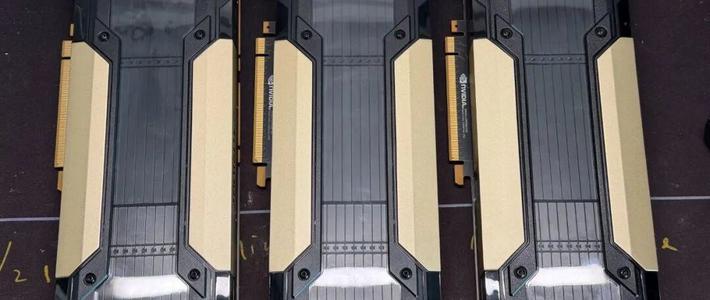
同一个任务:分析PDF→操控电脑登录邮箱→存草稿→传附件,500万token。B站有UP主拿计量插座认真实测了三张二手特斯拉计算卡(P100/P40/V100)跑这个Agent任务:P100用时25分41秒、电费不到8分钱;同样token走线上API约7毛;V100更狠,9分钟、不到3分。视频标题还很唬人——比API便宜17倍,劝你别入坑的恰恰是他自己,评论区近300人凑过来一起算账,这可能是最近几周最热闹的一堂"本地大模型部署课"。哔哩哔哩
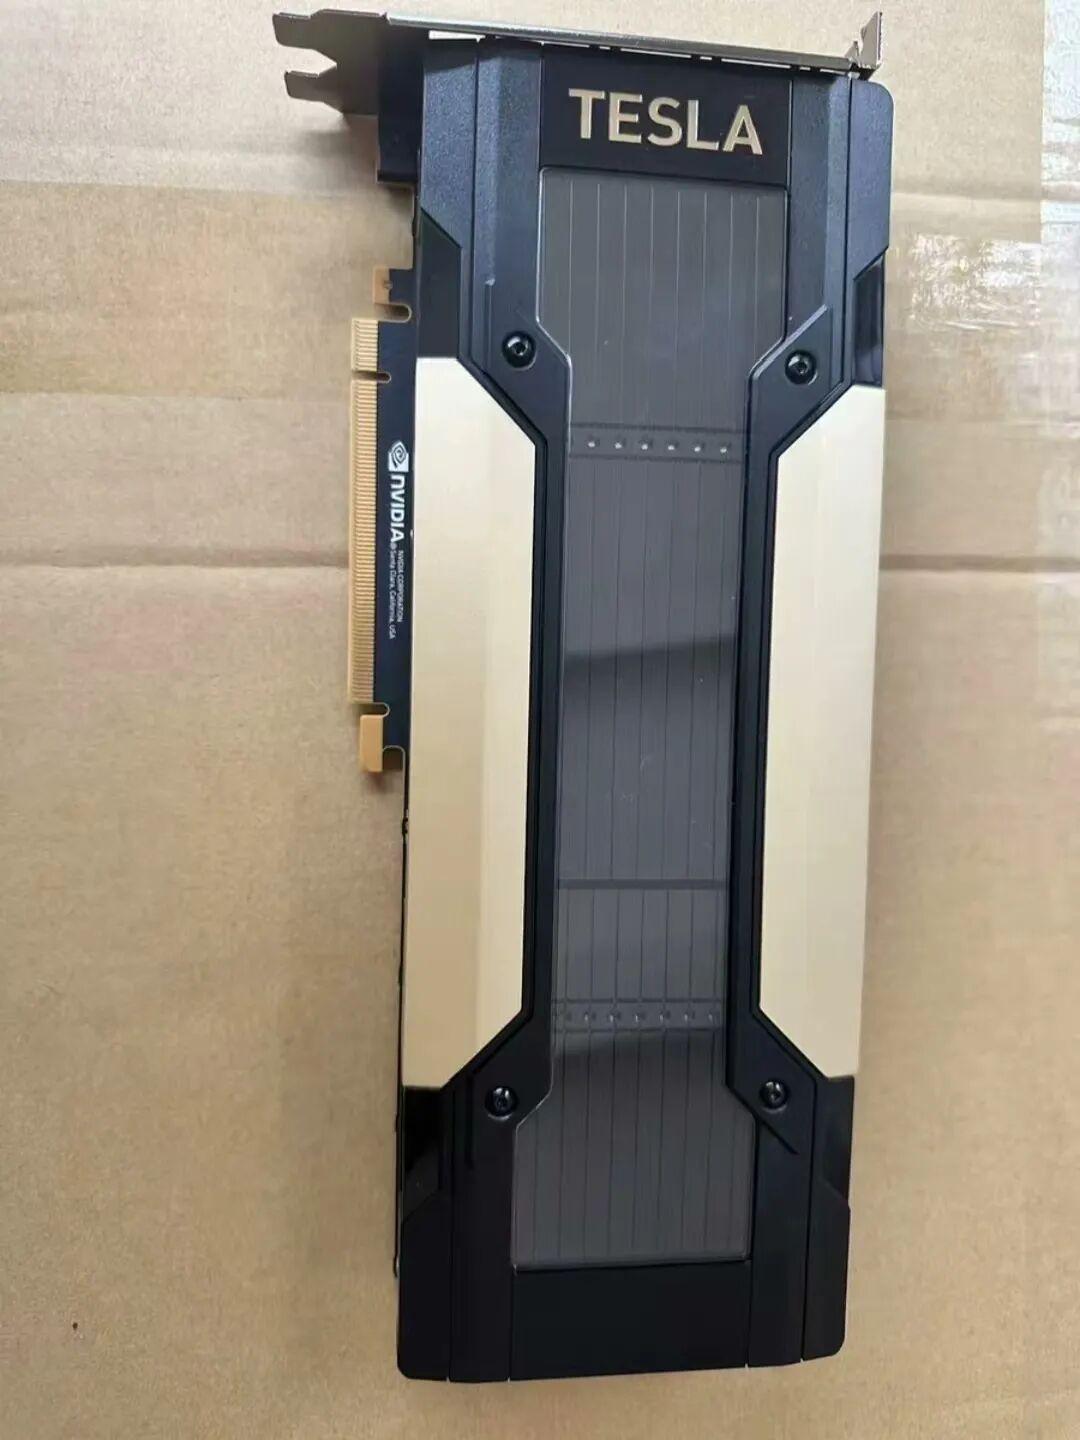
第一笔账:电费最容易被算错
评论区有人较真:"电费是可变成本,固定成本还是高,均摊下来很难。"也有人直接点破:本地跑大模型从来不是为了便宜,是为了合规、为了隐私,为了能7×24小时挂着跑任务、不看token余额。至于装机本身的快乐,那是另一笔账,没必要拿电费来报销。哔哩哔哩
第二笔账:显存多比GPU快更值钱
12G显存+32G内存的笔记本,现在真能跑起27B本地模型。社区整合包连引擎带模型打包好,免装Python和完整CUDA。瓶颈在带宽:最低32G是RAM+VRAM合计(RAM+VRAM−5G);解码是带宽题不是算力题,每1G显存约多缓存700个专家。同一引擎跑Qwen3.8-Flash-Next,12GB显存实测50+tps,大显存机型能上100-200tps。选型就写在文件名里:以Llama 3.1 8B为例,F16约15GB、Q8_0约8GB,Q4_K_M只有约4.6GB(llama.cpp官方量化文档)。“能跑"和"跑得好”,是两回事。哔哩哔哩哔哩哔哩知乎知乎哔哩哔哩
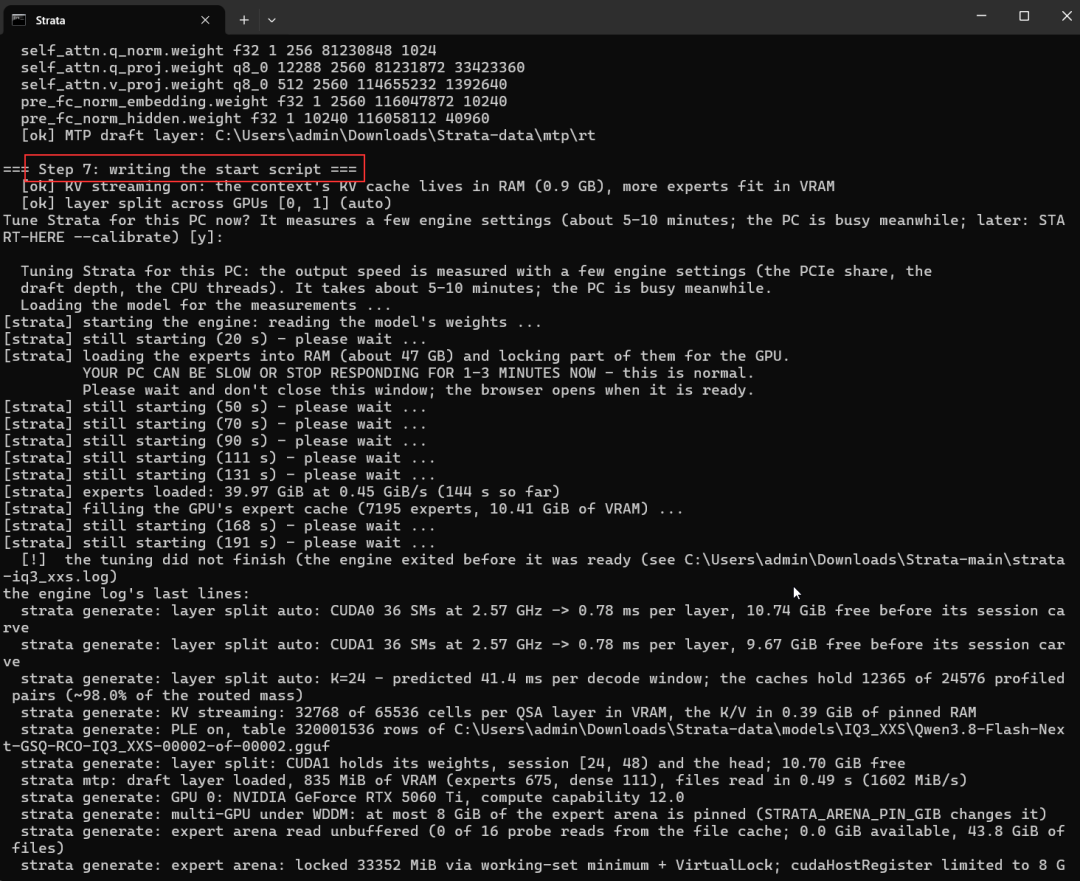
第三笔账:长上下文的账单没人替你付
想塞262K上下文?128K时KV缓存约13.7KB/token、约占1.7G;262K的首token要等约4分半。有人反馈"越往后速度越慢,存在长上下文衰减"。内存不够先看常驻层,实在放不下才落SSD;一旦掉进SSD档,建议优先降量化档。哔哩哔哩哔哩哔哩
结论不是"香不香",而是数据敏感、要常驻跑任务、或者就爱折腾,本地部署的价格才合理;认真写代码、追顶级能力,API依然是正解——评论区那句"真写代码还得上gpt6"说得糙,但在理。证据覆盖到哪,结论就到哪——剩下的账,按你自己的场景算。哔哩哔哩