小米MiMo"开源第一"遭实测打假:掺水还是测评盲区?
10月24日晚,知乎一个提问热了起来:如何评价小米MiMo-V2.6登上AA开源榜第一名?有回答毫不客气:刷分给自己脑子刷糊涂了呗。知乎
点火的是B站一条8万多播放的视频。UP主林禾Link自称铁杆米粉,三个月在小米模型上烧了超120亿token。他拿MiMo和智谱、DeepSeek横测骑自行车动画生成、轨道实验室、物理教学模型这类可视化任务,MiMo次次垫底,连排名在它后面的对手都没打过。他的结论克制但扎心:模型水平不算差,但"这个分数属实有点幽默了"。知乎哔哩哔哩
"开源第一"是怎么来的?
9月22日,小米发布并开源MiMo-V2.6系列。Pro版在Artificial Analysis智能指数上拿下46.32分,超过Kimi K3和Qwen3.8 Max,官方称是当前得分最高的开源模型。36氪知乎
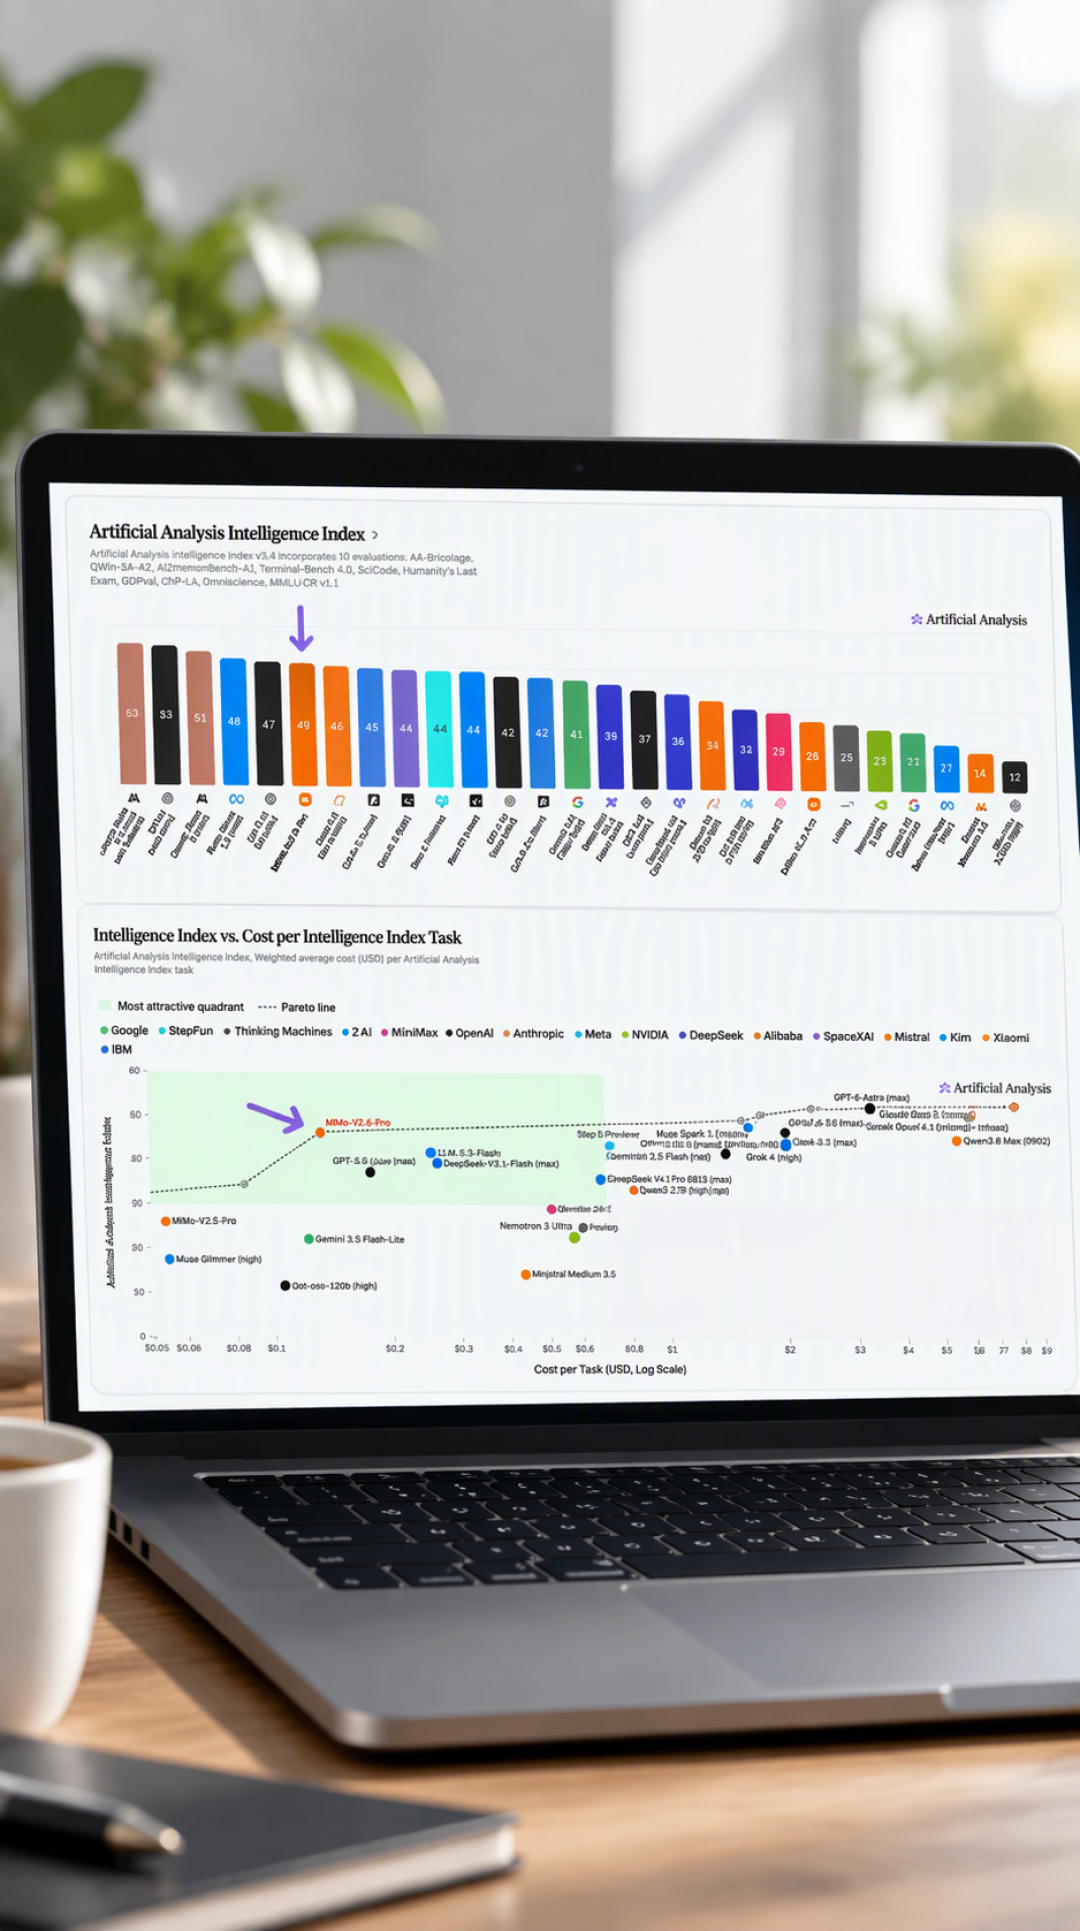
小米的牌打得很猛:Pro总参数约1.02万亿、激活420亿、支持100万token上下文。价格却只要每百万token输入3元、输出6元,约为海外旗舰的1/20到1/60。这次发布还附带一场6天烧掉约347万美元、全程公开到网上的强化学习训练。技术报告、训练代码和约7000个任务环境也一并开源。知乎36氪
所以,翻车了吗?
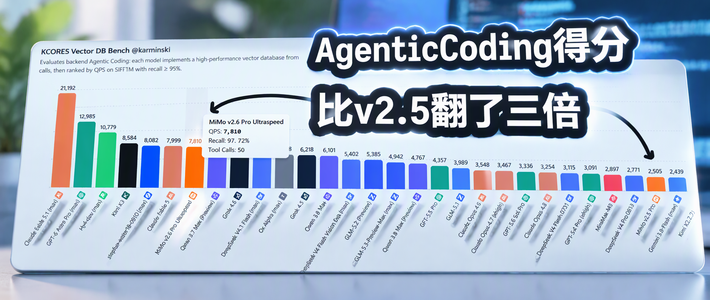
小米自己的成绩单其实从不是"满分"。官方基准里,MiMo在Toolathlon上赢过GPT5.6 Sol,JobBench仅次于Claude Opus5。但到了Terminal Bench,与GPT6 Astra、Claude Fable的代差依然肉眼可见。林禾Link测的可视化推理题,恰恰是榜单没覆盖的盲区。36氪知乎
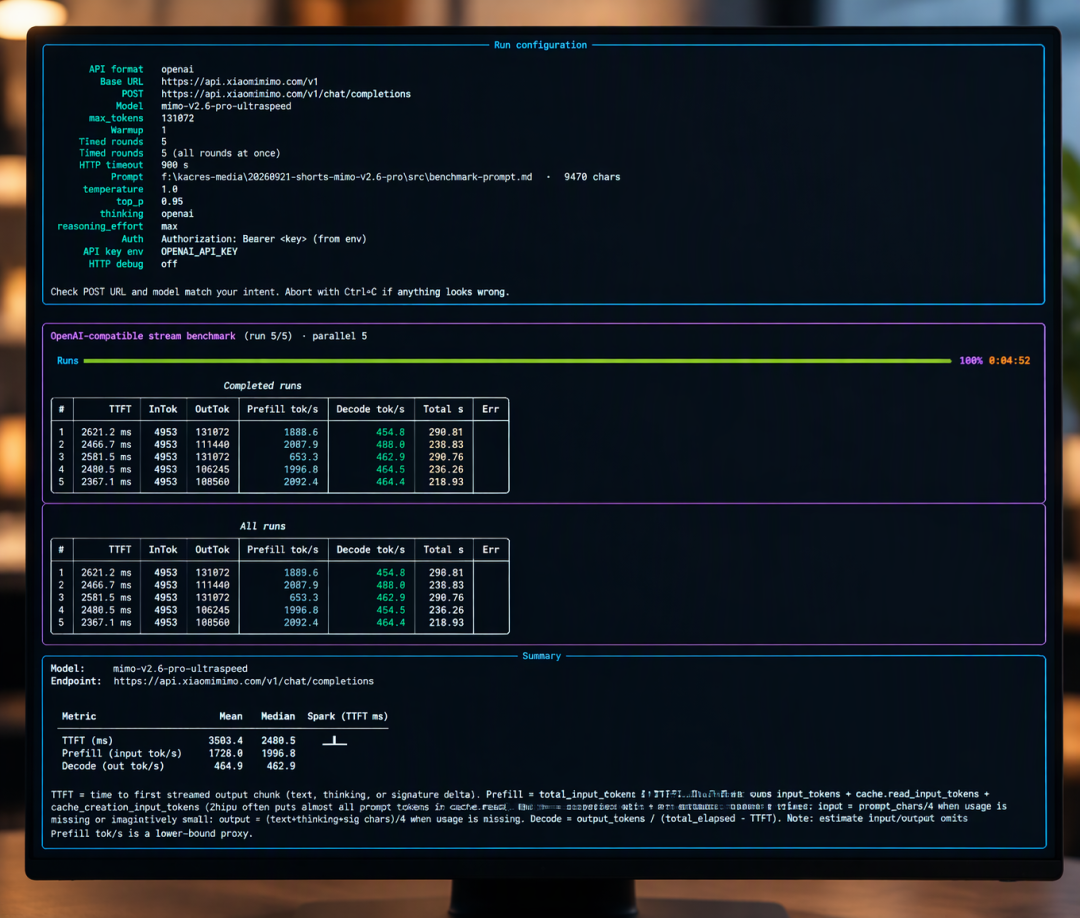
这就是关键:榜单考的是"应试能力",实测考的是"干活能力"。对基准定向优化是行业公开的秘密,小米技术报告自己都提醒过"奖励投机"风险——模型可能钻评分规则的空子,表面拿到高分,实际没完成任务。但反过来,一个UP主的十几个任务,也不能给MiMo判死刑:林禾Link自己也承认,MiMo显著强于Minimax M3,上一代V2.5"确实不错,性价比很高"。36氪哔哩哔哩
对你意味着什么?
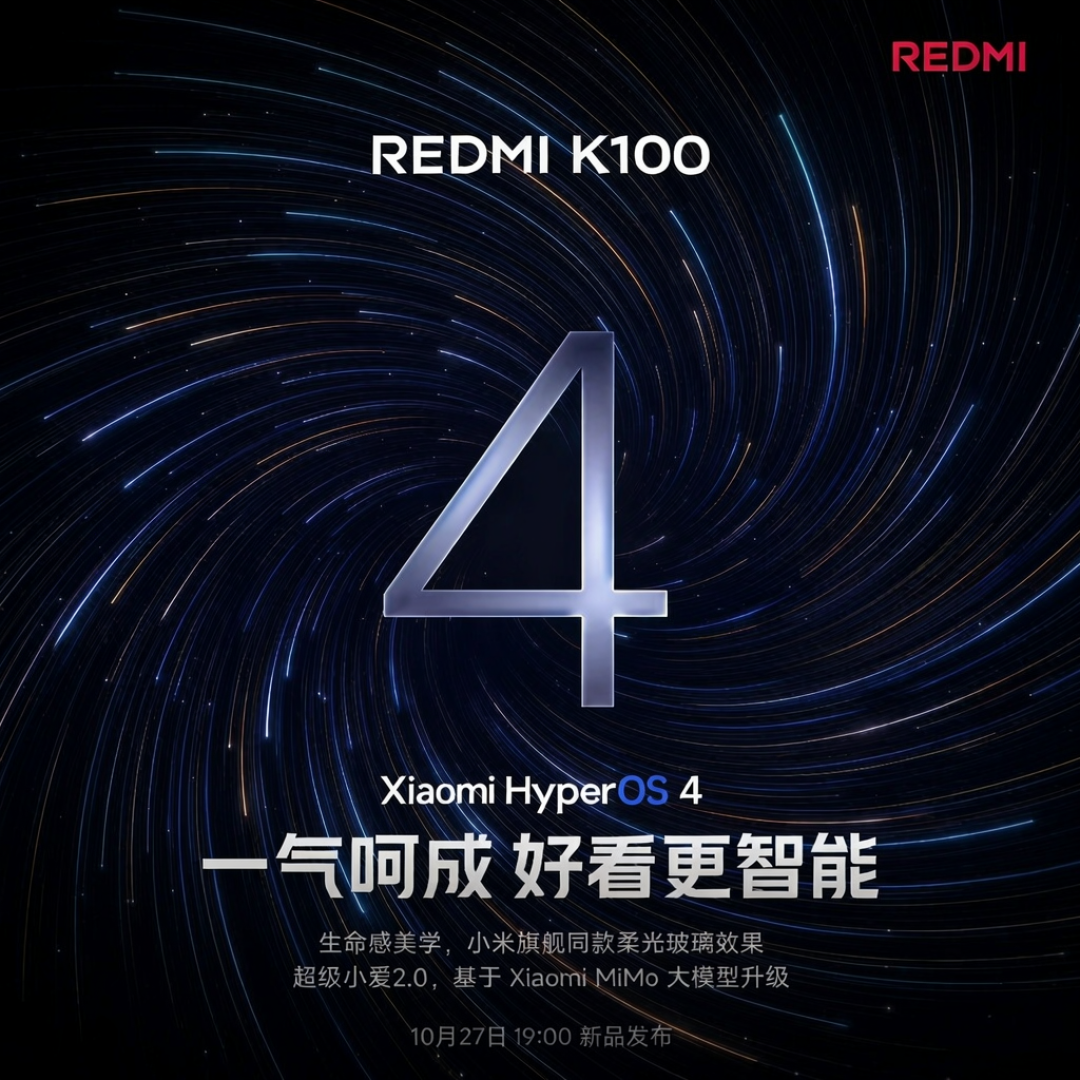
第一,别把"开源第一"当全能第一。更值得盯的是小米正把MiMo快速塞进产品:超级小爱2.0由MiMo驱动,10月27日发布会的红米K100将出厂搭载。终端编程助手MiMoCode也已经开源。模型成色如何,最终会体现在你的手机体验里。微博知乎
第二,想试水正当时。MiMo兼容OpenAI协议,改个base_url就能用。标准版每百万token输入只要1元,试几次不够一瓶水钱。榜单是真是假,拿自己的日常任务跑两遍,比看任何人吵架都靠谱。知乎