10月20日下午,DeepSeek在知乎官方账号发布技术报告《DeepSeek V4.1 Flash大规模推理部署实践》,宣布全面开源支撑自家线上服务的推理框架DeepInfer。第一财经把这件事的账本直接写成了标题:《一张卡每小时收入38美元!DeepSeek开源推理框架并披露账本》。 #DeepSeek全面开源DeepInfer#随后挂在微博热搜第40位,“AI印钞机”"毛利80%"的说法刷屏。第一财经微博
但把原文和附带的线上数据图读完整就会发现:这38美元是收入,不是利润;是单个集群按谷价口径折算的平均值,不是公司整体账本。真正的新料,是DeepSeek第一次把头部大模型公司"一张卡每小时怎么挣出38美元"的成本结构摊开给全行业看——而这本账,恰恰是开源版本暂时复制不走的部分。知乎
38美元是怎么算出来的
先核对口径。155万亿Tokens/天的吞吐约合每秒17.9亿token,全部来自支撑DeepSeek V4.1 Flash线上服务的单一集群;38美金/卡/小时按此折算,是单卡每天约912美元、年化约33万美元——这是算术,官方并没有同时公布这个集群有多少张卡、用的什么卡、花了多少钱。
"按谷价"是理解这个数字的关键。DeepSeek的API自今年8月起实行峰谷定价:工作日9:00-12:00、14:00-18:00为高峰时段,空闲时段执行谷价,谷价只有峰价的一半;8月23日起周末全天按谷价计费。官方随报告公开的运行数据图还注明,这一折算不考虑波峰波谷,实际部署中Prefill与Decode接近1:1。也就是说,38美元是用自家最低一档API售价折算的平均单卡收入,更接近下限而非上限;传播中"赚38美元"的说法,比公告里的"收入"更激进。大皖新闻
这本账靠什么撑起来:数据里的三个"省钱机关"
最核心的一笔,是缓存复用省掉的重复计算。官方公开的线上数据图里有一组耐人寻味的对比:平均输入长度77K token的请求,输入缓存命中率达96%,每卡吞吐在不含缓存命中时约60K tokens/秒,含命中时约150万tokens/秒,相差25倍。Block级前缀缓存存在约100 PiB SSD的独立3FS存储集群里,Agent流量保留3天、聊天流量保留7天,一段前缀反复被命中就不用重算。官方报告把这套机制的意义说得很直接:随着长上下文与agent流量增长,KVCache前缀缓存复用能极大减少prefill重算,从而显著降低成本。只在会话内分钟级复用的SWA缓存则不落盘、留在内存,没命中就用SWA Bounded Replay只重算最近128个token,把重算代价压成常数。36氪知乎
其次是按任务分卡、按流量伸缩。DeepSeek用常见的8卡机器承担Prefill任务,用64至128卡超节点做逐token输出的Decode,两个阶段独立配置资源、由自动扩缩容跟随流量调整比例。MoE模型的热门专家靠每卡冗余副本加定期重排摊平负载,官方实测最慢卡与均值的差距在3%—9%之间。运行数据图同时给出了体验底线:首token时延平均400毫秒、P99为1000毫秒,吐字速度230 tokens/秒——便宜没有以明显的体验劣化为代价。36氪
第三是投机解码再抠6%。自研DSpark框架预测每个草稿token的接受概率,按预期收益只验证值得验证的前缀。线上部署中,相比固定验证5个token的方案,变长验证让吞吐又提升了6%。三项叠加,解释了同样的卡为什么能跑出更高的收入分母。知乎
成本没写在公告里,"暴利"都是外面的测算
38美元之所以刺激,是因为它撞上了公开可查的市场租金。有博主对照后称,每小时38美元的营收远超公有云、AI云上英伟达卡集群每卡每小时3到7美元的市场租金。更有人按"不到8美元的B200租金"推算出毛利率接近80%,并外推定价更高的OpenAI、Anthropic"更暴利"。微博知乎
这些算法值得听,但要标注清楚:它们建立在两个DeepSeek没有披露的前提上——集群的卡型卡数、自建算力的采购与折旧成本。同一时间,也有从业者拿SemiAnalysis的利润估算器反驳,指出第三方租卡转售token、按OpenRouter实际售价计算,连两年前上市的B200在某些模型上都已接近负毛利。租金与收入之差只能说明"自建+直营+自用深度优化"这套组合有利可图,推不出全行业利润率的普适结论;DeepSeek官方也从未认领过任何毛利率数字。知乎
开源了什么、留了什么:离"复制同款成本"还差三件
比数字更早被讨论的是开源的成色。DeepSeek这次放出的DeepInfer,README自述最初主要基于vLLM构建,并借鉴了SGLang与TensorRT-LLM。框架本体集成分布式推理、推测解码、SWA Bounded Replay、结构化输出等能力,可在英伟达与华为昇腾平台运行。同步开源的deepseek-recipe编解码组件,处理逻辑与官方API完整对齐,确保第三方部署获得一致的API体验。头部大模型公司把生产环境在用的推理框架整机放出来,这确实是头一回。知乎36氪知乎
但第一财经点出了边界:此次发布提供的是离线推理及大规模服务所需的核心能力,要搭建完整在线服务,开发者仍需补齐KV缓存系统、推理阶段分离部署及跨副本负载均衡等组件。公告原文也承认,KVCache管理与负载均衡组件因与内部基础设施耦合较深,相关代码尚未完整开源。巧的是,这三样正是把"离线跑分"变成"线上接流量"、把60K变成150万的那一层。第一财经知乎
还有两点细节:批不变推理、确定性采样等特性仅开放英伟达平台,官方基准也全部在SM100(Blackwell一代)上完成,"兼容华为昇腾"目前只有支持声明,没有公开的昇腾950第三方实测数据。这次开源是开放核心引擎与工程经验,成本曲线能不能复制,仍取决于硬件配置、业务负载和系统集成能力。知乎
对普通用户,这本账意味着什么
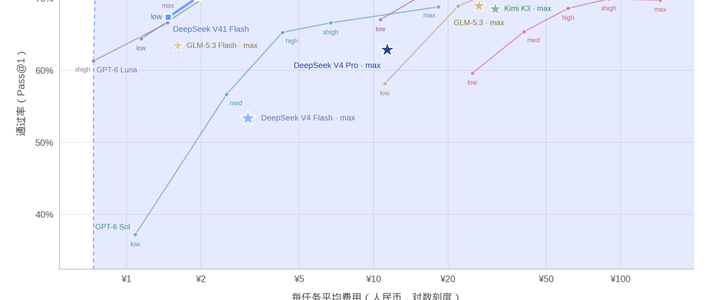
发布时点本身有信息量。此前一周,DeepSeek刚经历了10月15日的全球宕机,并罕见地按最近七日API消耗向用户发放补偿赠金。10月17日上线的V4.1 Flash-1017则把性价比继续推低:官方评测图中它最高通过率(Pass@1)达到77.0%,对应每项任务平均费用约1.3元,显著低于成绩接近的海外模型。在"服务不稳"的质疑声里,晒出一份"推理业务能自我造血"的完整账本,既是技术自信,也是一种用成本透明度做的信任修复。知乎36氪
对用户更实际的推论是:竞争的主战场正在从"每百万token单价"转向"每个任务的完成成本"。官方文档同步写明,搜索接口每1000次成功请求收5元、只有产生有效结果才计费;10月20日当天,MiniMax发布M3.1 Flash直接把输出价格砍半——价格战没有停的意思。当单卡收入按谷价算仍有38美元的空间,而谷价本身只是峰价的一半,DeepSeek手里还有可观的定价腾挪余地。36氪
接下来值得盯两个信号:KV缓存与负载均衡组件会不会在下一个模型周期前补齐开源,昇腾950上什么时候出现第三方实测数据。这两个答案,决定这次开源最终是"参考实现"还是"可部署方案",也决定38美元这本账,会不会变成整个行业的公共成本底线。