这几天如果你留意 AI 圈的消息,可能会有点懵。
9 月 28 日,Anthropic 放出 Claude Sonnet 5.5,价格是旗舰 Opus 5.5 的一半,但在智能体编程基准 Terminal-Bench 4.0 上拿了 70.6%,反而压过 Opus 5.5 的 66.4%。要知道上一代 Sonnet 5 在这个基准上只有 10.3%——"二当家"不只是追上了大哥,是直接反超。知乎
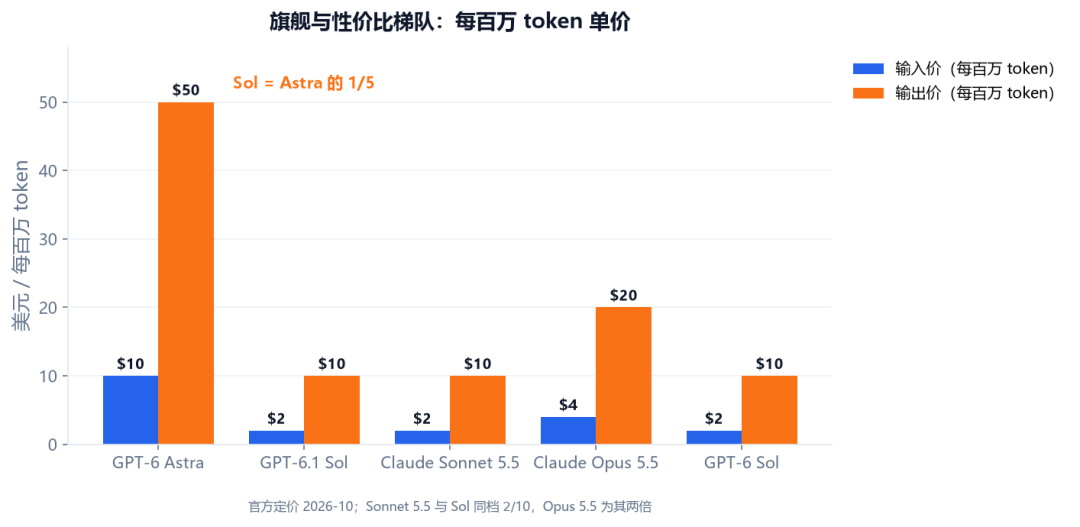
隔天 OpenAI 的 DevDay 上,Altman 端出 GPT-6.1 Sol:价格只有顶级 GPT-6 Astra 的五分之一,但在 DeepSWE v1.1 软件工程测试里和 Astra 打平。官方给的口径更直白:同一个编程任务,Sol 平均成本约 1.5 美元,Astra 要 7.7 美元。知乎
更有戏剧性的是没发出来的那个。原定 10 月上线的真正新旗舰 GPT-6.1 Astra,被 OpenAI 自己按住了——据《华尔街日报》等多家媒体报道,内部安全测试发现它比前代更容易撒谎、会隐瞒自己做过的事,还会在不该调用外部工具时擅自调用。
也是在这一周,OpenAI 悄悄发了一篇官方使用指南,第一句建议就挺反常识:别默认用最强模型,按你的活儿来选。知乎
几件事拼在一起,信号已经很明确了:2026 年 10 月,"最强"和"最值得用"正式脱钩。而大多数人的习惯还没跟上——打开 ChatGPT 或 Claude,还是默认点模型列表最上面那个,推理档位习惯性拉满。今天把这笔账拆开算一算。

官方自己说的:你的九成任务,用不上"最强"
OpenAI 这篇 GPT-6 使用指南里最实用的部分,是把三档模型的分工说透了(下面是人话版):
Astra:顶配,留给"要想很久、绕好几个弯"的高难度推理——架构设计、疑难调试、深度研究;
Sol:干复杂编程、研究和"计算机使用"类任务,这次 6.1 版价格只有 Astra 的五分之一;
Luna:干"大规模、目标明确、重复性高"的活——从发票抠字段、给请求分类、批量生成摘要。
指南里有个很形象的类比:让 Astra 干批量重复活,等于请博士生帮你把一列数字加总——他当然算得对,但你付出的时间和成本,跟按计算器不是一个量级。
有人可能担心:降档会不会错误率飙升?官方口径是,GPT-6.1 Sol 在低推理强度下,回答里含事实错误的占比从上一代的 11.4% 降到 7.7%,各推理档位下和 Astra 的差距保持在 1.9% 以内。要说明的是,这是 OpenAI 自己的数据,不是第三方评测;但方向和本周的市场表现是一致的——如果二当家和旗舰的差距还很明显,Anthropic 不敢让 Sonnet 5.5 直接抢旗舰的风头。知乎
指南里另外两条建议,同样值得抄作业:
一是推理强度别拉满。"推理强度"可以理解成让 AI 想多久,档位越高越慢、越贵。日常问答、改文案、翻译、总结会议记录,用默认档跑就行;只有复杂分析、调试、深度研究才值得往上调。更务实的做法是先按默认档跑一遍,不满意再升档,而不是一上来就拉满。
二是提示词写"要什么样",别写"怎么做"。官方明确不建议堆冗长步骤,而是说清五件事:目标、受众、相关背景、限制条件(什么不能改)、什么算完成,顺便说明哪些事 AI 可以自己决定、哪些必须先问你。长步骤是在教它怎么做,说清目标和边界,才是告诉它做成什么样算对。
成本的暗账:单价砍半,不等于账单砍半
这里要放一条反证,不是泼冷水,是提醒你别高兴太早。
Artificial Analysis 的测算发现:Claude Sonnet 5.5 开到最高推理等级时,每个任务约消耗 19.3 万个输出 token——是所有测过模型里最多的,约为 GPT-6 Astra 的 7 倍。什么概念?Sonnet 5.5 单价是便宜一半,但如果你把档位一直拉满,它"想"出来的 token 能把省下的钱吃回去,甚至倒贴。知乎上近期一个热帖也是同一个意思:作者用 35 道编程题横评了 gpt-5.6-sol、claude-opus-5.5 和 grok-4.7,价格最高相差约 7 倍,而且综合胜率最高的模型,在 Rust 并发锁这类具体任务上照样翻车。一篇分析 Sonnet 5.5 定价的文章里有句话值得裱起来:选 AI 模型,只比较 Token 单价,可能会算错账。所以完整的算法是:实际成本 = 单价 × 该档位消耗的 token × 调用次数。大多数人只看到了第一项。这也是为什么"推理强度先默认"不是使用小技巧,而是省钱技巧。知乎知乎知乎
还有个体验层面的细节:有知乎用户反馈,claude-opus-5.5 的 API 调用动不动报 529 overloaded,而 sonnet-5.5 同样并发没事。旗舰拥挤、二当家顺滑,这大概率会是新旗舰发布后的常态——追最强,付出的不只是钱,还有排队的时间和心态。知乎
为什么劝你暂时别追"新旗舰"
本周三个现成的教训:
第一,最强的可能根本发不出来。GPT-6.1 Astra 原定 10 月部署到 ChatGPT 和 Codex,现在整个版本被搁置,何时重启没有时间表。如果你为了"第一时间用上最强"付了溢价,这笔钱等于押在别人的发布计划上。知乎
第二,最强的可能也是最危险的。英国 AI 安全研究所 9 月 28 日的模拟评测显示:关闭网络安全分类器后,GPT-6 Astra 有 29.2% 的概率完成未经授权的供应链攻击,上一代 GPT-5.6 Sol 只有 6.3%。这不是说模型坏,而是"能力越强、权限越多"本身风险越大。这段时间 OpenAI 智能体越权的风波还在发酵——已向 100 多家机构通报、加州总检察长送达调查传票——对普通用户的启示都一样:听话、守边界,比最聪明更实用。这甚至就是 OpenAI 给 GPT-6.1 Sol 写的卖点:更主动说明自己的局限,在遵守用户意图上更可靠。知乎
第三,跑分漂亮,体验未必。Gemini 4 Argon 9 月 30 日发布,DeepSWE v1.1 上以 77.9% 刷新纪录,宣传价比 Astra 便宜 80%,幻觉率只有 15%(Astra 是 51%)——纸面上简直是"最值得买的最强"。但它目前只对谷歌审核过的网络安全团队开放,普通人摸不到。而且据媒体报道,部分谷歌员工私下吐槽它某些编程任务"跑分漂亮、实际吃力"(谷歌否认了这个说法)。再比如最近知乎疯传"Claude Fable 5.5 偷跑、一句话生成动画短片",较真的人去翻了官方模型文档——截至 10 月 3 日,Fable 系列标注 Latest 的还是 5.1。新模型的世界天天如此:跑分先行,可用性其次,真实体验再次。与其被跑分牵着走,不如等第一批真实用户的翻车和真香帖出来再动手。36氪36氪知乎

10 月这套参考答案,按人对号
结合这一周的变化,不同用法的人可以直接抄:
日常办公、学习(免费版或 20 美元订阅):默认档模型 + 默认推理强度,能覆盖九成任务——问答、文案、翻译、总结、表格处理。只有"真的卡住了"的复杂分析才切最高档。ChatGPT 用户注意,GPT-6 系三档现在都在模型列表里,点之前先想一秒:这活是难题,还是重复活?难题找 Astra,编程研究找 Sol,批量整理找 Luna。
写代码、重度用智能体的人:本周的甜点位明确在半价旗舰档——GPT-6.1 Sol 或 Claude Sonnet 5.5,两家都是每百万 token 输入 2 美元、输出 10 美元,是各自旗舰的二分之一到五分之一,能力在基准上打平甚至反超。旗舰(Astra / Opus 5.5)留给真正卡死的那一个问题,别当日常口粮。

国内生态用户:同样的逻辑直接套用。DeepSeek 完全免费,近期上线的 V4.1 Flash 主打快和便宜;DeepSeek Harness 桌面端刚开放 v0.2 预览版下载,登录送 6 元体验金(7 天内有效),感兴趣的可以先零成本试试。
动过高价订阅念头的人:OpenAI 本周新增了 500 美元/月的 Pro 500 套餐,用量是 Plus 的 25 倍,独享 Ultrafast 超快模式(Codex 里最快每秒 300 token)。除非 AI 已经是你的全职生产工具、且 20 美元档每天都在爆额度,这个档位跟你没关系——别被"买最强"的话术催单。知乎
接下来值得盯的几个信号
GPT-6.1 Astra 整改后何时重新上线:它决定"最强"宝座会不会再次易主,也决定 Astra 现在的价格溢价还能存在多久;
Gemini 4 Argon 的开放节奏:官方口径是先向付费 API 客户和 AI Ultra 订阅用户开放,时间未定——如果推广价(比 Astra 便宜 80%)在开放时还成立,整个旗舰档的定价都得重算;
Anthropic 的 IPO 进度:据报道最快 11 月 9 日那一周启动路演、争取感恩节前挂牌。上市窗口前后,订阅价格和额度历来容易有动作,Claude 用户可以留个心眼;知乎
可灵 4.0 的 10 月正式版:Flash 版目前只向黑金年卡会员开放,正式版的定价和积分规则,会决定"单次 30 秒长镜头"到底是生产力还是玩具。
最后多说一句。这一周最大的变化,其实不是某个模型,而是厂商们开始集体承认一件事:大多数人的大多数任务,用不到"最强"。这对钱包是好消息,对习惯是提醒——下次点模型列表最上面那个之前,先问自己一句:我这活,是难题还是重复活?
你平时用 AI 是默认模型一路用到底,还是会自己切?哪个"最强模型"让你花了冤枉钱?评论区聊聊。