十月的第一个信号来自小红书:“自从本地用了大模型,电费已经撑不住了”——发帖人说自己从一天四五度电,翻了一倍。 而在B站零刻SER9的开箱视频评论区,另一种声音拿到的赞数更高:部署本地模型还是算了吧,你还不如掏出豆包。 一个撑不住,一个不值得,两边都没说错,因为他们算的都不是同一本账。小红书哔哩哔哩
真正把这轮"常开AI节点"热度顶起来的,是零刻评论区里那批买了SER6 Pro、SER9、395级机器准备挂大模型的人。九月初,广东一位用户把整套"SER6 Pro+天钡EG02显卡坞+3090水神"挂上Qwen3.8-27B推理服务做成24小时常开节点,在9月11日发布的成本实测贴(llama.cpp,广东省居民阶梯电价口径)里把账摊开之后,反直觉的结论不止一个:这套系统24小时不间断满载推理,一年电费只要2,914元——比很多人想象的便宜得多;但"挂着不用"的待机功耗82W,意味着每天只用一小时的场景,月电费44.7元里有37元是待机烧掉的。电费、利用率、折旧,三本账的正确答案根本不是同一台机器给出的。知乎

账一:电费其实是最小的一笔,但"怎么跑"决定它归零还是翻倍
把这位作者的数据按使用场景排开:广东居民电价低(粤价〔2012〕135号,作者核对2026年未调整),482W的满载墙功耗撑不起"电费爆炸"的想象——重度常开场景年电费也只有2,914元,深圳执行独立电价、一档0.66287元/度、整体贵约11.6%,同样不改变任何结论。知乎

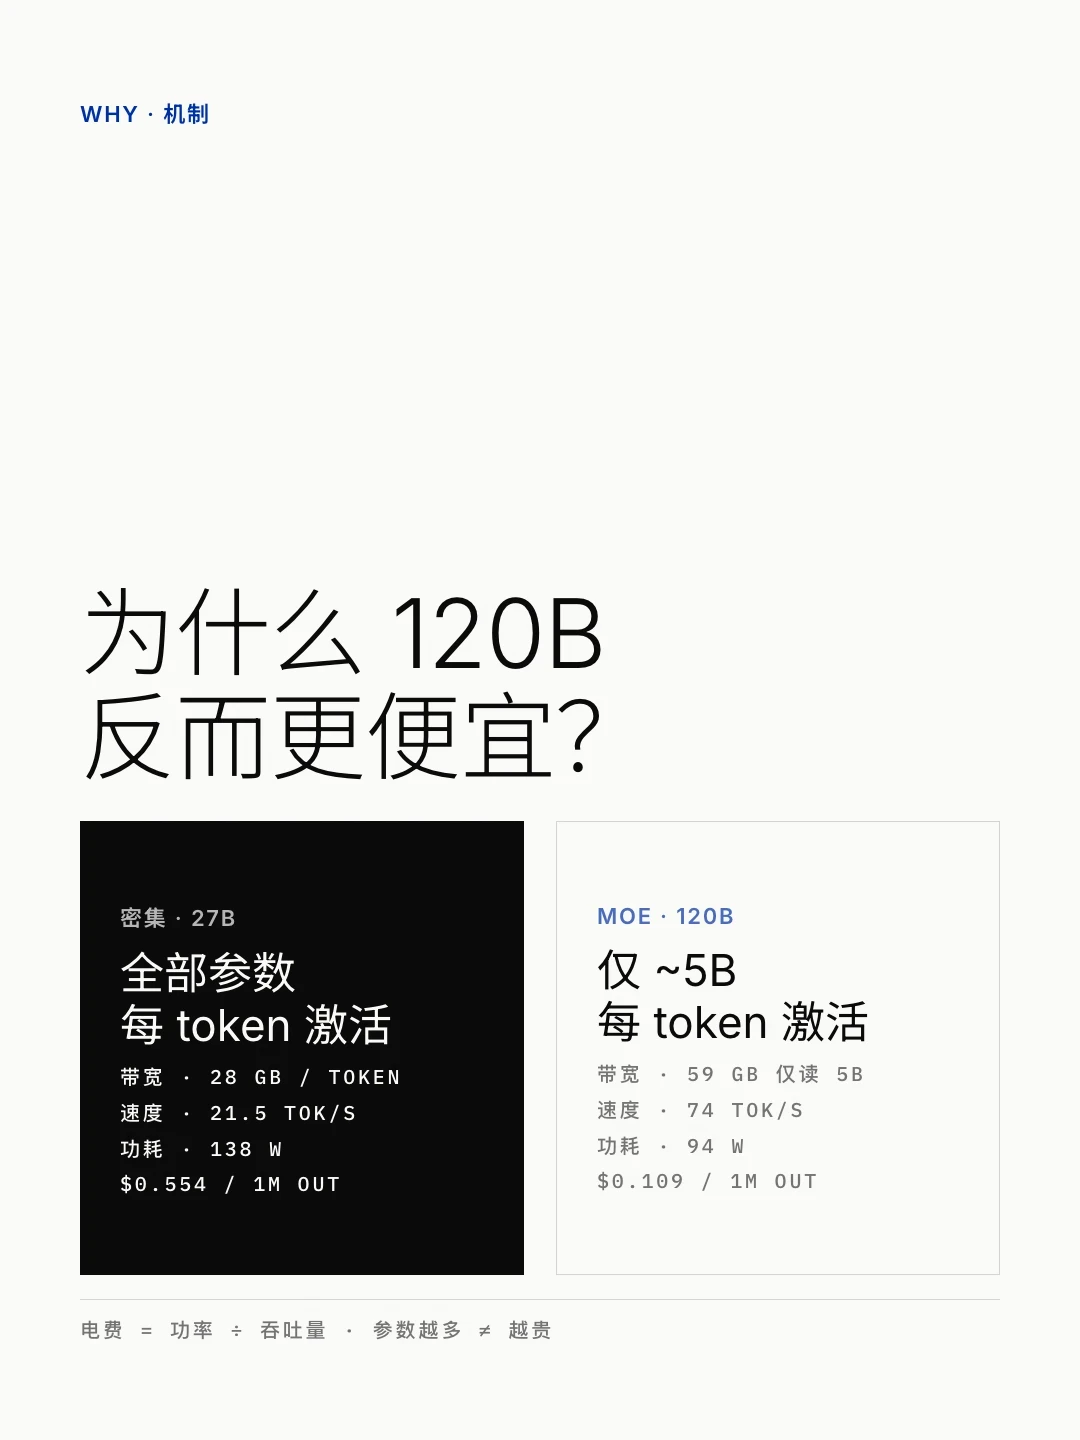
真正吃钱的地方有两个。第一是待机:每天推理只有一小时的场景,月电费44.7元里有37元是待机烧掉的,长期低负载时,主要成本根本不是推理本身。 第二是跑什么模型:另一位用户在M3 Ultra Mac Studio上接功率插座实测5款模型发现,27B密集模型138W功耗只跑出21.5 t/s,每百万token电费$0.554;而120B的MoE模型94W、74 t/s,每百万token只要$0.109——电费=功率÷吞吐量,不是越大越费电,是越慢越费电,密集模型才是"又慢又费电"的那一个。知乎小红书
峰谷电价则是一道容易被误用的工具。作者算得很清楚:把批量任务全排进谷段,一年省488元、降幅37.3%。知乎
阈值也写得直白:可延时的批量推理量占比超过30%再去申请,几乎全是白天交互式请求的人,申请峰谷反而可能因为峰段涨价20%而亏钱,申请前让95598或南网在线App估一下曲线。知乎
至于电源——800W金牌在7.6%的待机负载率下效率掉到80%,换铂金钛金也只年省30–60元,作者的建议是别动电源:要压住482W满载,750–850W金牌是合适的,靠功耗墙和休眠去优化。知乎
账二:利用率决定"本地更省"是真的还是口号
同一套3090,作者给出了两种截然不同的单位成本:单路串行调用时,每百万token电费口径2.83元看着很美,但把硬件折旧加进去就是8.20元——高于他测算时采用的API口径7.5元/百万token。 原因不在电费,在于你花7,600元买的算力只喂了一路。知乎
而打开连续批处理(–parallel 4~6)、总吞吐推到90–130 t/s之后,日均满载8小时以上的重度用法,单位成本降到1.26–3.64元/百万token,相对API节省51–83%、相对云GPU租赁节省70%以上——云那边还要另计存储、镜像拉取、公网带宽,重启还得重新加载模型。知乎
所以"本地模型贵不贵"这个问题本身就问错了,该问的是"你的负载长什么样"。SER9开箱视频的评论区里,有同好晒出了自己的实际体验:我的零刻395 NPU从来没看见过有任何出力的时候,纯纯打酱油。 下面另有回复提醒:NPU需要专门优化适配,大多软件默认还是走CPU和GPU。机器上CPU、GPU、NPU三块算力,你的调用方式喂到几块,账就算给谁。哔哩哔哩
账三:折旧这最后一本,最容易让结论当场反转
这台账对两类人是完全相反的。
已经家里有SER6 Pro和3090的人:新增支出只有EG02显卡坞1,299元+电源500元+线材300元,折旧摊到每月约35元,边际成本几乎只剩电费,S3场景盈亏平衡降到13.2M token/月,按连续批处理90 t/s算,每天跑满1.5小时就回本,剩下的全是净赚。 这类人确实"几乎没有不用的理由",要做的事只有四件:开批处理、限功耗墙、低负载挂休眠、批量排谷段。知乎
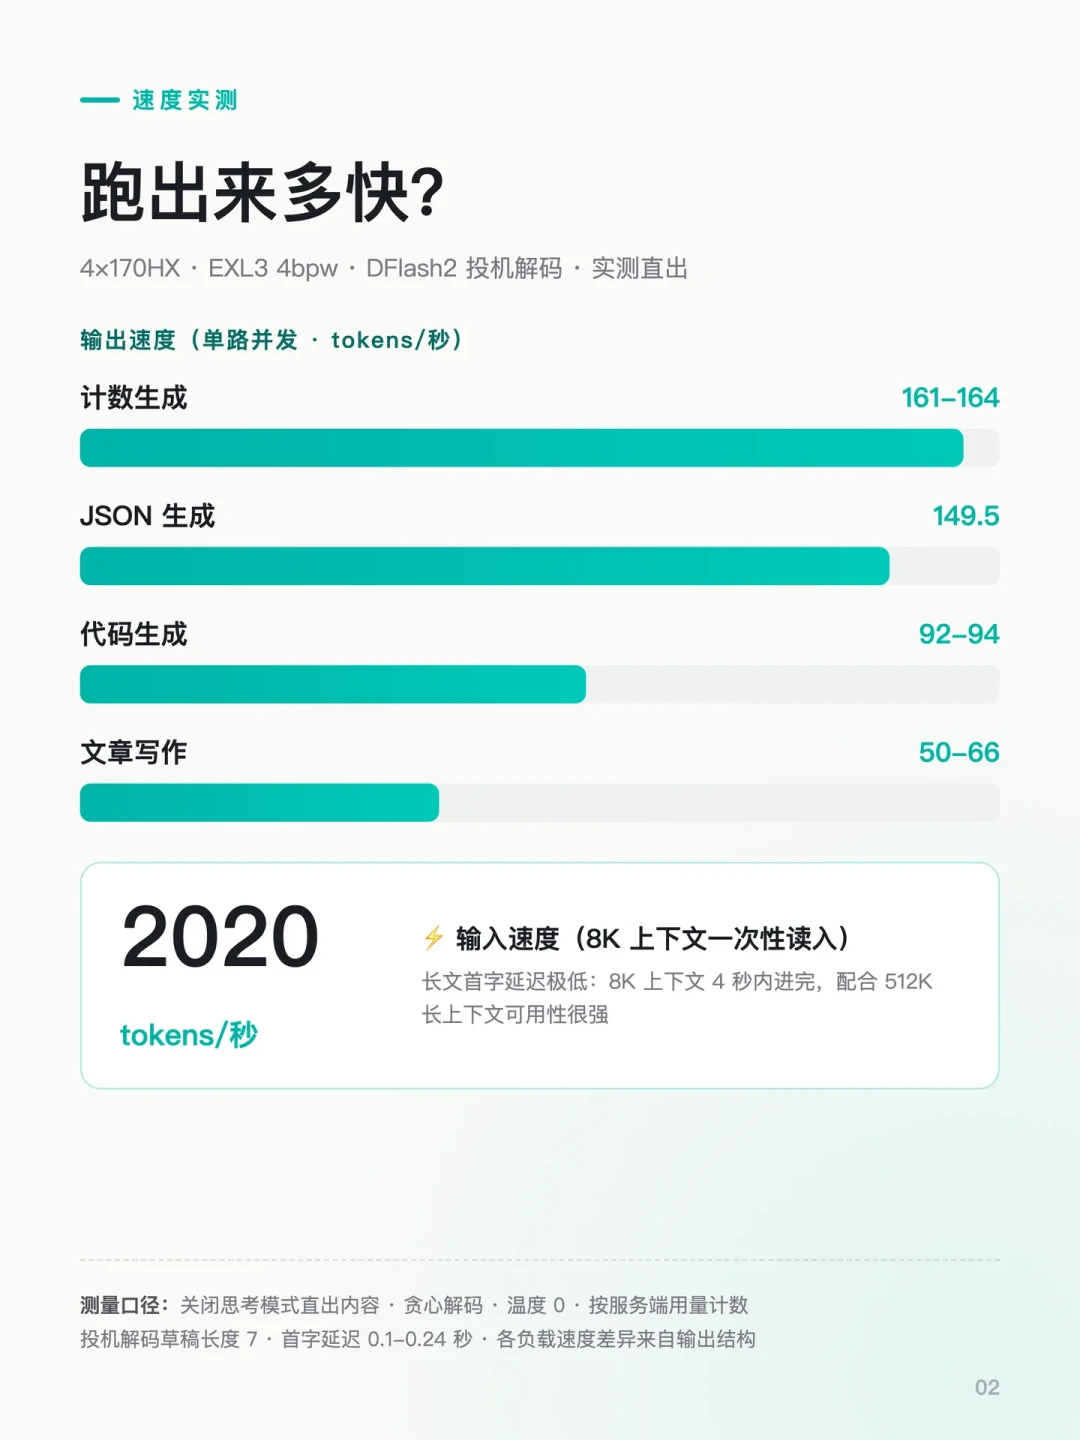
为了爱好专门配新硬件的人:9月底另一位用户晒出了自己的极限样本——4张170HX矿卡(5万收卡、整机约6万)搭PP4流水线跑GLM-5.3-Flash 320B MoE,单流实测150 t/s确实能打,满载约1.25kW、按50%负载每天电费8.3元;但他自己把账算完,按官方API输出价折算日净赚约10元,回本约16.4年。 这恰好是折旧账的本相:问题从来不在电费,而在你为"打电话级"的需求买了一台"数据中心"。6月底企业侧也流传过同口径的提醒——"自己买卡部署大模型,长期肯定比交API划算"被称为过去一年最贵的一句话,90%的企业第一年就算错了账。小红书小红书

一个容易被忽略的墙:这台机器走不走得满,接口先说话。SER6 Pro机身只有USB4(40Gbps)、没有OCuLink出线口,EG02的PCIe 4.0×4(约64Gbps双向)除非拆机走M.2转接,否则只能向下兼容雷电/USB4。 给零刻加坞之前先查自家机型的出线规格,这是三本账之前的第零步——带宽口径我们早前聊SEi14 AI时算过一次,换到显卡坞场景它是同一堵墙。知乎
三类人,三个答案
轻度问答、偶尔批量(每天1–2小时以内):直接调API。更便宜、免维护、随时能换更强的模型;家里真要一个常开节点,选低功耗机型把GPU留给别的用途,别让82W待机替你交电费。
重度自托管(网关/智能体/全家共享推理,日均8小时以上):本地赢,先做批处理和功耗墙,再谈峰谷;电费在这本账里只是零头。
吃灰向的硬件爱好者:先算折旧和盈亏平衡,再算速度。这轮内存硬盘涨价潮里,"沉没硬件"的折旧账越晚算越占便宜,但为爱好新配的每一张卡,都要先用16年那个数字冷静一下。
最后留两个继续观察的信号:原帖作者建议测算口径每半年复核一次,电价政策、硬件行情、llama.cpp版本都在动。 不放心别人家电的口径,接个智能插座、用开源的TokenWatt类工具就能自校准自己家的账。 至于"电费撑不住"的那位——他翻倍的账单和"不如用豆包"的高赞,其实给的是同一个提醒:常开AI节点的成本从来不由机器定价,由你的用法定价。知乎小红书