年初的CES上,黄仁勋给了AI基建一个新说法:推理的瓶颈正在从计算转向上下文存储,旧的存储架构跟不上,得重构。微博
九个月后的华为全联接大会上,硬件开始跟上:昇腾960超节点旁边多了一个新角色OceanStor M900,官方定位很直白——AI记忆存储,基于灵衢网络做"一跳直通"的PB级KV缓存。 再往前,英伟达推出了CMX Context Memory Storage。 两家在做同一件事:给KV Cache单独盖一间仓库。智能相对论雷峰网
KV Cache是大模型推理时反复翻阅的"笔记":每生成一个字,都要回看前面所有内容留下的中间结果。上下文拉到百万字级,这份笔记能占掉整个推理显存开销的九成以上,全留在显存里,成本和电费都顶不住。知乎
偏偏又赶上存储行价疯涨:内存又贵又缺,闪迪一度要求客户100%现金预付,去锁定未来一到三年的芯片配额,企业级SSD被业内形容成"比金子还贵"。微博
于是这笔账换了个算法:以存换算。算过的历史KV不丢,存起来,下次命中直接复用。业内的测算很直接——命中率从90%提到95%,重算那部分的算力开销就砍一半。雷峰网
而且DRAM和SSD不是1:1替换,有的方案里1TB内存的缺口要用5TB甚至10TB闪存去补。一句话:少买内存,多买SSD。
账到这里都顺。真正的坎是:取回来的速度,能不能跑赢重新算的速度。
一个生产环境先踩了坑。某团队在8卡B300节点上给vLLM引擎接了共享远端KV缓存,上线后中位延迟纹丝不动,长请求的p99却从4秒飙到17秒;最严重时59条请求堵在引擎里排队,GPU利用率只剩7%。知乎
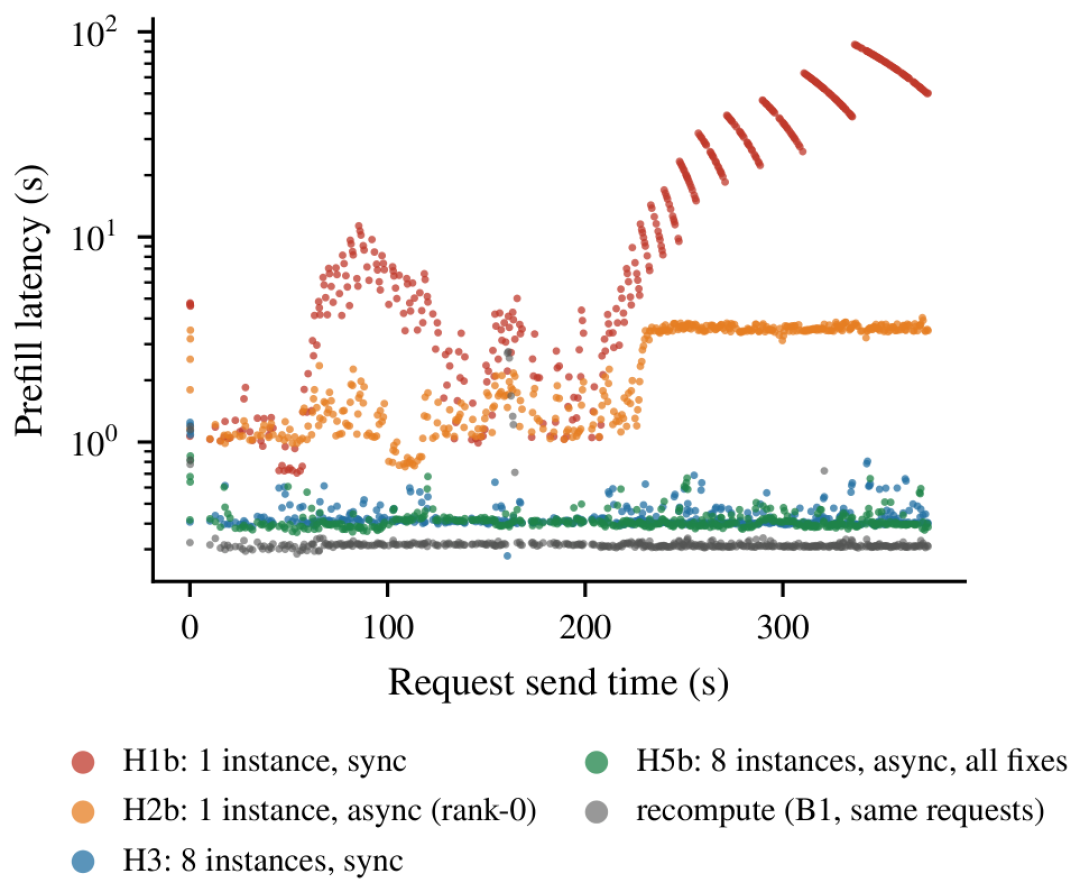
复盘的根因不是"网络慢"三个字。这台机器的GPU每秒能重算5.2万个token,远端缓存层只交付1.7GB/s:一条16k token的prompt,重算只要0.31秒,从远端取要0.88秒——命中一次,贵过一次。
论文作者算出一条生死线:盈亏平衡带宽=每token的KV体积×重算速率,在这台机器上是2.53GB/s。任何跑不赢这条线的存储层,都不如重算。改造后的数字同样具体:远端实例按卡分片,聚合带宽从1.71提到10.76GB/s,再配上异步加载,p99从83秒压到0.67秒。知乎
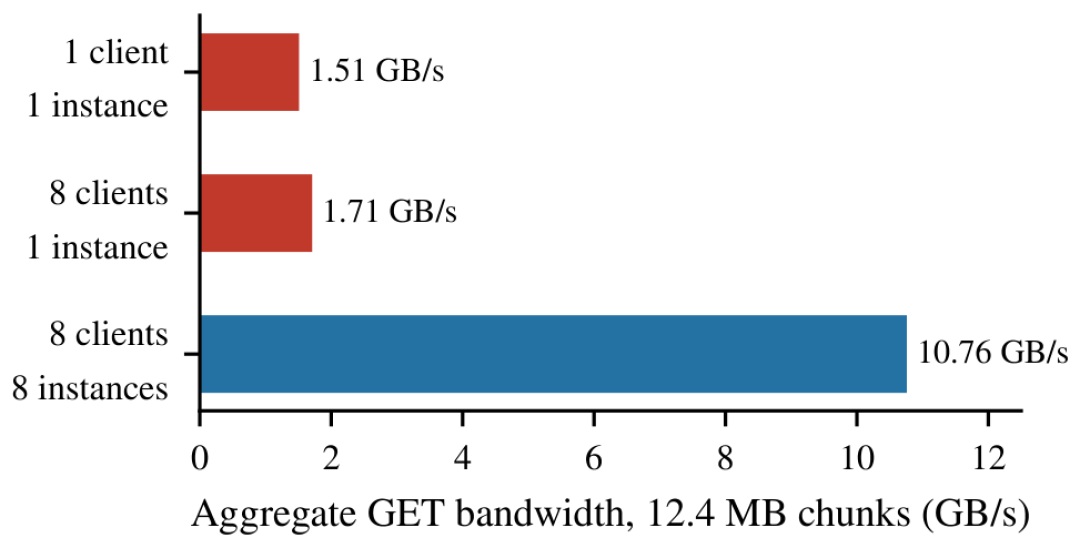
所以KV Cache外置,表面是仓库,骨子里是网络问题。货架画得再好,管道送不赢重算,就白搭。
华为把答案拆成了四层:HBM放最热的KV,内存池做缓冲,新出的KVU模组以单卡64TB容量、40GB/s顺序读带宽接住次热数据,本地SSD管冷存储。官方测试口径里,这套分级让NPU利用率提升30%,首token延迟降低50%。知乎
另一条路线是池化。Kimi的Mooncake靠RDMA把全集群的内存和闪存连成一个KV池;DeepSeek更早就把命中缓存的输入token定价到未命中的十分之一——价差本身就是账本:搬回来比重算便宜,这生意才成立。知乎
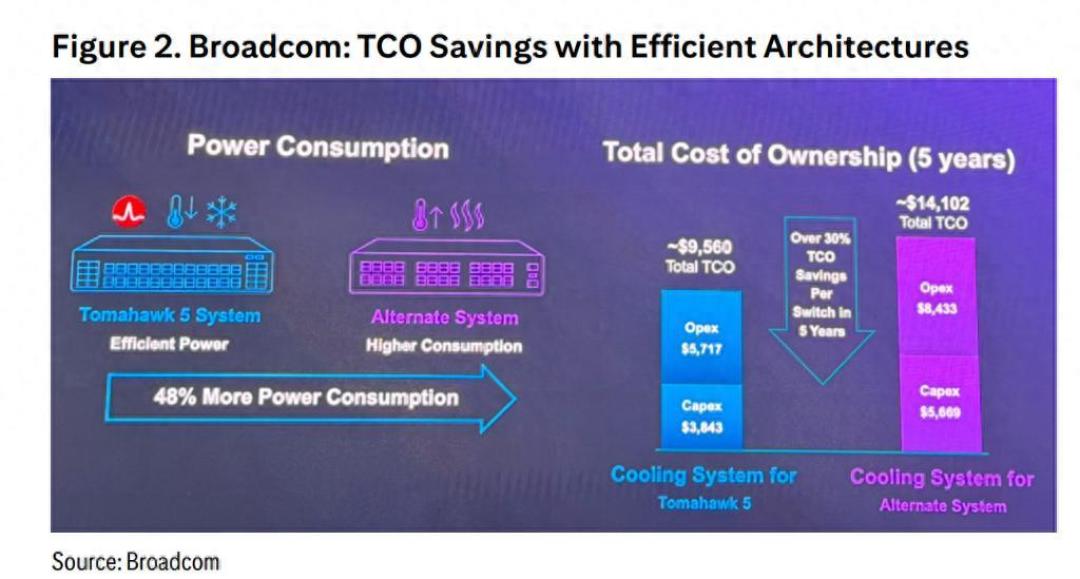
上游也在对齐信号。Marvell在花旗峰会上判断,KV Cache规模会大到超过HBM容量;博通押注以太网成为大规模AI互联的首选,交换芯片已做到102.4Tbps;华为则发布了国内首发的800G AI网卡SP560。华尔街见闻
只是仓库有图纸,价目表还没有。面向KV Cache的专用SSD,耐写指标还在3到9 DWPD之间摇摆,业内估计规格收敛要6到12个月,产品落地再加一年。雷峰网
AI的记忆正在变成一门新的存储生意。而管道能铺多快,决定这门生意什么时候真正开始赚钱。