本地AI生成这半年的浪潮,是从大模型、到画图、再到做视频,现在轮到声音。风向标是GitHub上的VoiceStudio:今年4月由个人开发者debpalash开源(前身叫OmniVoice-Studio),基本一人维护、提交了两千次上下。 它的星标曲线相当夸张——9月初的介绍文里还是1.5万星,10月15日的文章写它破了6万星,10月22至23日的文章已经在说7万到7.9万星。知乎知乎知乎
配套教程、整合包、实测视频同步刷屏,清一色是"不想把声音上传云端""把ElevenLabs搬回本地"这类标题。 它做的事一句话能说清:把按字符收费的云端语音服务——声音克隆、视频配音、听写转写、有声书——全部装进一个桌面应用,不注册账号、没有API Key,用多用少不收费,音频不出本机。知乎知乎
它不是单个模型,是一台"语音工作台"
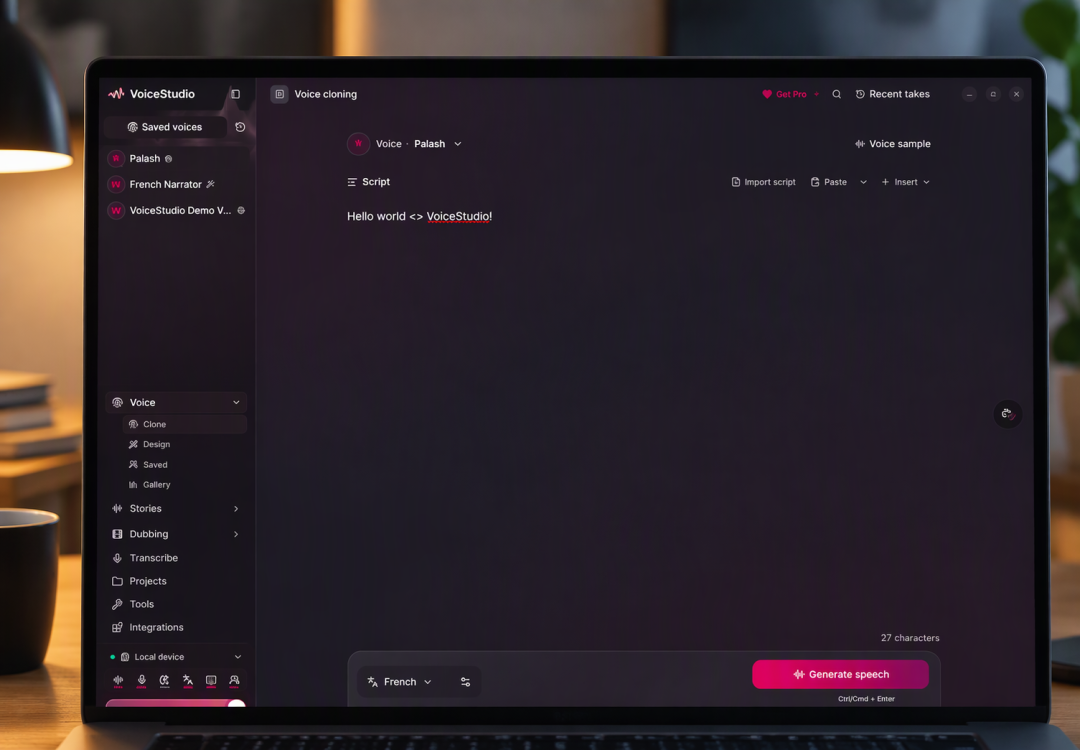
VoiceStudio集成了16个语音合成引擎和11个语音识别引擎,默认引擎是k2-fsa团队的OmniVoice。 宣传里"支持646种语言"是全目录加起来的数字,单个引擎远吃不下这么多,选装之前要对着自己常用的语种查。知乎
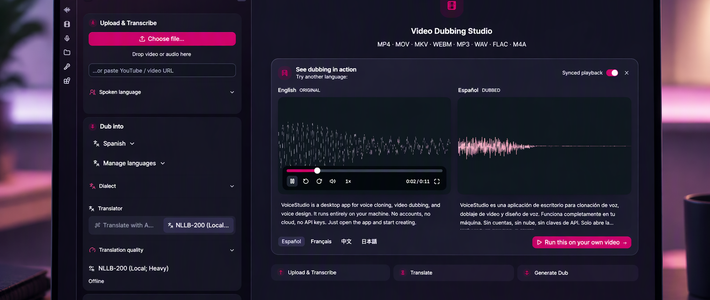
几个核心玩法:丢一段3秒录音就能克隆声音——但这是官方明说的下限,“能跑,质量看运气”,官方建议5到15秒单人干净的参考录音。 没有现成录音,可以用文字描述性别、年龄、口音、情绪,直接生成一个虚拟音色,给有声书配一屋子配角很省事;视频丢进去自动转录、翻译、区分说话人再重新配音导出MP4,支持批量队列;EPUB、PDF导进来自动分章、按角色分配声音,导出带章节标记的m4b。知乎
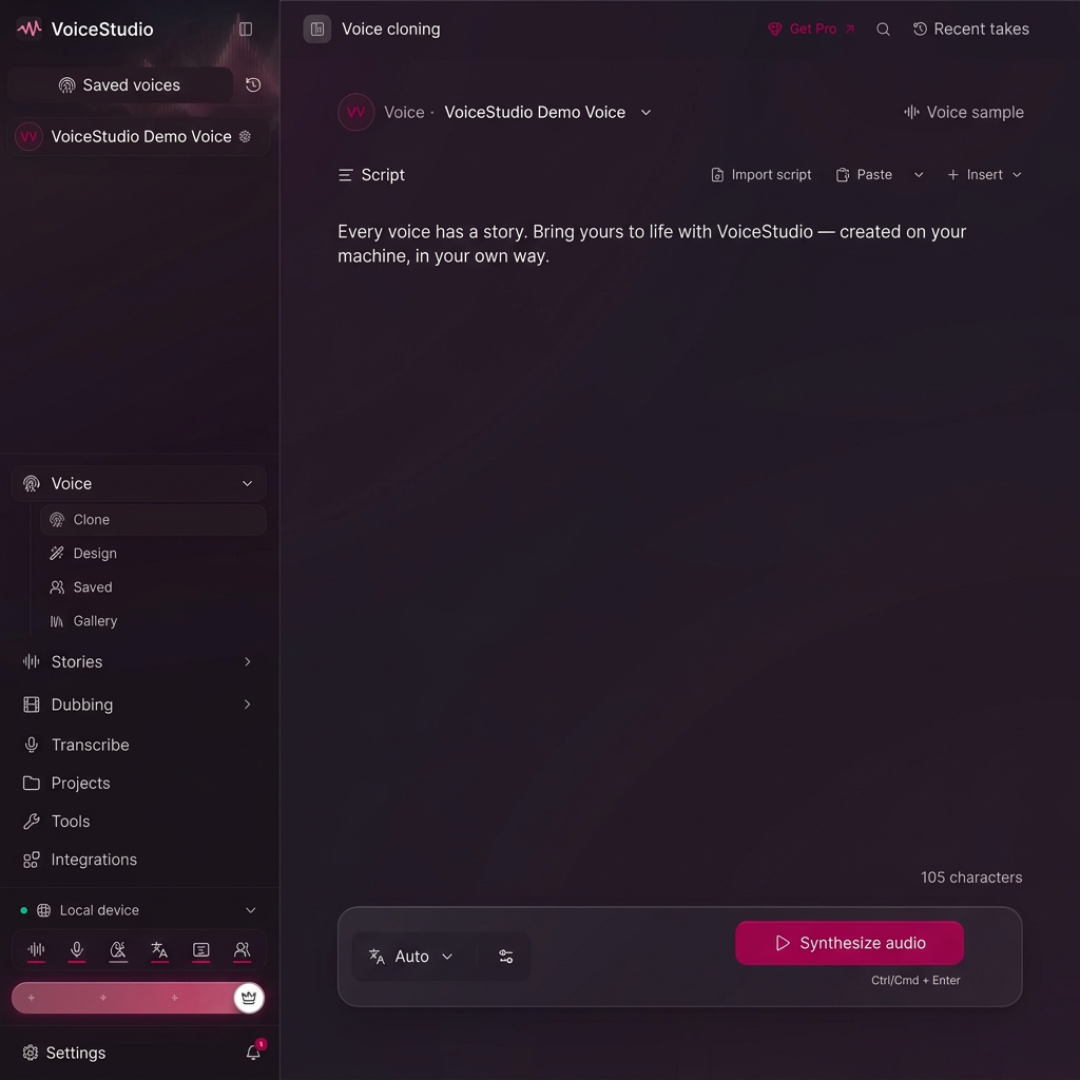
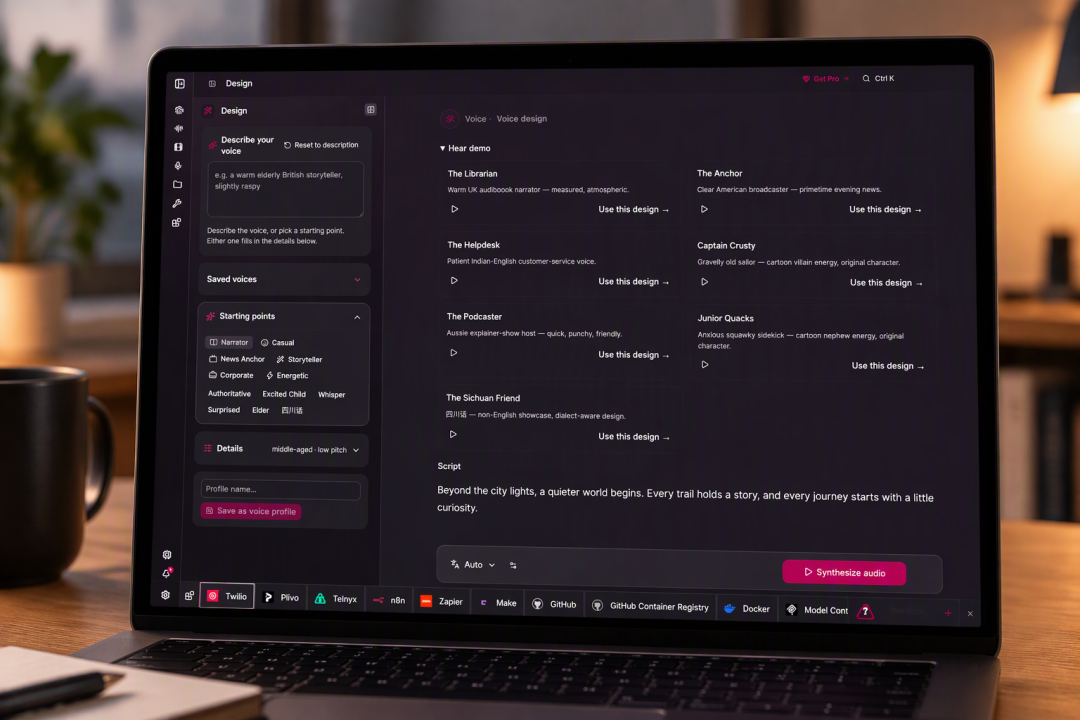
对开发者,本地会起一个OpenAI兼容的音频API,监听localhost:3900,原来调OpenAI语音接口的脚本基本只需把base_url指过来就能用。 它还自带MCP server,桌面版能直接导出Claude Code、Cursor、Codex三家的现成配置,等于给Agent配了一张嘴;有个细节:MCP默认内联返回base64音频,等于每次调用都把音频字节塞进模型上下文,把环境变量OMNIVOICE_MCP_OUTPUT_MODE设成files,就改成写到本地目录只回路径。知乎
语音这一层,不是这一个项目在自嗨
把本周三个平台的帖子摆在一起看,本地语音生成是整层在爆发,不是单点炒作:
时间 | 事件 | 关键事实 |
|---|---|---|
9-03 | VoiceStudio介绍文 | GitHub 1.5万星 |
10-15 | “被ElevenLabs月费逼疯” | VoiceStudio破6万星 |
10-17起 | 知乎多篇"不想上传声音" | VoiceStudio教程刷屏 |
10-22 | 机器之心 | NeurIPS 2026收录RVCBench,系统评测18个开源语音克隆模型 |
10-23 | B站 | VoxCPM2介绍:4万星 |
10-24 | OpenBMB | VoxCPM开源:VoxCPM2为2B参数、30种语言、9种中文方言、48kHz输出 |
VoxCPM来自清华THUHCSI×面壁×OpenBMB系团队,最新的VoxCPM2把模型规模提到20亿参数,支持30种语言、9种中文方言,输出48kHz音频。 它走"无离散音频分词器的扩散自回归"路线,自然语言描述音色、可控克隆之外,还有同时喂参考音频及其文本的Ultimate Cloning模式;官方也写明,音色设计和可控克隆的结果在不同生成轮次间会有差异。B站官方开源的IndexTTS2/2.5靠"3秒复制声音+一键bat整合包"在粉丝圈流传。 有人宣称把GPT-SoVITS的TensorRT魔改版首音延迟做到了74.6ms(作者自测数据)。 Drama-3、audio.cpp-webui则把"8G显存跑TTS、跑上百款音频模型"做成了常态。生态(整合包、加速、API层)和工具是同步成型的。知乎哔哩哔哩哔哩哔哩
装之前,三道真实的坎
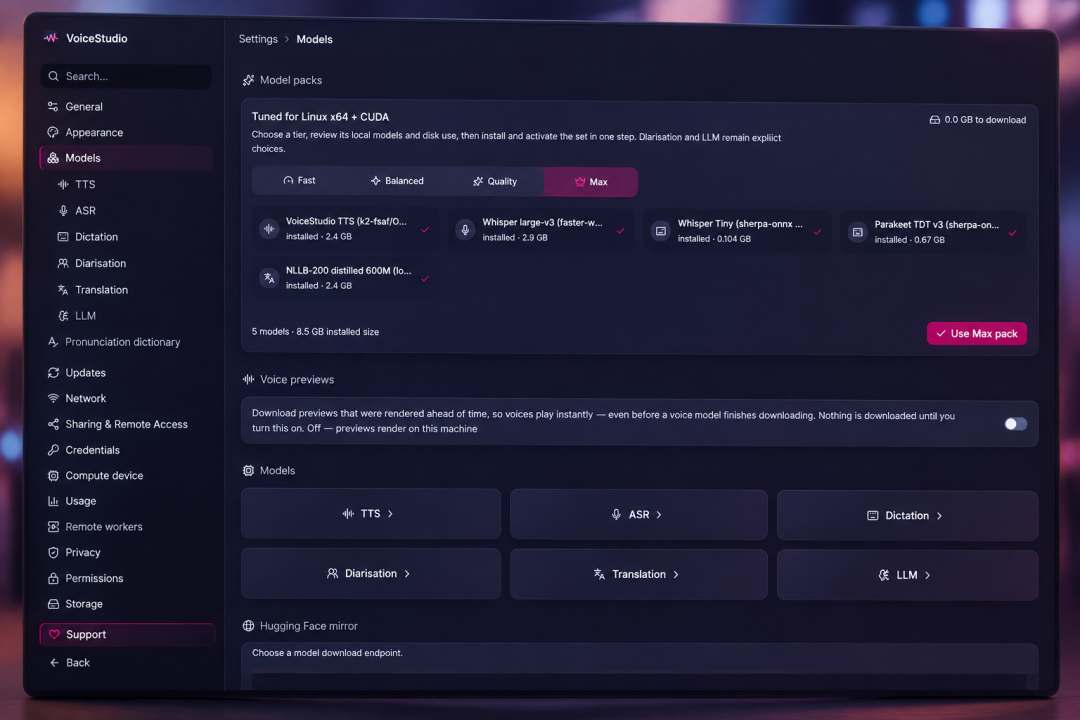
第一道:硬件账。 最低8GB内存、10GB硬盘能跑起来,但建议16GB以上;要高保真克隆或批量配音,8GB以上显存稳得多;纯CPU也行,选轻量引擎接受它慢。 首次安装是大头:CPU版PyTorch约5GB、默认引擎权重约2.3GB;两条劝退名单要记好——Intel Mac只能跑应用界面、本地后端起不来,得连另一台机器,Windows on ARM被官方标为实验性质;早期Tauri版桌面端在0.5.3之后停止维护,现在只剩Electron一条路。知乎知乎
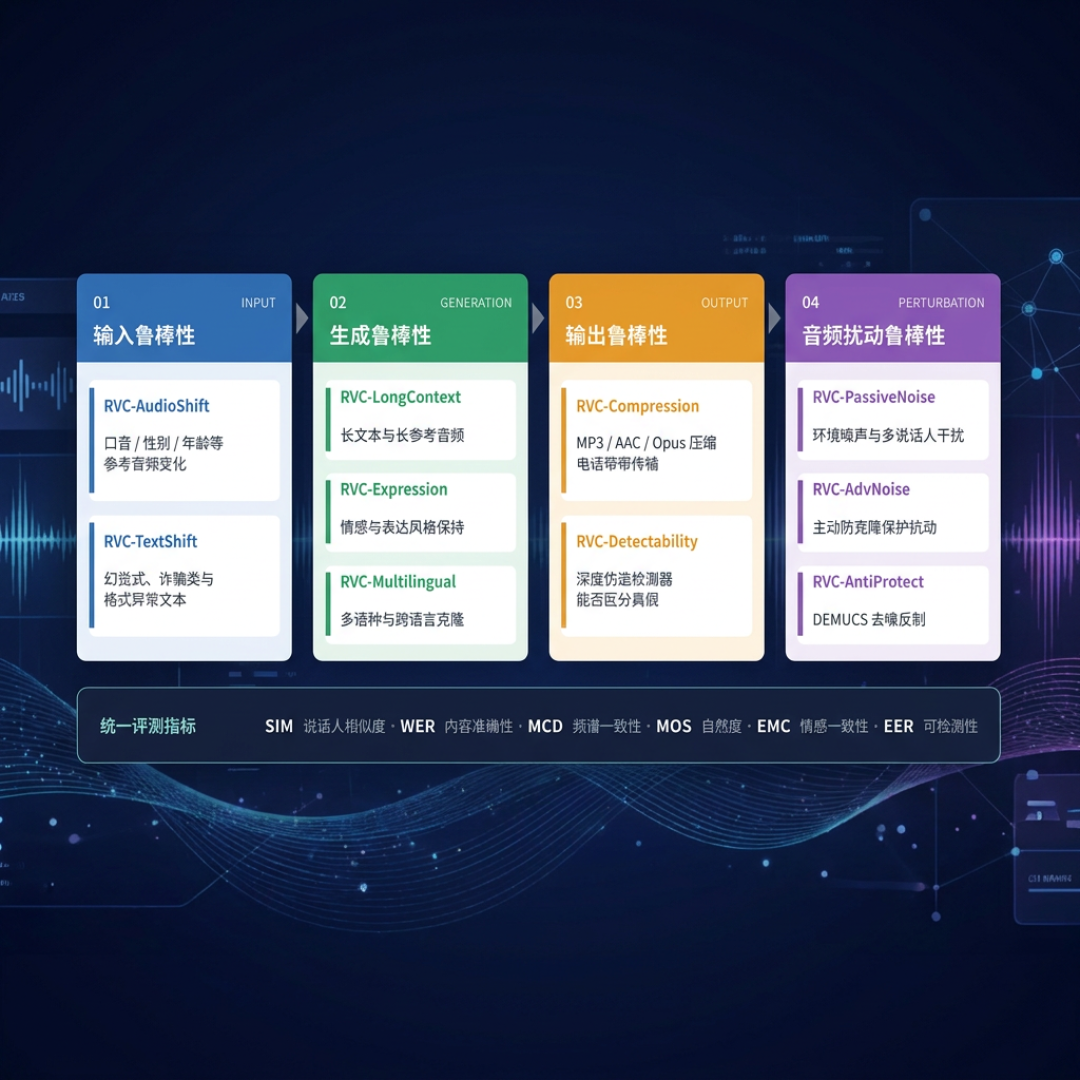
第二道:效果账,用8-12秒校准预期。 UBC和Vector Institute的研究团队提出的RVCBench已被NeurIPS 2026收录,当前版本共18项鲁棒性评测、覆盖10类任务和14370个评测样本,去重后204名独立说话人。参考音频从几秒加到8-12秒,音色指标快速改善,超过这个范围收益逐渐饱和——"3秒克隆"的宣传语和"8-12秒才好用"的实测数据,中间隔着的那段就是评论区翻车的来源。 带混响噪音的参考录音会被原样复刻;异常文本、中英混杂会推高多数模型的WER;生成结果还要再挨一刀MP3压缩和电话窄带传输。云端同样没满分:B站up主实测豆包TTS 2.0,克隆音色与原声几乎无差别,但复杂符号漏读、多音字错6处、英文名翻车、粤语4处跑调。 搬到本地不是消灭这些缺陷,是把调音、选引擎、重试的活从付账单变成你自己干。机器之心哔哩哔哩
第三道:许可账,“开源"不等于"能商用”。 应用本体AGPL-3.0,不改代码直接用没问题;麻烦在权重层——默认OmniVoice引擎代码是Apache-2.0,预训练权重却是CC-BY-NC(非商用),audio tokenizer还叠着Higgs Audio 2和Meta Llama的社区条款。 真要商用,换CosyVoice 3这类Apache-2.0引擎,并逐个在模型管理面板核对许可记录。另一条写进官方文档的红线:克隆他人声音,必须取得本人同意。知乎知乎
这不是杞人忧天——声音这件事,行业与司法都已在给出信号。今年3月配音演员季冠霖控诉声音被AI克隆用于商业合成,马正阳的声音疑被热播剧广告"盗用"接连引发争议。 全国首例克隆声音侵权判例也已经出现,赔钱又道歉。小红书小红书小红书
什么时候该从云端换到本地
云端的账要会看:ElevenLabs这类服务按字符/按月计费,且计费单位有字符、音频token、转写秒数三种,不是同一种单位,不能直接比较裸数字,要以逐请求账单为准。 云端贵成行业天花板——ElevenLabs据报道已在员工股份二级交易里喊到220亿美元估值——这恰恰是本地方案涨星的土壤。知乎知乎
本地这边是一次性投入:约7GB起步的磁盘、首次部署的下载时间、之后的电费,按量不收费,素材不出门。所以分界大致是:偶尔配一两条口播,云免费额度足够,别为它腾10GB硬盘;高频口播博主、有声书作者、手里有采访录音和未公开样片不敢上云的,本地划算;要把语音写进程序或Agent的,OpenAI兼容接口+MCP让迁移只剩一行base_url。
还有一笔所有人都欠着的账:门槛下降是双向的。AI拟声冒充"家人打电话借钱"的骗局已在全国多地发生——电话那头声音、语气、口头禅都对得上,可这个声音可能是AI学出来的。 RVCBench甚至把"防克隆"也做成了评测环节:用SafeSpeech等对抗扰动保护参考音频,再看DEMUCS去噪能不能"破解"这层保护——别只靠声音一条线确认身份。 给家人设个只有彼此知道的暗语,涉及转账就换渠道再核实一遍,这比任何检测工具都便宜。哔哩哔哩机器之心
下一步动作
想试:去GitHub Releases拿官方安装包,Windows是MSI、macOS是DMG、Linux有AppImage,或一条官方脚本装好,先用自己5-15秒的干净录音克隆一次,听听多少秒才"像你自己"。 想商用:先打开模型管理面板把每个权重的许可核对完,看到CC-BY-NC就绕开。再等等:Intel Mac用户、Windows on ARM用户、8GB内存贴边的机器,这版都还没照顾到你。值得盯的信号:OmniVoice系权重的商用条款会不会松动、IndexTTS2.5整合包扩散后的质量分层、云厂商对这轮本地开源潮的降价或开放反应。知乎
文字、图像、视频之后,声音是本地AI生成的最后一块常用拼图。这一波里,"把声音喂给AI、给口播找个替身"正在从极客玩具变成普通创作者的标配——只是替身质量好不好,取决于那8-12秒的干净录音;用得心安不安,取决于那行CC-BY-NC你有没有看见。