最近两周,如果你关注 AI 编程圈,大概率刷到过这条新闻:Linus Torvalds——那个说过"AI 是 90% 营销、10% 现实"的人——内核仓库里出现了一个名字带 `-with-llm` 后缀的分支,提交说明里大大方方承认:代码是 Claude Code 在他指导下写的。知乎
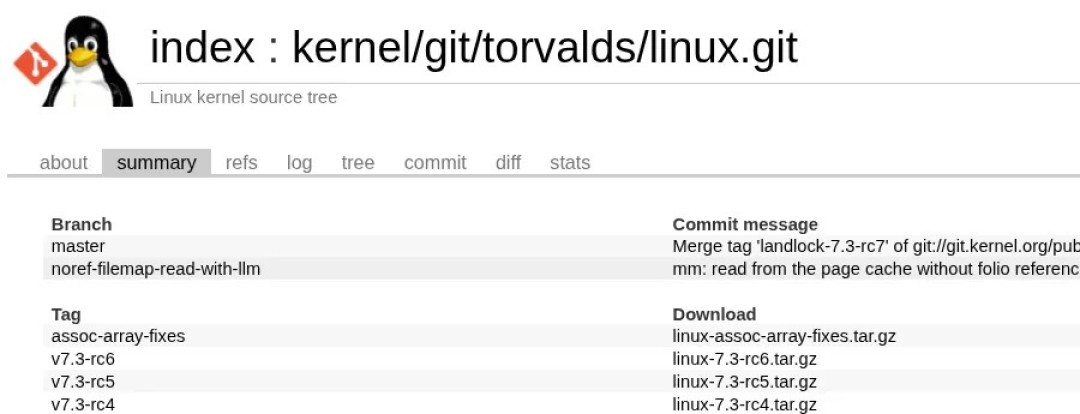
不少媒体的标题是"Claude Code 写内核,性能暴涨 3 倍"。我把补丁提交说明、LWN 的报道、内核邮件列表的讨论复盘,还有知乎微博上的一堆反应都翻了一遍,今天想说句公道话:3 倍是这件事里最不重要的细节。 真正值钱的,是 Linus 这套"让 AI 碰最严肃代码"的完整玩法,以及他同一周发出的那封否决信。
先把事实摆清楚
10 月 10 日,Linus 在内核仓库提交了一组补丁,commit message 的最后一节叫"Tools",原文是这么写的:
The code, the test programs, the review behind the list above and the first draft of this text were done with an LLM coding assistant (Claude Code) under my direction. The measurements were run on my machine.
翻译过来:代码、测试程序、评审清单、连这段提交说明的初稿,都是 Claude Code 在他的指导下完成的;性能测量是他本人在自己机器上跑的。分工写得异常清楚——AI 是执行者,他是负责人。知乎
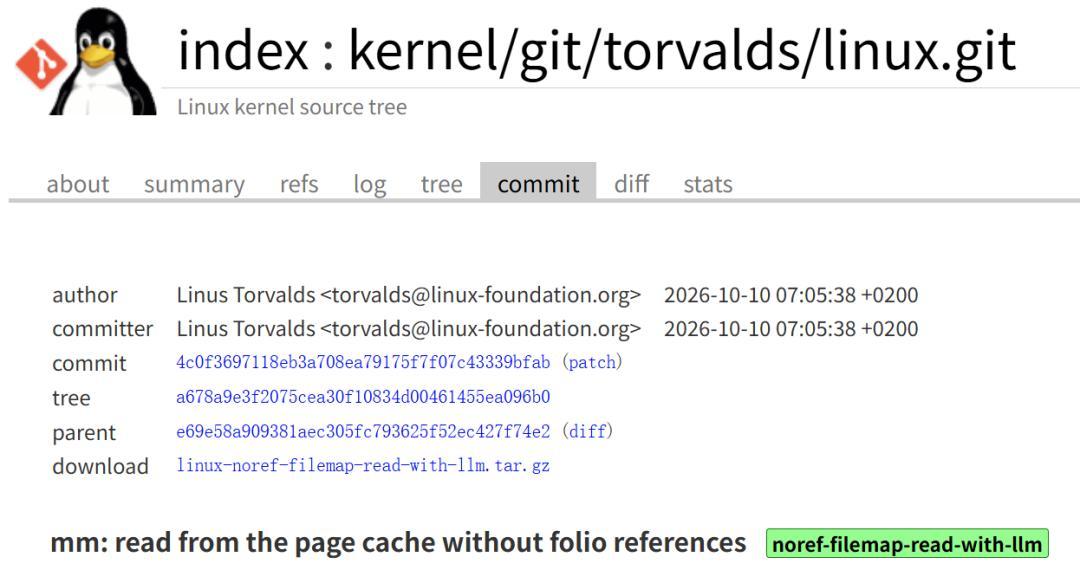
他动刀的地方,是 page cache 里躺了两年多的一个真瓶颈:多个线程同时小块读同一个文件时,内核要反复给同一个内存页加减引用计数,CPU 核心之间为了这个计数器来回抢同一行缓存。在 Linus 的测试机上,这个开销占到全部 Load HITM 的 99.92%——八个人翻同一本书,时间全花在抢那张登记表上,根本没在读书。知乎
这个问题 2024 年就被内核开发者 Matthew Wilcox 从真实客户负载里提了出来:一台每秒写百万条 64 字节日志、偶尔回头查最近几秒数据的机器,卡就卡在这里。之前有人试过"先拷贝再验证"的快速读方案,但页可能被释放、复用、迁移,边界情况覆盖不全,一直没落地。知乎
Linus 换了个思路:页从缓存里移除后,延迟一个 RCU 周期再真正释放,读取方在保护区间里直接拷数据,根本不碰引用计数。之前方案里所有"验证难"的问题,被"延迟释放"绕开了。
"3 倍"到底是怎么回事
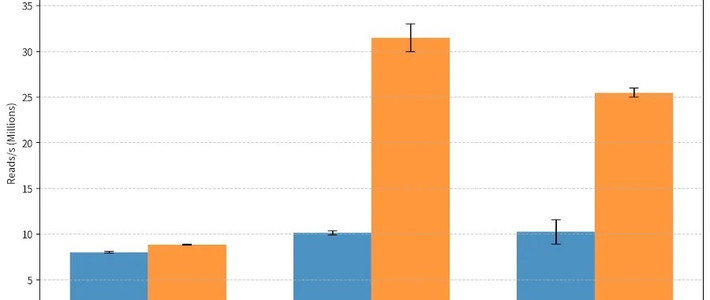
测试机是 Linus 自己的 i7-8565U 笔记本(4 核 8 线程,ext4 文件系统),测试方法是 8 个线程对同一个单页文件反复做 16 字节读:吞吐量从约 1000 万次/秒涨到约 3000 万次/秒,每次读消耗的内核周期从约 2950 降到 725。知乎
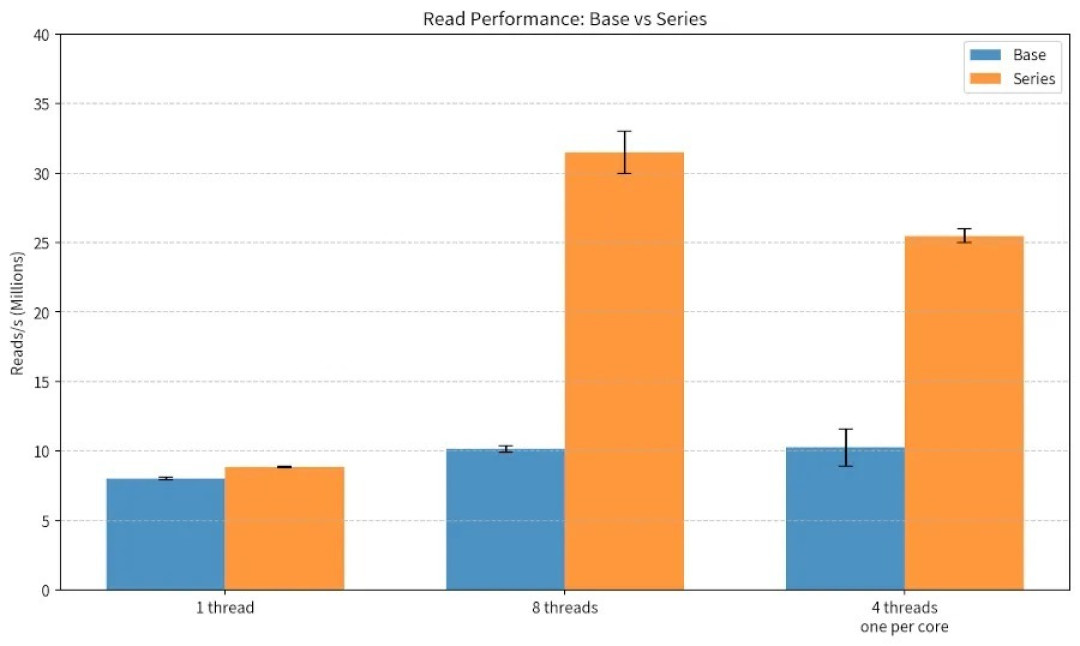
注意三个边界条件:第一,这是专门把引用计数争抢拉满的极端场景,收益集中在"多核抢同一个页";第二,单线程提升只有一成左右;第三,Linus 自己写明,这个数字只属于他的笔记本和这套 benchmark,更多核、多路 CPU 的机器他没测。知乎
把"性能暴涨 3 倍"转出去的人,基本都没带这三句话。顺带再祛一个魅:后来还有媒体标题写"23 倍性能跃升",那个数字出自核数更多的 Threadripper 平台上 64 线程的更极端测试——3 倍也好 23 倍也好,都是"多核抢同一个页"这一个场景的切面,不是你电脑明天就快 23 倍。知乎
而且这组补丁到现在还没合进主线。10 月 13 日发到邮件列表评审后,很快被人发现了一个竞态条件,还得改。LWN 在报道里称这是他的第一个 LLM 辅助补丁系列——AI 写的代码,一样要过内核那道全世界最挑剔的 review,一样会被打回。知乎
这不是他第一次"真香"
把时间线拉长,这已经是 Linus 今年第三次公开的 AI 协作实验了:
8 月,修 Intel Xe 显卡驱动的黑屏 bug。他在提交说明里管这次叫"来自地狱的调试会话,AI 干了大量苦力活"——逼着 AI 跑了 24 个调试补丁、自己重启了 18 次内核、耗了十几个小时,最后的修复只有一个词:把 `round_up()` 改成 `round_down()`。这个 bug 从 2024 年 9 月的一次重构起,潜伏了近两年。他还爆料了一个细节:AI 几次想放弃,说这玩意儿没法解,但他一推,AI 就老实继续加调试代码、如实分析。最后那条提交说明,他干脆让 AI 自己写的。知乎
10 月,顺手挖出 2013 年的三笔旧账。page cache 补丁前后,assoc-array 这个 2013 年合入内核的老库收到一份 bug 报告,代码晦涩到 Linus 都懒得跟。他让大模型把庞大函数拆开、放进用户态测试框架里跑,结果不仅确认了报告的问题,还额外找出 3 个 bug——四个全能追溯到 2013 年这个库第一次合入的那次提交。其中一个是根节点拆分时索引位段错位,18 个键就能复现:存进去的对象查不出来,重新插入还不能替换。知乎
10 月 23 日,还在继续。他又在用 Claude 做大规模重复性代码迁移——淘汰内核里 `__get_user()` 和 `__put_user()` 这两个古老的内存访问宏。Linus 自己的形容是:这类活儿正好是 AI 的主场,像一个"增强版的 Coccinelle"(内核社区用了多年的自动重构工具)。按社区盘点,相关提交已有 48 个左右,改动会体现在 Linux 7.4 里。微博小红书
三件事,一个模式:AI 干没人想干的苦力(重复调试、拆烂代码、大批量迁移),人干判断(问题在哪、改得对不对、要不要签字)。Arm 内核开发者 Lorenzo Stoakes 在 LWN 上的说法更传神:LLM 在内核开发里最像的角色是"数字猎犬",不是同事——猎犬不替猎人开枪。知乎
被所有标题党漏掉的,是那封否决信
10 月 19 日,Meta 工程师 Kiryl Shutsemau 把这个系列重做成一份 18 补丁的 RFC 发到邮件列表,其中 7 个补丁由 Linus 本人署名,每个补丁说明里都带着 `Assisted-by: LLM` 标签。真正热闹的只有 3 封邮件、2 天、3 个人,但信息量极大。知乎
13 号补丁是个微优化:读文件时内核每次都要把读取结束位置写进 `f_ra.prev_pos`,补丁建议"值没变就不写",理由是读经常从同一个偏移开始、这个值经常不变。
Linus 的回信就两句话:
This seems silly. That “often stays the same” is only true for the pointless benchmark, no? I don’t think it’s ever true in any real load.
——"值经常不变"只在那套没意义的 benchmark 里成立吧?我不觉得它在任何真实负载里成立过。知乎
讽刺的是,那套"没意义的 benchmark",正是整个补丁系列用来证明收益的 16 字节重复读测法。Linus 比谁都清楚这些数字多好看,也比谁都清楚真实程序不长这样。一个连用两个月 AI、亲手签了 7 个 AI 辅助补丁的人,同一周里用"真实负载"这个判据,枪毙了一个在 benchmark 层面完全说得通的优化。
这封否决信,比那个 3 倍有信息量得多。
为什么 Linus 不会掉进"用 AI 越来越累"的坑
知乎上有个问题叫"为什么用 AI 写代码之后,人反而越来越累了?",有条回答的浏览量超过 57 万。结论扎心:AI 省掉的是体力活,增加的是认知负荷——一次吐几百行,判断、检查、返工全压在人身上,每个人都成了全职代码审查员。知乎
对照 Linus 的玩法,你会发现他的认知负荷没有爆炸,因为他把"验证"这件事先做便宜了:
第一步,每一步都有能自动判对错的验证。page cache 优化有 benchmark 数字说话;assoc-array 有用户态测试框架,跑一遍确认一个 bug、再挖出仨;Intel 黑屏有 18 次重启换来的 trace。AI 的话从来不用"信",只用"验"。
第二步,分工焊死。AI 写代码、写测试、写文档初稿;人定方向、做终判。8 月那次,"哪段代码有问题"是 Linus 定的,"怎么把问题扒出来"才是 AI 干的——这两件事搞反,就是另一类开源圈事故新闻了。
第三步,责任落到具体的人。内核的铁律是 Signed-off-by,AI 没有法律身份,永远签不了这个名。这组补丁的签名是 Linus Torvalds 本人。而且内核社区 4 月就和维护者们定过原则:可以用 AI 工具,不接受 AI 垃圾,出错由人类负责。社区现在甚至还在争论 `Assisted-by: LLM` 标签该不该保留——规则还在长,但"人签字、人负责"这条底线没动过。知乎知乎
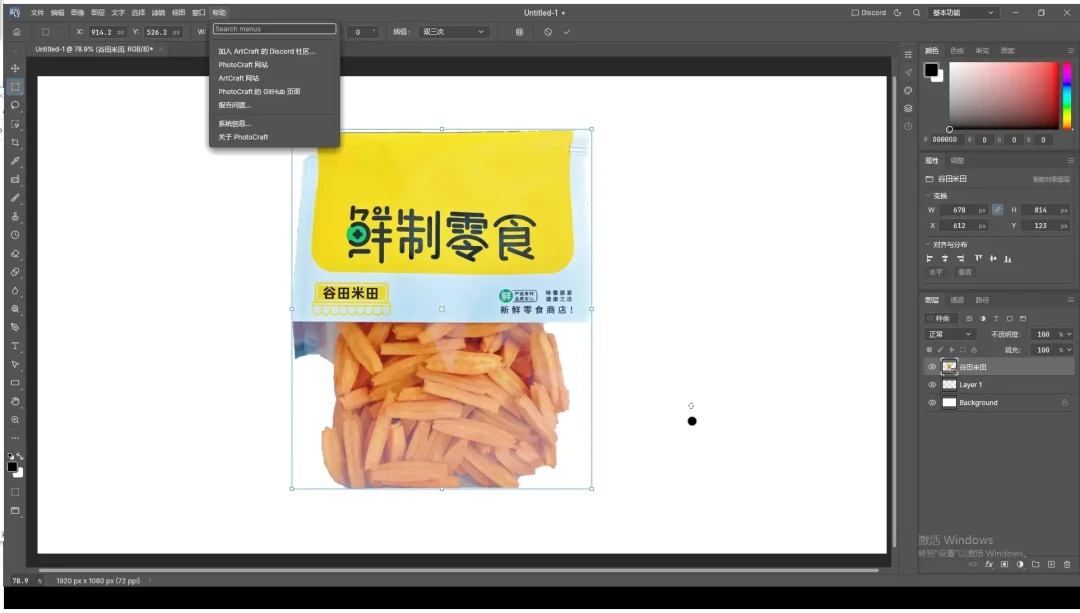
这套逻辑在另一个阵营也有佐证。10 月初 Zed 团队开源了一套对标 Adobe 的桌面应用,知乎上有人把 7 个仓库的提交记录全拉下来统计:9 天 5844 次提交,64% 带 Claude 共同署名,进度甚至不按人天算、按"agent 小时"算。但这个人分析完给出的关键结论是:这套玩法能跑通,不是因为模型强,而是因为团队准备了 170 个真实 PSD 测试文件,渲染结果和 Photoshop 一比就知道对错。目标清楚、验证自动,AI 的产能就是另一个量级;验证靠人眼,用 AI 就是给自己上刑。知乎
对你我意味着什么
如果你正在犹豫"要不要让 AI 进自己的正经项目",Linus 用行动给的判据,比任何工具横评都实在。动手前问自己三个问题:
对错能不能自动判?有没有测试、benchmark、黄金文件,或者至少一个可重复的验证步骤?没有的话,先花时间把验证基建补上,再谈提效——这才是最该花钱花时间的地方。
目标规格清不清楚?“什么是对的"要能写下来。AI 最擅长答案明确、能自动检验的活儿,最不擅长"需求你自己猜”。
出了错谁签字?如果答案是"提交的人",那每一次提交你都得看得懂、审得动。这既是认知负荷的底线,也是责任的底线。
后面还有几个信号值得盯:Linus 那组 page cache 补丁修完竞态条件后能不能合进主线;内核社区对 `Assisted-by` 标签的去留讨论(10 月 13 日 Phoronix 刚报过一轮);以及会不会有更多子系统维护者跟进。知乎
如果这组补丁最终合入,那会是 AI 编程在"严肃工程"领域拿到的最硬一次背书——不是因为那个被转烂了的 3 倍,而是因为它过了内核 review 这一关。到时候,"Linus 都在用"才真正配得上它现在的转发量。