你一直住在别人家的机房里
云端模型的每个 token 都是租来的。10月13日,两条新闻前后脚落地:一条,阶跃发布"大模型原生智能体手机"STEPX Neo,购机送12个月、每月100亿Token;另一条,面壁智能开源 MiniCPM-V4.7,官方称总参数 35B 的模型,手机上约 3GB 内存就能跑。一个在卖你云端的流量,一个在把机器装进口袋。本地党该看哪条?答案是先看后者,再看穿前者。知乎
35B 塞进 3GB,是账不是魔术
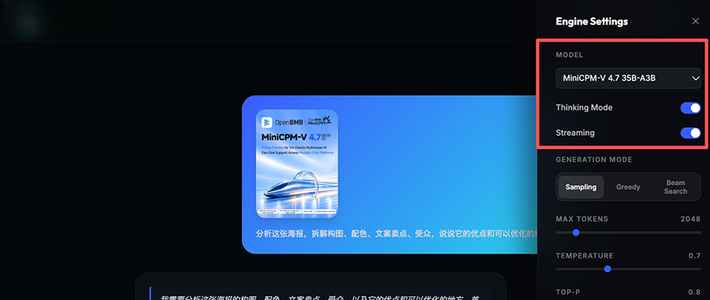
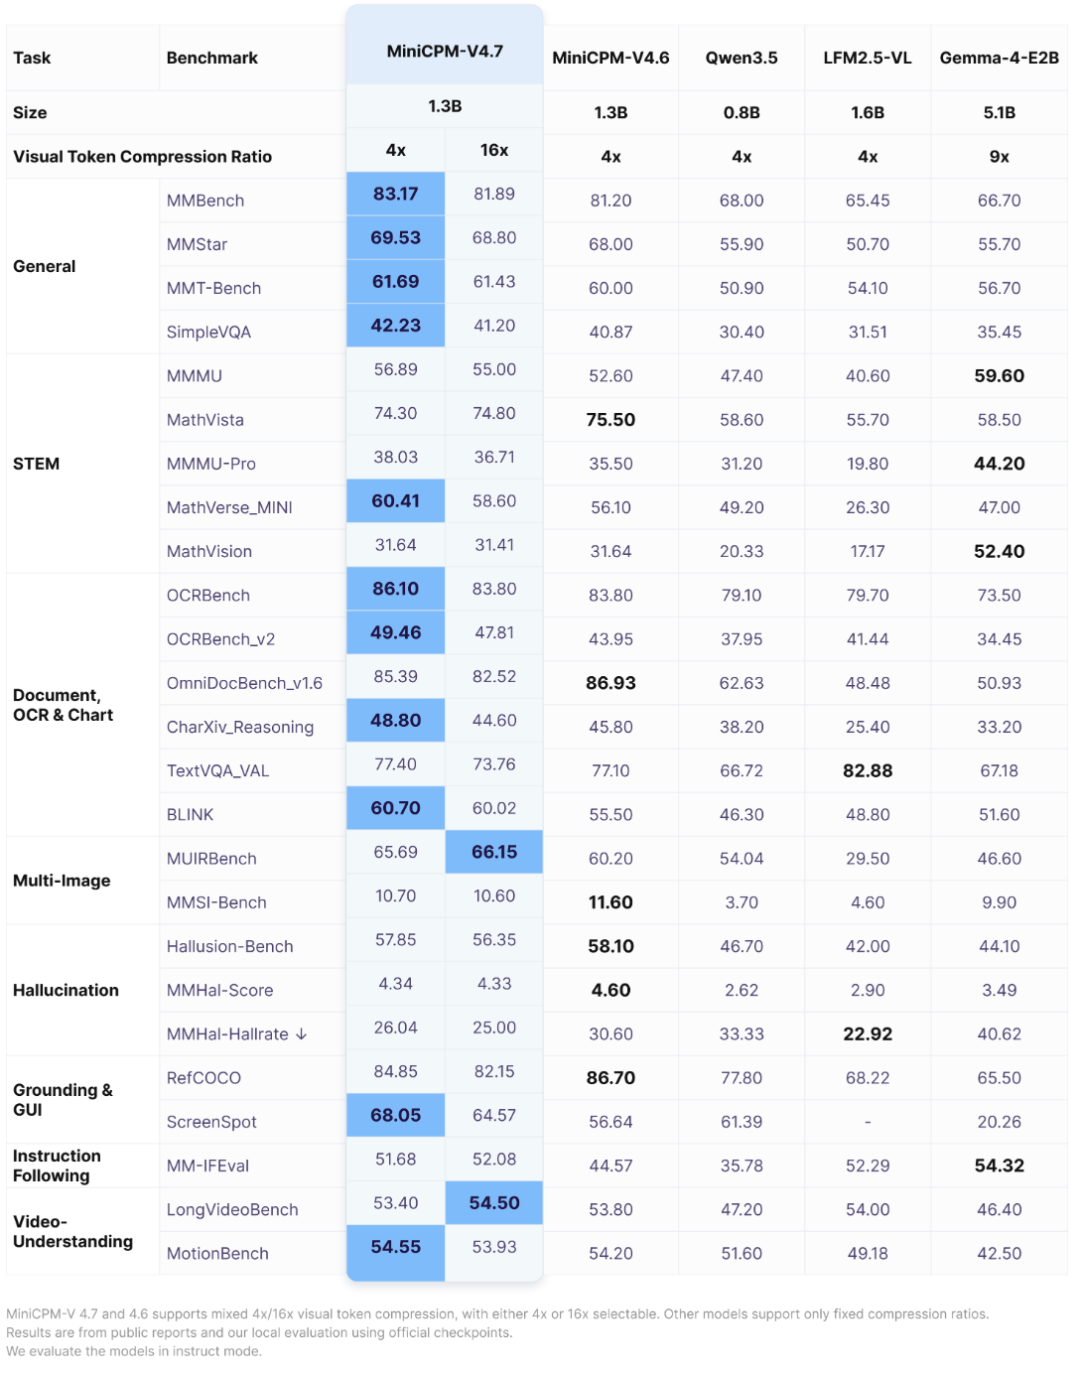
MiniCPM-V4.7 的 35B-A3B 是 MoE:总参数 350 亿,每个 token 只激活 30 亿。装不装得下,看三件配套技术:前瞻专家调度 LES 提前预取下一层要用的专家、细粒度逐层量化把专家权重压到内存装得下、推测性采样 DSpark 补解码速度。

官方实测口径:iPhone 17 Pro Max 上用 3GB 内存跑到超 13 tokens/s,iPad Pro 超 15 tokens/s。丑话说在前面:这是发布会当天的官方数据,第三方真机长测还没铺开,引用时请自带这个限定。智东西
"跑得动"和"能干活"隔着一个生态
有开发者在 8GB 内存的小米手机上,只下载约 672MB 的 Q4_K_M 语言模型,拿天气解析任务实测新出的 1B 版:模型能加载、能推理,但会冒英文拒答、在 JSON 外多吐工具调用标签、编出协议里没有的字段值。作者的结论很克制:不改引擎、不改提示词直接换模型,暂时没有收益,而这只是小样本兼容性测试。端侧模型的坑不在参数,在换模型那一下的适配成本。知乎
最蠢的坑往往最致命
有人在一台 2019 年的 Pixel 4(骁龙 855)上跑通了完全离线对话——App 安装包里根本没申请联网权限,开飞行模式照聊。第一版 0.5 字/秒,几乎不可用;查了好几天,元凶是构建时没开任何编译优化,改一行配置加上最高优化档,快了 37 倍。这周的端侧热闹也都在这一层。MNN Chat、PocketPal 的装模型教程刚被做成视频。谷歌 Gemma4 手机本地部署的汉化版也有人上手。用骁龙 NPU 本地跑视频模型的实录同样出来了。决定体验的是引擎、量化和构建,不只是芯片。知乎哔哩哔哩哔哩哔哩哔哩哔哩
智能体手机,看穿它不用换机
阶跃这台手机值得看,但要看穿:它的模型矩阵分三档,复杂任务交给云端 Pro,Flash 管平衡,真正留在端侧的 Edge 模型只接即时响应和隐私敏感任务。也就是说,发布会讲的每月 100 亿 Token 本质是云流量包。那条 15 万播放的发布会视频里,高赞评论问得很直接:“没听懂有什么用”。对本地党来说:不用为智能体换新手机,手里的旧手机现在就能开始装东西。36氪哔哩哔哩

下结论:过了能用线,别急着全替换
端侧本地模型这周确实过了"能用线":速度口径进入可用聊天区间,"数据不出门"有了物理层面的实锤。但功耗发热在这周公开实测里几乎没人报,官方演示也暴露过输出长度上限。所以建议分两句话:隐私敏感、信号差、有闲置旧手机的,先用 1B 到 3B 的小模型加 MNN Chat 或 PocketPal 把玩起来;想靠它替代云端订阅的,等第三方长测报告出来再动也不迟——反正开源模型不会涨价,急的是内存条。知乎智东西