10月23日,陶哲轩把话挑明了:AI批量产出的这些数学成果,是"有毒废料"。从"坐不住"到"不买账",这位菲尔兹奖得主、曾经对OpenAI最友好的数学家,用了不到两年完成态度转向;距离他10月7日在博客全文转载那份抵制声明,也才过去16天。微博
如果你是ChatGPT/Codex重度用户,这一个月大概被两种标题来回轰炸:“AI攻克千禧年难题"和"数学家集体抵制OpenAI”,看完全不知道信哪个。知乎主问题浏览量突破1100万,光"AI数学"相关破百万浏览的问题就有5个——吵成这样,恰恰说明没人把事实层给你捋清楚。知乎
先把18天时间线摆直(这是任何单条推文给不了你的)
9月8日:OpenAI公布其内部AI系统对纳维-斯托克斯(Navier-Stokes)方程千禧年问题的"候选证明"——据当时报道,用了约1万个智能体、88小时。
9月12日:包括陶哲轩在内的25位菲尔兹奖得主联名发表公开信《人工智能在数学中的严重错位》。他们的火点不是"AI太强",而是数学被当成商业公司的基准测试和公关素材。中国新闻网
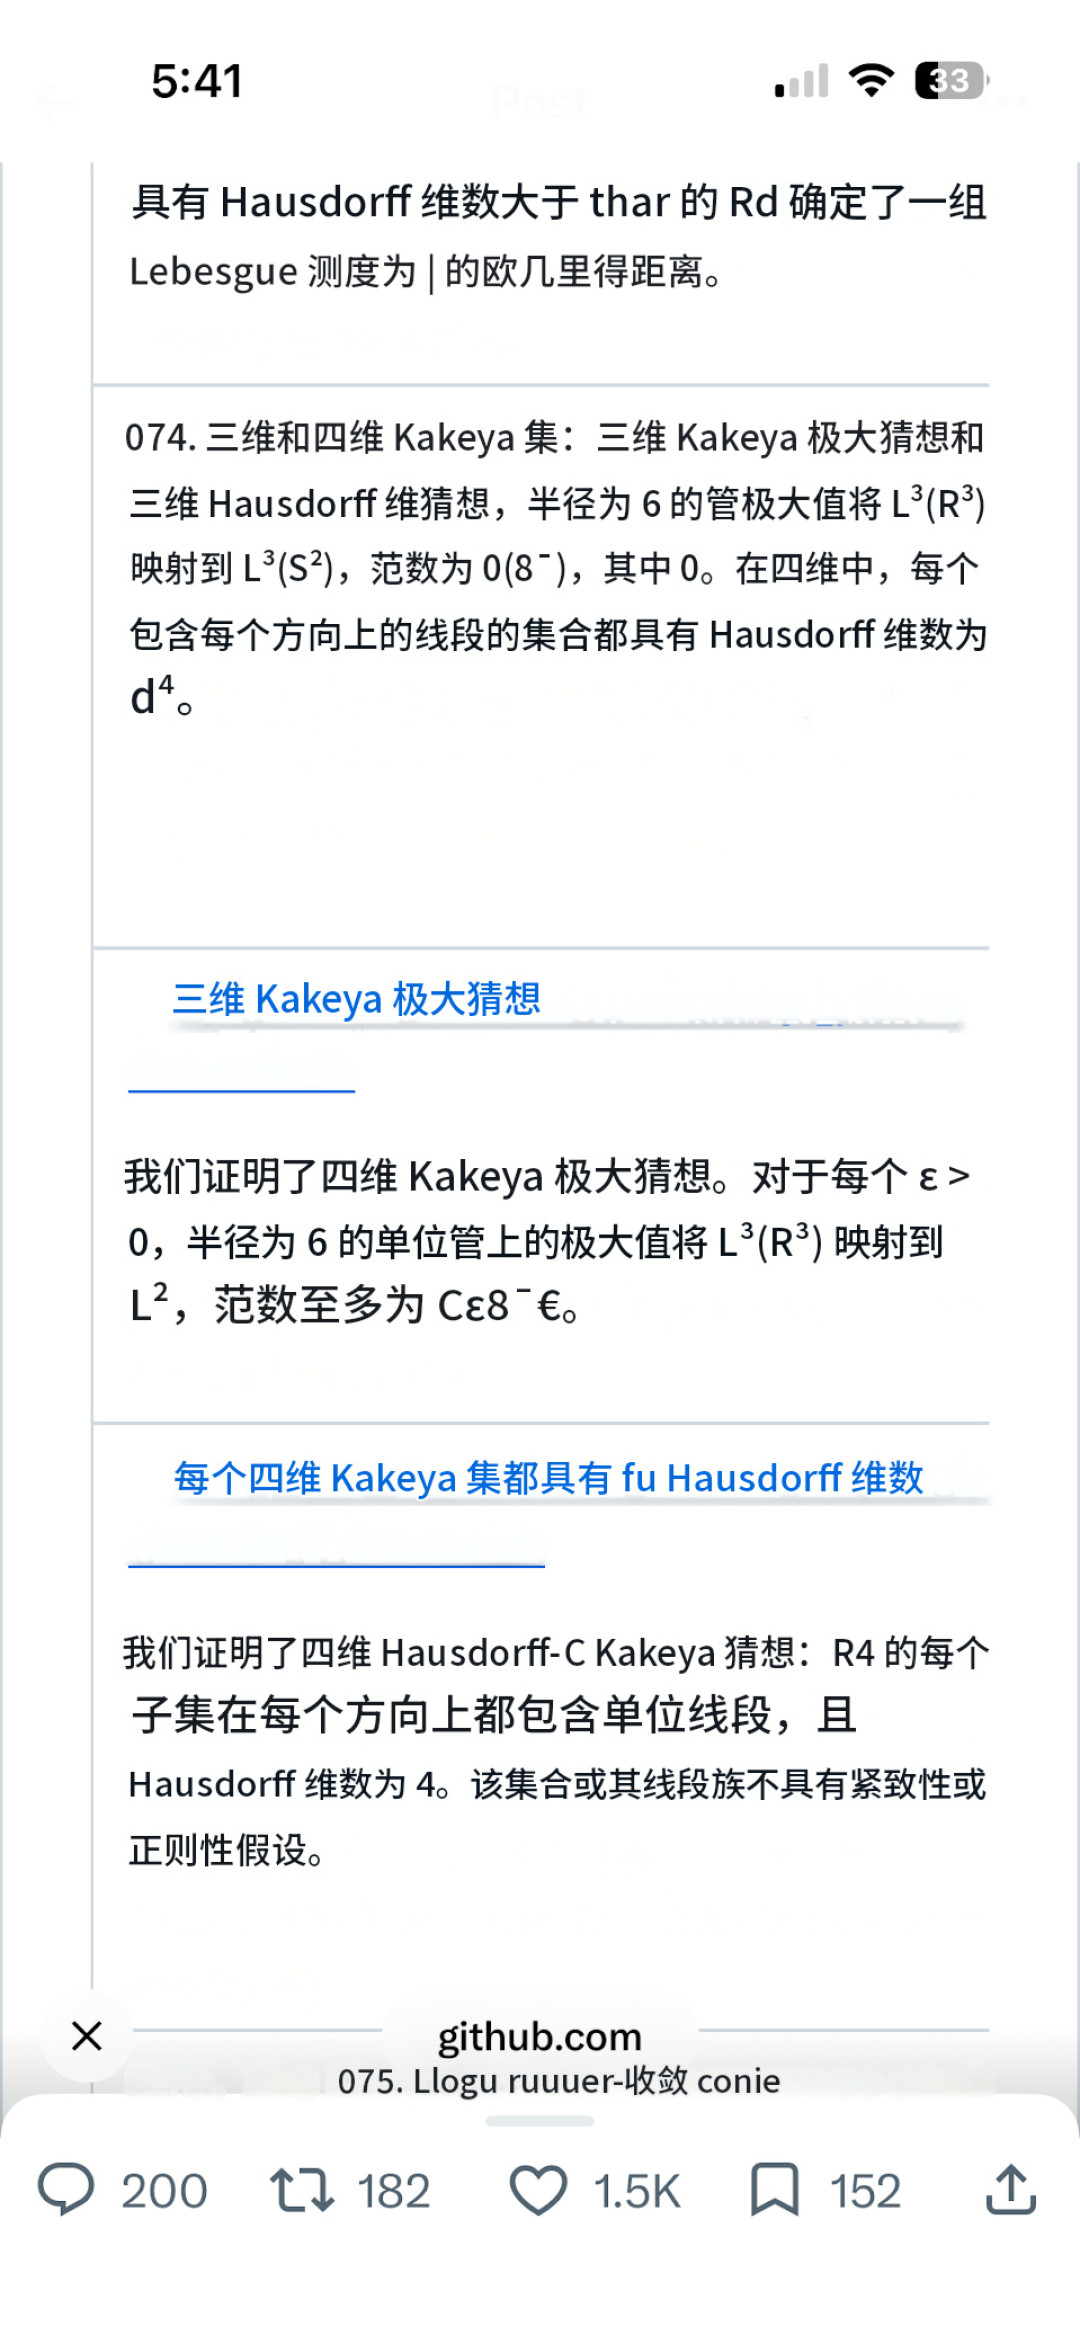
10月6日:没有发布会、没有预热搜。OpenAI直接把 openai/math 仓库挂上GitHub:一夜放出722份手稿、372个成果族,出自未发布的内部模型。准黎曼方向的零自由区域、175页的四维挂谷猜想证明稿、Mahler猜想、在外力NS方程中实现通用计算——全在这一个仓库里。GitHub
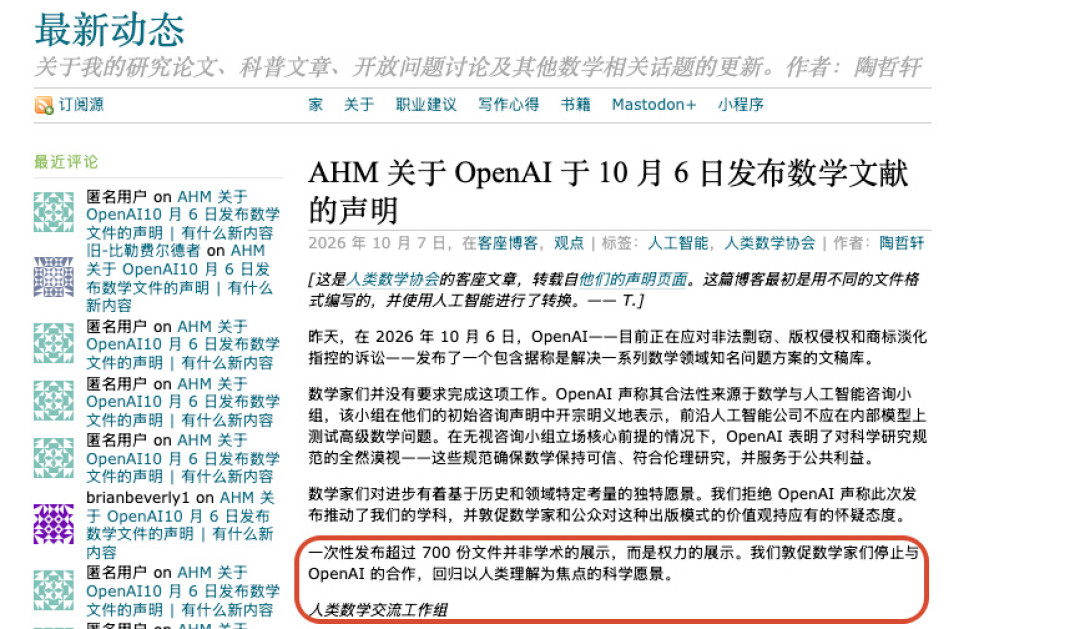
10月7日:陶哲轩博客全文转载"人类数学协会"(AHM)声明,声明强烈敦促所有数学家停止与OpenAI合作,“重回以人类理解为核心的科学愿景”。同日《华尔街日报》拆解了整个事件:OpenAI承认是在听说Anthropic已解决至少一道千禧年难题后,才砸下数百万美元算力开始攻关;数学顾问委员会建议它停止用专有模型测试高等数学,它没有接受。微博微博
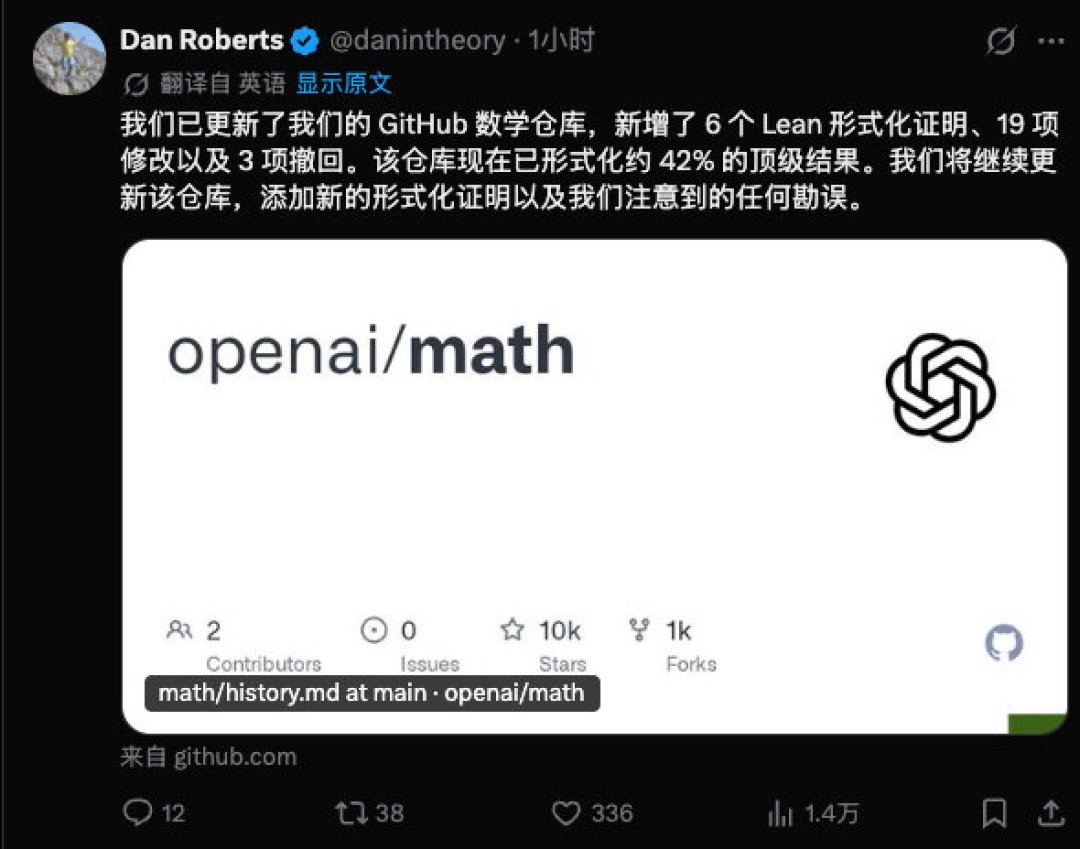
10月9日:社区核查密集出现:GitHub仓库 history.md 里记着新增6个Lean形式化证明、19项修改、3项撤回(正负号级别的低级错误就在其中);另有博主发现部分形式化证明存在"定义覆盖"问题——Lean验证通过的,未必是悬赏清单上那道原题。
10月14日:针对9月那份NS"候选证明",社区进一步指出它没有按千禧年问题的精确表述作答,"攻克"的口径被冲淡,相关讨论冲到248万浏览。知乎
10月17日—22日:陶哲轩"数学的田园牧歌时代结束,工业化已经开启"的说法传开;《纽约时报》刊发他的长篇专访,写下一位数学家面对AI"从好奇到兴奋,从兴奋到愤怒,从愤怒到无力,最后陷入集体迷茫"的存在主义转向。微博
10月23日—24日:对冲信号密集出现——一边是"有毒废料"的定调;另一边,OpenAI研究员、理论物理学家文·钱德拉塞卡兰公开说:他和Codex来回打磨三四个月,找到了他估计单干要20年的黑洞信息悖论解法,并且主张"人选问题、定假设、判证据,AI做推导和计算"。奥特曼同天放话:OpenAI内部实力,现有公开模型难以企及。36氪
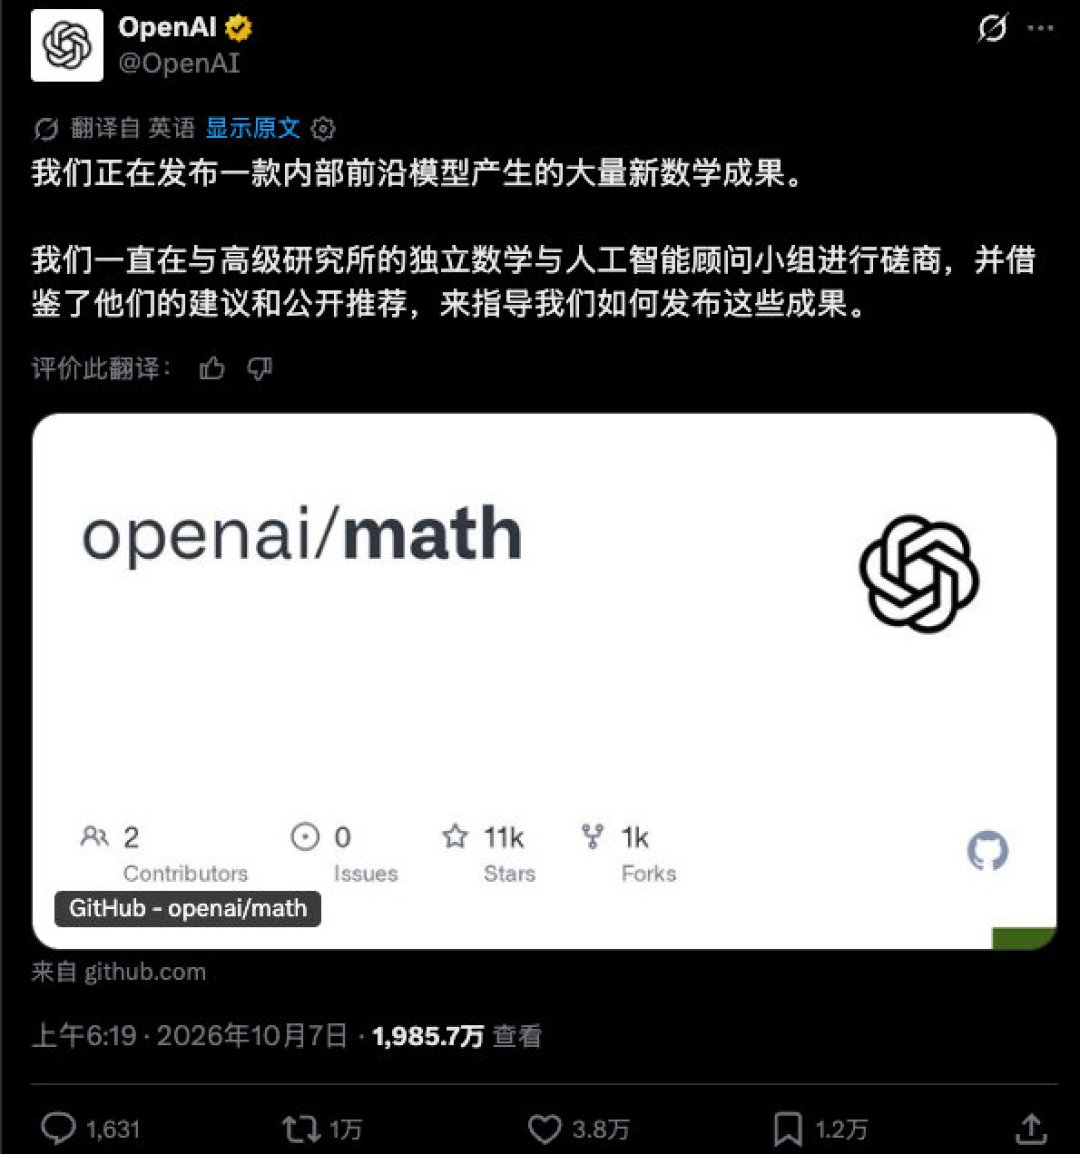
仓库里现在到底有什么:三个官方口径的硬数据
抵制归抵制,仓库是公开的,数字比任何转发都诚实。我把 README 和目录翻了一遍:
目前目录实存719份手稿、372个成果族——比10月6日首发少了3份,对应的是撤回;README原话摆得很直白:不同验证阶段都有,“部分未形式化的结果可能存在问题”。GitHub
约42%的"top-line results"完成了Lean形式化,仓库设有专门的 lean 目录和 formalization.yaml 验证清单;模型总共被喂了约4000道开放问题,平均每个结果烧了3小时的ChatGPT Pro思考算力。
只有10个成果附带了推理过程摘要(reasoning_traces),像Mahler猜想、π的无理性指数这种被点了名的结果,目前也只有"摘要"可看。
这三条放在一起看,结论就清楚了:OpenAI给得起算力,给不起"被理解"。 它自己都在README里承认结果分三六九等,而整个仓库至今没有一份外部数学家的正式评审意见。
噪音在哪:三个被标题党用混了的词
第一,"解决"和"被接受"是两回事。 一份证明从被生成,到被理解、验证和接受,中间隔着验证、理解、同化三道闸——南方科技大学研究流体的数学家李林峰在访谈里问的就是这个。罗格斯大学数学家Alex Kontorovich对《华尔街日报》的说法更值得玩味:那份零自由区域成果"如果是人做的,够得上一块菲尔兹奖"——注意这是评价,不是接收单。知乎
第二,“通过Lean验证"不等于"证了原题”。 Lean只检查逻辑链条,如果提交的定义被覆盖成了另一个版本,验证器照样绿灯——它验的是自己看到的那道题,不是悬赏的那道。NS"候选证明"没按千禧年精确表述作答被指出的,是同一类错位的宏观版本。同样要记住反证:目前并没有人宣布NS或挂谷证明存在逻辑错误,"反转"反转的是口径,不是对错。
第三,撤回率低不等于可信。 722篇首发隔天撤3篇、后续19项修改,出错率不到0.5%,工程上很漂亮。但数学共同体的瓶颈从来不是抓错,而是消化——全球有能力读这372个成果族的人可能不足几百位,没有人欠OpenAI一个审稿义务。陶哲轩转发过一条恶搞梗:“OpenAI发布500部未上映电影的最后十分钟”,两天后他又转了续集"撤回其中三部结局,对剩下的497部充满信心"。笑完之后是他的正经判断:过去一个猜想被证出来,会带来讲座、合作、新人入行;现在问题被AI批量解决,人却看不懂结果,开放问题的解在被"大规模收割"。10月23日那句"有毒废料",就是这个逻辑的终点站。
数学圈真的"反AI"吗?拆成三派再看
把抵制理解为"卢德分子砸机器"会看错方向,现场其实是三派:
制度抵制派(AHM):争的是规则——不经消化管道、不等验证就批量官宣,会污染引用体系和优先级排序。深圳大学数学学院创院院长张文俊点出的隐忧更现实:数学教育被带偏,学生练"理解"的动力没了。
方法批评者(顾问委员会路线):连OpenAI自己的数学与AI咨询小组都警示过前沿AI直接下场解题的风险,AHM声明抓的正是"你自己顾问的话你没听"。
合作务实派:以钱德拉塞卡兰为代表,分工已经很成型——“人选问题、定假设、判证据,AI做推导和计算”;他甚至反过来劝科学家别拿小问题灌水,把野心对准圣杯。
注意一个常被忽略的信号:领着头转变态度的是陶哲轩——过去每次OpenAI发新模型都第一时间帮忙背书的"圈内最友好派"。最友好的那个人进入"战时状态",比任何一份声明都更能说明冲击是真的。同时《华尔街日报》还埋了一条暗线:已经有学者担心自己的研究被AI"抢发",开始赶着公布AI辅助成果。规则被改写时,最先动的是所有人的发表策略。
给你的判断:一张"AI科学突破"核验清单
以后凡看到"AI攻克XX",先跑这五步——本轮事件每一步都已出真实案例:
看口径:模型公司自宣,还是有独立研究者复核?(本轮:GitHub直发,至今无期刊、无署名评审)
看表述:回答的是否就是官方那道题的精确表述?(案例:NS被指未按千禧年表述作答)
看形式化陷阱:有"Lean验证通过"的,查它验证的定义是不是原题定义。(案例:定义覆盖问题、42%的形式化覆盖率)
看首日勘误率:24小时内的撤回和修改记录,是工程质量的免费体检。(案例:722撤3改19,history.md全程可查)
看接收进度:半年后有没有围绕这批结果的讲座、引用、后续合作长出来。没有,就只是算力展示。
不同人怎么用这条信息
ChatGPT/Codex重度用户:这次真正值得兴奋的不是"AI证了什么",而是OpenAI把未经发表流程的成果直接开源在GitHub。中文导读、逐篇精读系列已经在长(今天知乎还有新篇更新),拿它当"免费验证进度条"——民间读解越密,结果越可信。
科技内容创作者:“攻克千禧年难题"目前不能作为结论级表述引用;安全写法是"发布了声称触及XX的候选证明,验证中”。
数学方向学生/转AI4Math的研究者:答案变得廉价之后,"会读AI手稿、能给AI结果做验证"的人短期只会更稀缺——这是这轮动荡里少见的个人机会窗口。
硬件党:主问题下1862赞的回答喊话"3到5年内有钱就囤高端工作站"。别急,本轮证明来自未发布的前沿模型,不是本地显卡能跑的;囤机的前提目前不成立。
接下来盯这五个信号
NS证明是否有人给出"对齐千禧年表述"的重证,或权威数学家公开复核意见;
"定义覆盖"类漏洞会不会继续扩大、OpenAI是否回应;
AHM的抵制是停在声明,还是传导到期刊、会议和机构合作层面;
OpenAI面临的版权/剽窃诉讼与"抢发学者研究"指控会不会并线发酵;
民间精读系列的更新密度,以及推理摘要从10份扩到多少——这批成果真实含金量的最诚实温度计。
18天下来,能确定的是两件事:AI做数学确实已经强到逼着一个学科共同体公开谈判;而"强"和"可信"之间,隔着整个验证体系。OpenAI这一夜放出的与其说是722份证明,不如说是给所有关注AI的人出了一道阅读理解题——题目是:下一次再看到"AI攻克人类难题",你会不会先跑一遍这五步。