昨天(10月23日)晚上,MiniMax把M3.1 Flash的权重传上了Hugging Face和魔搭:总参数428B,每个token只激活23B。OpenRouter上匿名屠榜了10天的"SpaceBunny"(太空兔)正式现形。官方口径:成本约为上一代M3的1/3、速度约3倍;10月19日上线以来,72小时内真实用户已经喂给它超过100万亿Token。华为昇腾也随即宣布接入。知乎知乎
再往前捋一遍节奏:8月26日,Qwen3.8-Flash-Next开源,125B体量。 10月17日,DeepSeek把V4.1 Flash升级为V4.1-Flash-1017。 GLM-5.3-Flash(320B总参、激活18B)紧随其后,昨晚M3.1 Flash开权重——一个多月里,“Flash段位"的四台旗舰级MoE排着队站上了货架。圈内那句"一周打完年度大战”,说的就是这个窗口期。知乎知乎知乎
每来一台新旗舰,“想自己跑"的人群就激动一轮:不按次付费、不把资料交出去、不限速。但看完上周刷屏的"12G显卡畅跑125B"和昨天的"写代码68tok/s”,真掏钱的人里不少是被打过脸的。这篇把知乎、小红书、B站这两周的实测帖汇总在一起,把真话和水分一起给你讲清楚。
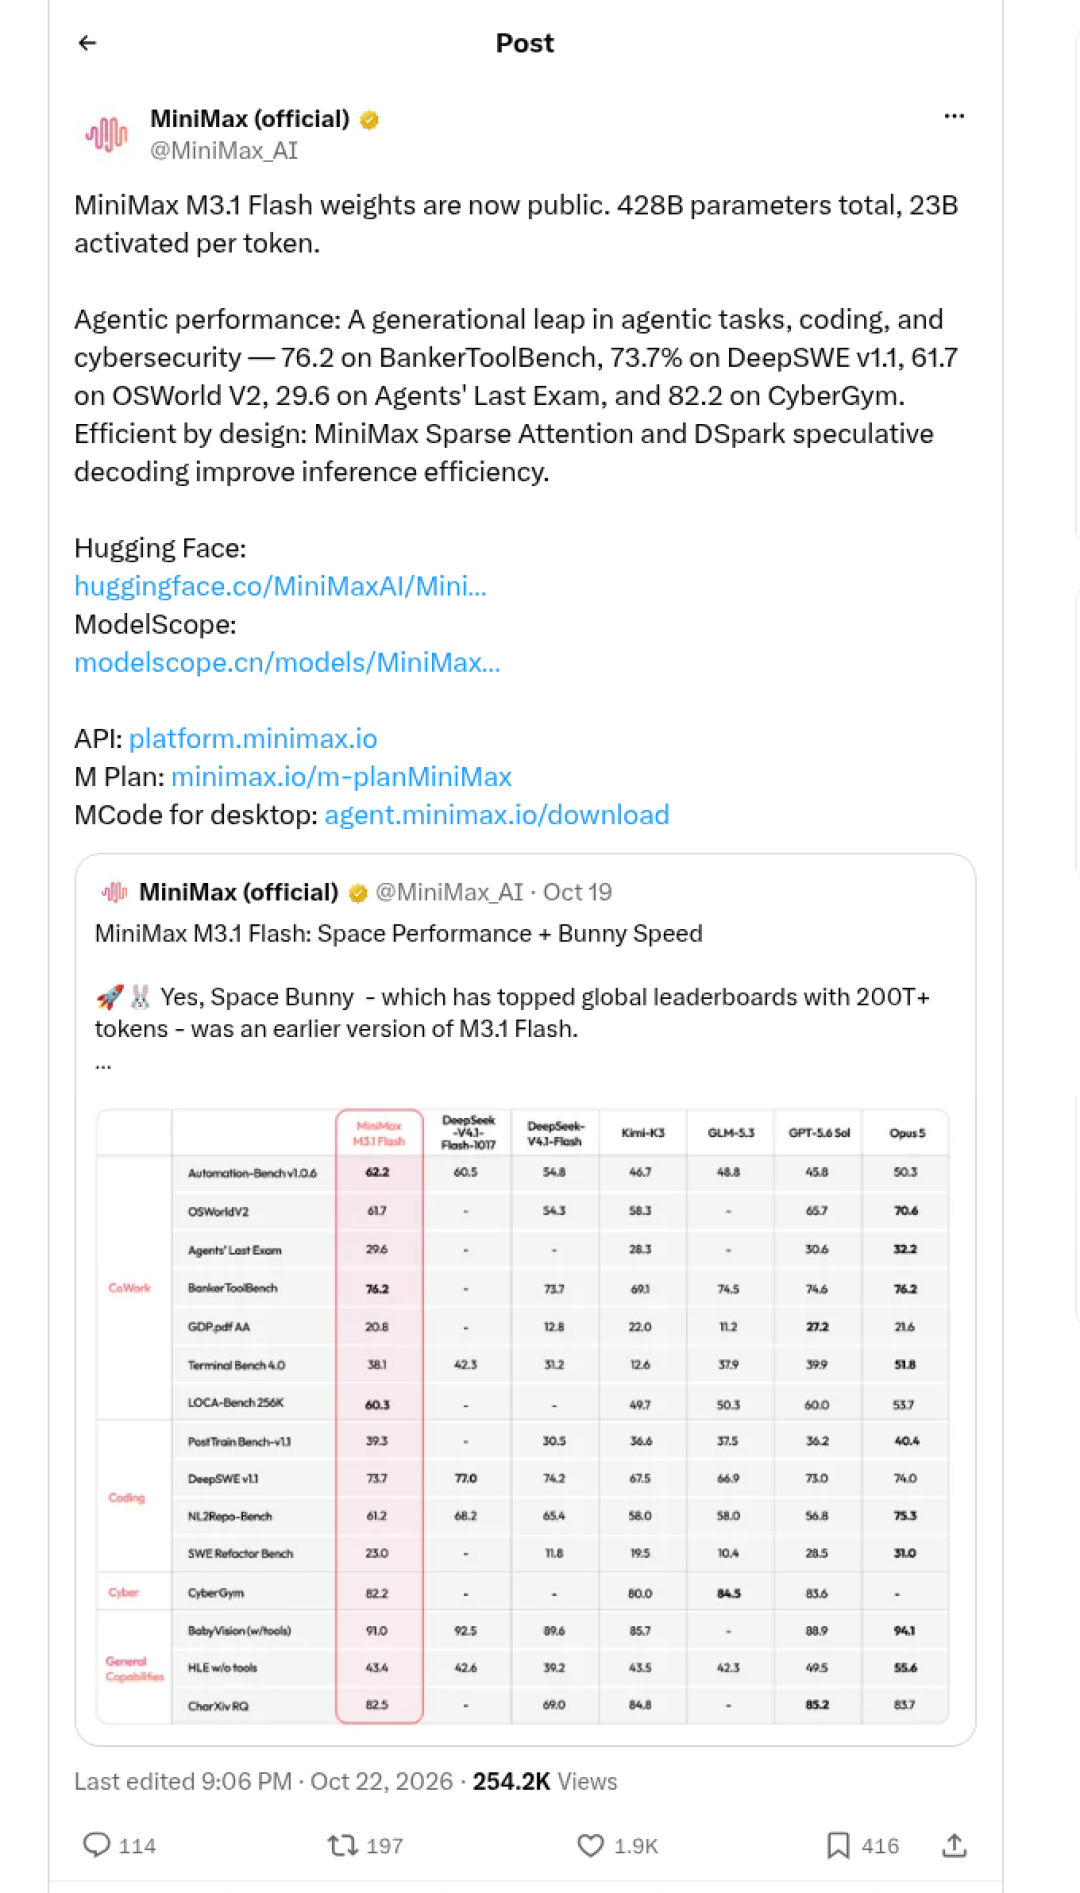 MiniMax官方宣布M3.1 Flash权重公开的帖子实拍
先把"参数通胀"说破:总参数是场面话,装进内存的才是账
今天的"旗舰级参数量"是通胀过的。Qwen3.8-Flash-Next是125B,GLM-5.3-Flash是320B,M3.1 Flash是428B——全是MoE(混合专家)架构:总参数是"仓库规模",每个token真正干活的"激活参数"才是"消费额",Flash-Next的架构拆解帖里原话是"FFN是高稀疏度的小专家MoE",每个token只叫醒一小撮。。这是它们能进家门的前提。知乎
但冷现实在后面:专家可以挑着叫醒,权重得整个装进内存。社区流传的口算公式:Q4量化下,参数量÷2≈权重GB数;日常聊天再乘1.5,跑Agent要乘2——因为KV Cache会随对话动态吃掉内存。。套一下:小红书
Qwen3.8-Flash-Next:125B→Q4约62GB,64~128GB内存+12G以上显存,够得着;
GLM-5.3-Flash:320B→Q4约160GB,基本只有128GB统一内存的AI Max+ 395和256GB内存怪才在牌桌上;
M3.1 Flash:428B→Q4约214GB,家用32G/64G想都别想,只能等官方量化和offload进度。
一句话:本波DIY的甜点位是125B档,428B更多是看热闹。
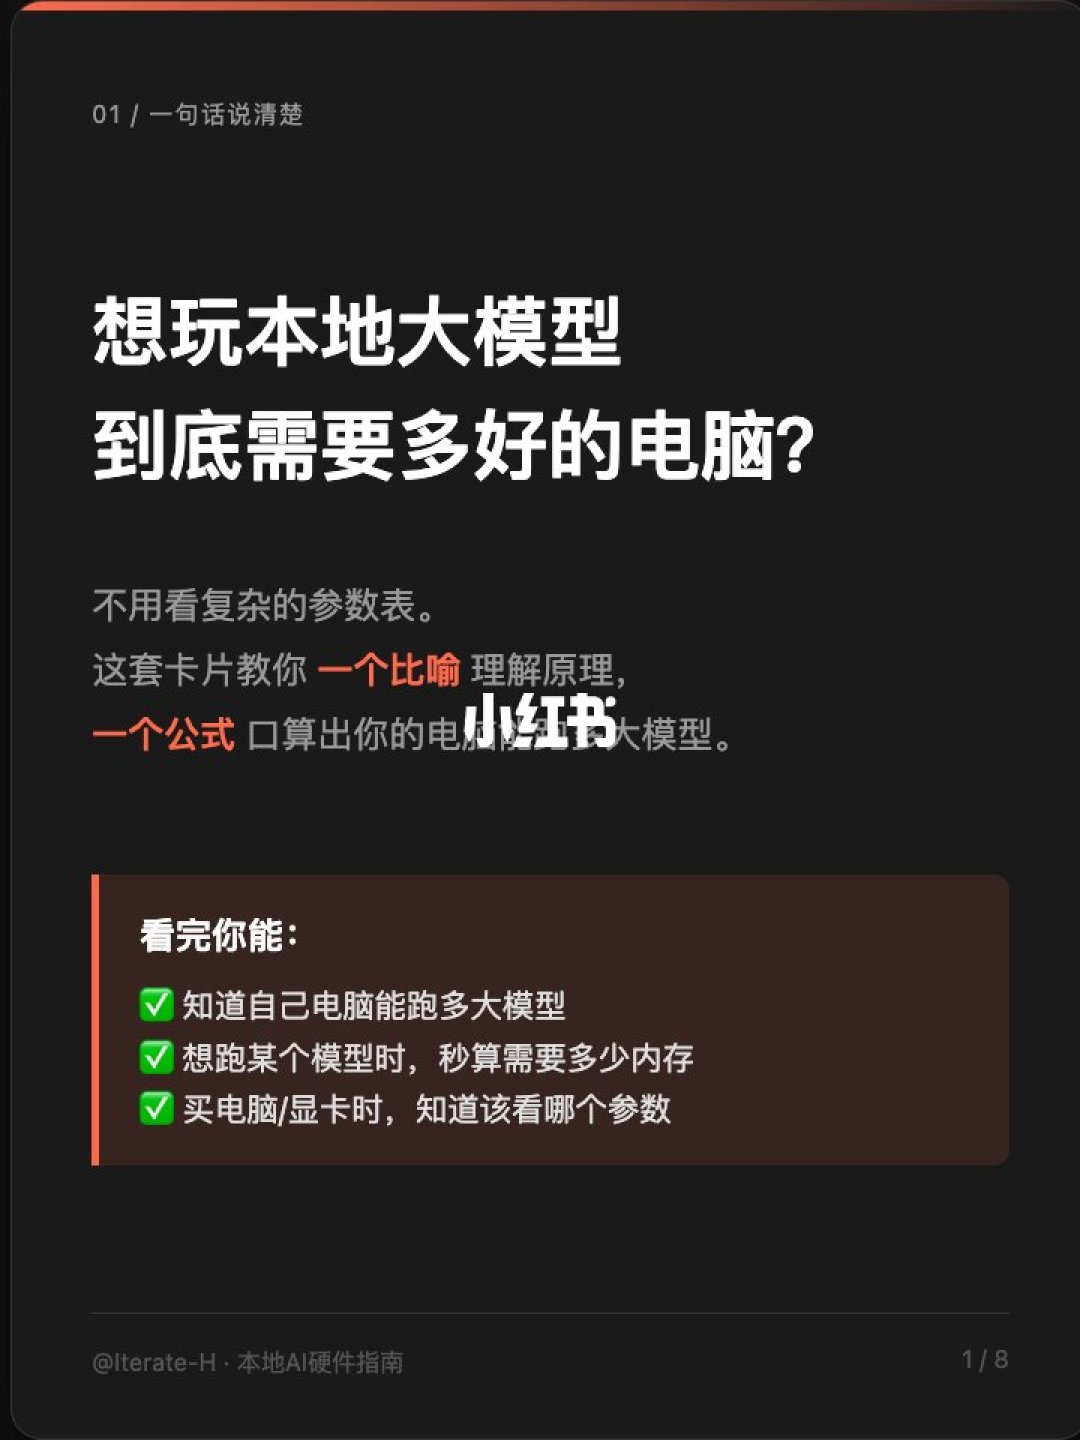 本地跑大模型内存口算公式科普卡片
"12G显卡跑125B"是真的,但主角不是显卡
这个刷屏结论来自开源推理引擎Strata+Unsloth等量化包(unsloth/Qwen3.8-Flash-Next-GGUF的UD-Q4_K_XL,另有IQ3_S版),10月初到昨天,知乎和小红书的实测帖一茬接一茬。几个可查的口径:
RTX3090+2016年的双路Xeon v4老工作站,跑到100+ tok/s,作者强调"零硬件花费"。知乎
16G显存档普遍实测40~50 tok/s。X99平台凑出256G内存+5060 Ti 16G的折腾帖也有;知乎
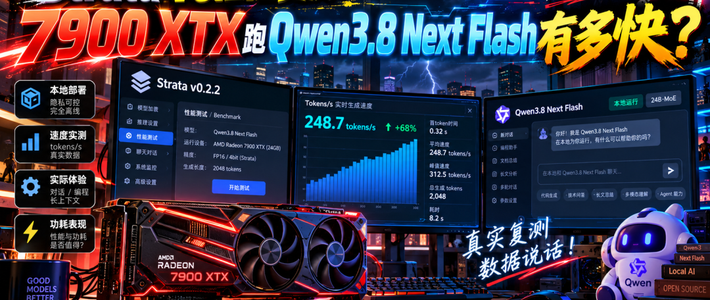
RX7900XTX在Strata v0.2.2下的复测(10月24日发布):限261W功耗时,32K长输入这项46.78秒,但换到代码和连续任务,速度排序会变。;知乎
小红书7860赞的爆款视频标题是"12G显卡畅跑Qwen3.8 Flash、125B体量、96t/s",而这条笔记热评里最高赞的质疑是:“这个文章缺少了太多关键条件,完全夸大了真实的情况!”。小红书
所以不是"别跑",是看清条件再跑:上面这些速度全部建立在"大内存offload+最新量化包+最新引擎"上——截至10月22日,Strata官方最新发行仍是v0.2.2,内置推理引擎还是0.1.47。 96t/s是最好条件,不是你的条件。知乎
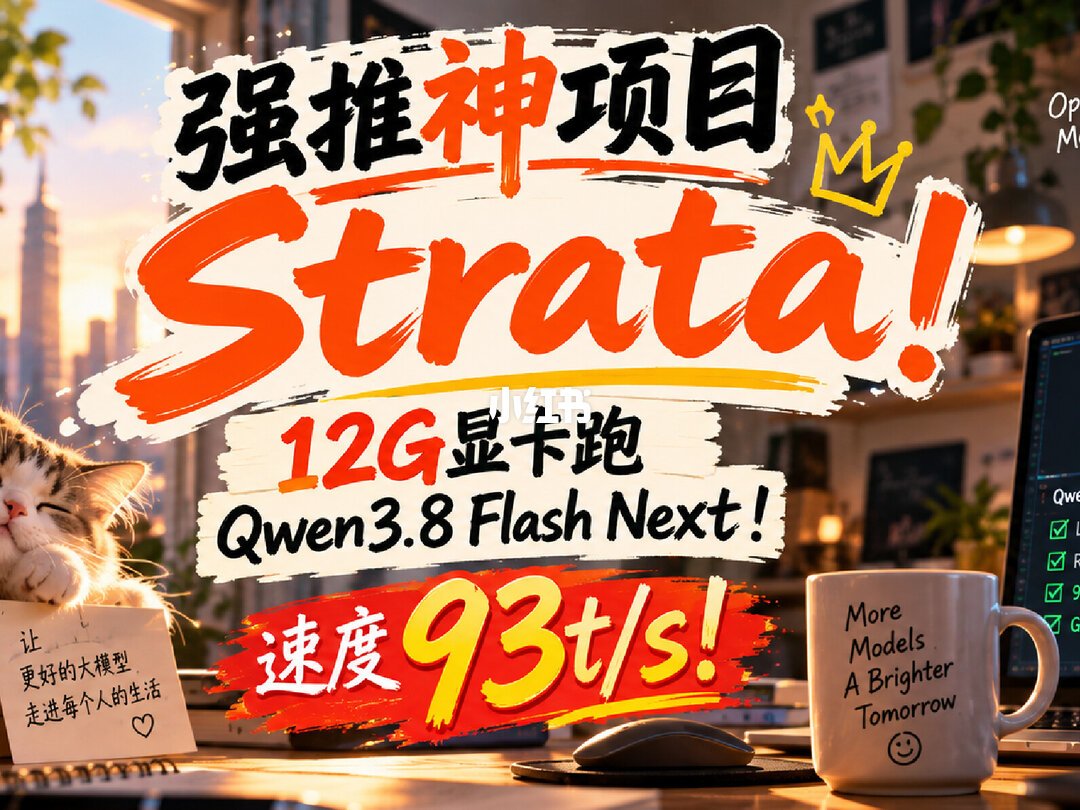 12G显卡畅跑Qwen3.8 Flash实测笔记封面
决定速度的其实是"仓库门多宽",不是算力
为什么和"显卡越强越快"的直觉有偏差?因为生成token时每步都要把权重基本完整地读一遍,瓶颈在内存带宽——那篇科普帖的比喻很准:仓库大小=内存容量(决定装不装得下),门宽=内存带宽(决定吐字快不快),工人数=GPU算力。公式就一行:token/s≈内存带宽÷模型体积。同一个8B模型,4090上约250 tok/s,Mac mini M4上约30 tok/s,差的就是带宽。小红书
于是这轮实测阵容才会这么杂:八通道内存的Ryzen AI Max+ 395(128GB统一内存)、4060 Ti、7900XTX、老服务器CPU……甚至有人验证了纯CPU路线:Qwen3.6-35B-A3B用ollama+docker纯CPU跑IQ4_NL量化也有8 tok/s。 这个速度"能跑",但谈不上流畅。另一端同样真实:有人在笔记本(Ultra X7358H)上跑Qwen3.8-27B-Q4,实测5.6 tok/s。。知乎热帖里"16G的Mac mini M4跑7B够不够用日常任务"也是同样的纠结。知乎知乎知乎
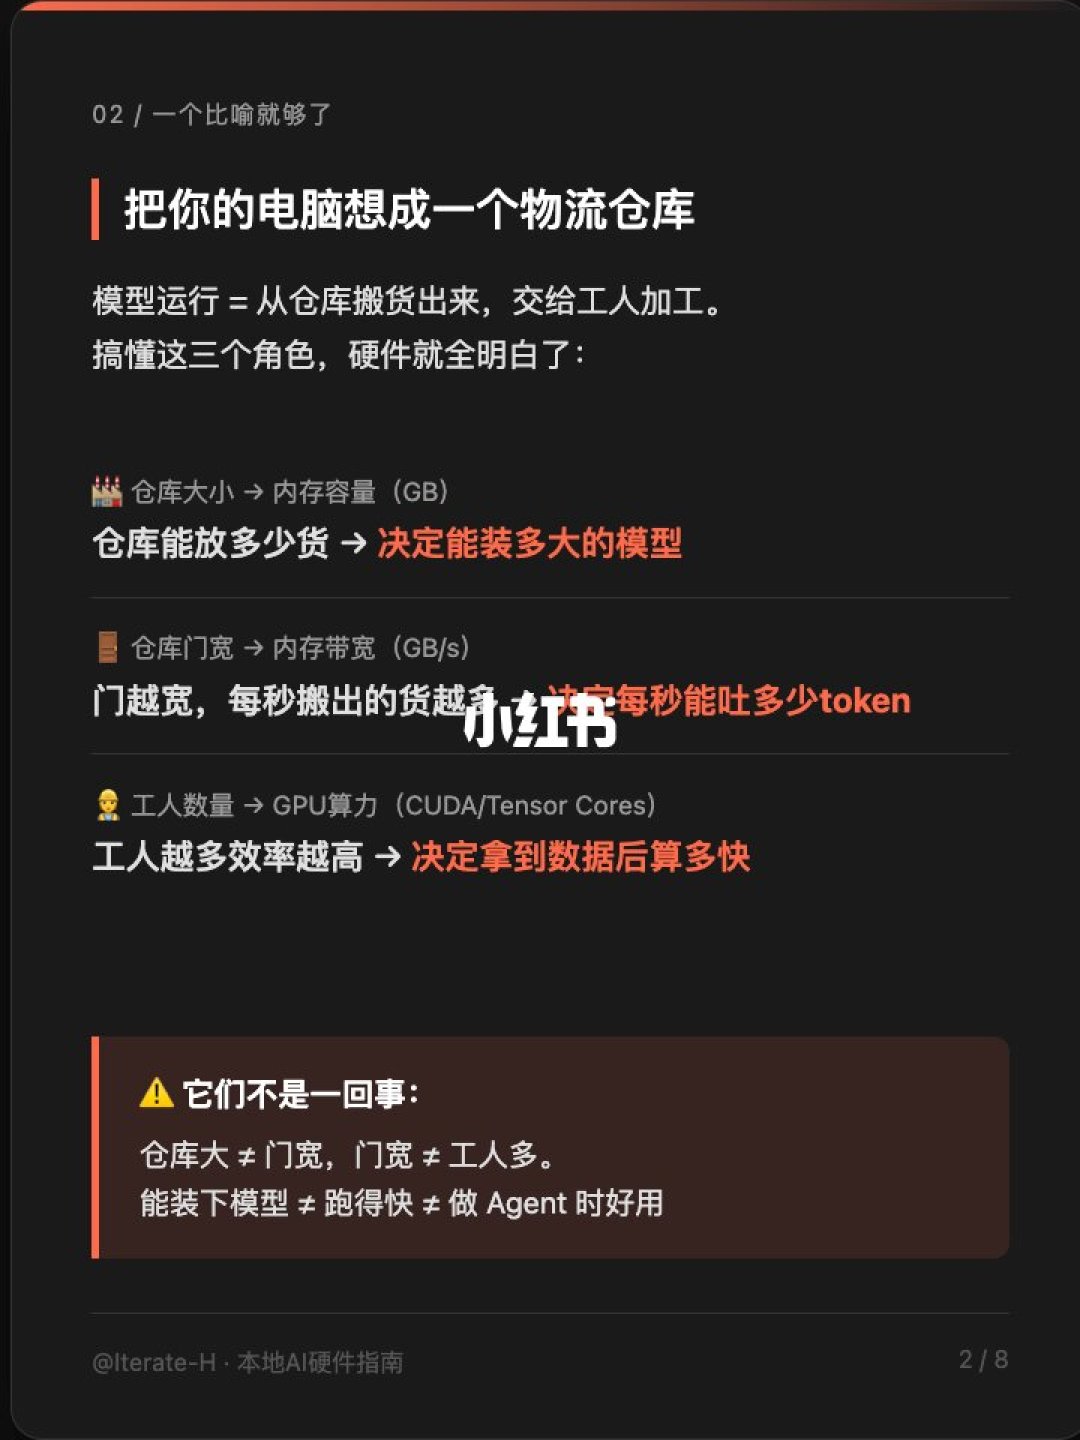 仓库比喻:内存容量、带宽与GPU算力科普卡片
分档速查:这周谁该跑哪个模型
先说表格出处之一:"厂商称68"那一行的原始帖来自小红书上一条硬件实测——两台T5000并联、256G显存,双机部署DeepSeek V4.1 Flash与GLM5.3 Flash,写代码68tok/s,同帖还有"四倍DGX Spark性能"的说法。小红书
你的机器 | 本周现实可跑 | 预期速度 | 备注 |
|---|---|---|---|
12~16G显存N卡+64G以上内存 | Qwen3.8-Flash-Next Q4/IQ3(Strata) | 40~100 tok/s | 大内存是前提,不是显卡的事 |
AI Max+ 395/128G统一内存或顶配Mac | Flash-Next全家桶、GLM-5.3-Flash(IQ2-XXS) | 20~50 | SnowLLM、Strata均已适配 |
8G显存老卡(3060/2060级) | 稠密27B-Q4聊天、小尺寸A3B | 5~25 | 评论区"64G内存只有8G显存"才是多数人 |
轻薄本/无独显 | Qwen3.6-35B-A3B纯CPU、7B级 | 1~8 | 别指望跑Agent长任务 |
256G内存怪/双T5000 NAS类 | DeepSeek V4.1-Flash、GLM-5.3-Flash | 厂商称68 | "四倍DGX Spark、7×24不降频"是卖货口径,听一半 |
家用32~64G普通PC | M3.1 Flash:仅关注,跑不动 | — | 428B Q4要214GB起装 |
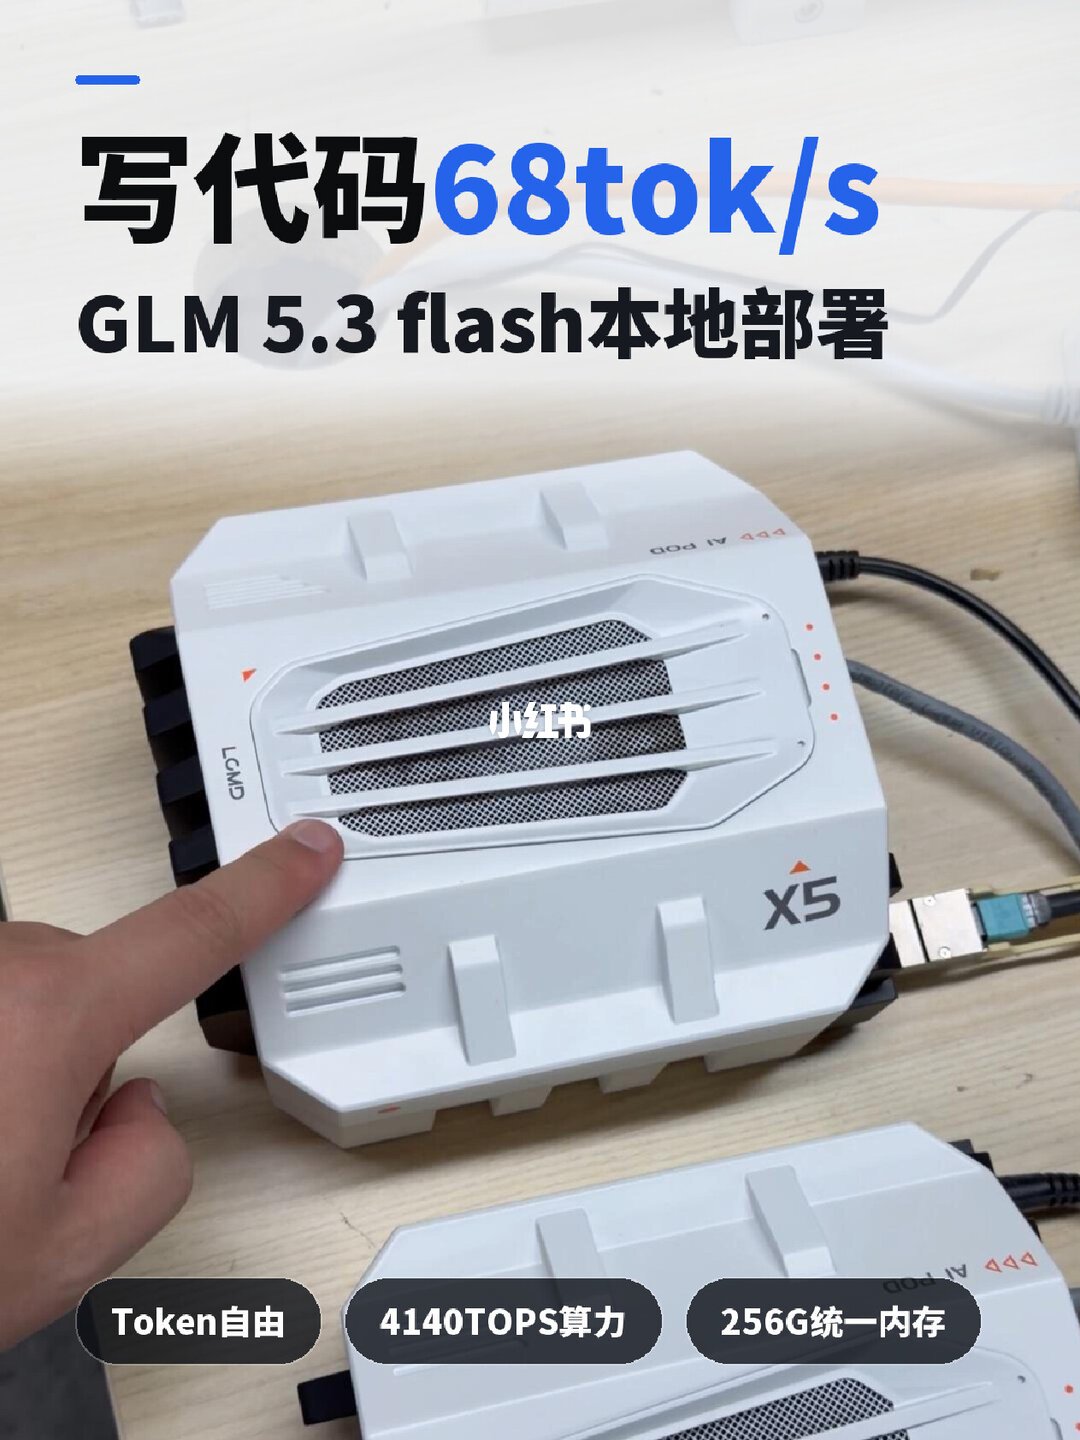 双T5000并联256G显存本地大模型主机实拍
本地还是云API:一分钟算清三笔账
用量账:云API按token付费,M3.1 Flash官方口径成本是上一代的1/3。 部分渠道上架时宣传"70%成本降幅、200+TPS",属推广口径。 V4.1-Flash-1017主打"许愿式编程"。月均调用不到几千万token、主要零散问答的人,云端天花板你一辈子摸不到。知乎知乎
硬件折旧账:本机闲置着"12G显存+64G内存"→本地几乎只剩电费,随便折腾;为了"跑上"专门加内存、买新卡、追八通道mini→那是给"显存焦虑"缴税,不如先继续订阅云端。
数据账:聊天记录、内部资料、客户文件不能出门,才是值得为新硬件掏钱的理由——但别过度自信:开源权重≠绝对安全,权重里也可能藏"内应",前面那个50美元实验已经敲过警钟。
企业侧的风向也在变:10月23日当天,讯飞对外算了一笔"60%推理跑在本地"的实账。 中国电信同日悄悄开源了主打本地的29B模型,实测被赞"会决策还能填空"。 "私有化还是直接调云API、先算清三笔账"的对比帖也在同一天出现。 ——"Flash段位"不是玩家自嗨,是产业链一起推的方向。知乎知乎知乎
坑与观察清单
引擎迭代比驱动还快:Strata目前v0.2.2,跨版本速度差异明显,装完别以为一劳永逸;
量化是质量的隐形之手:GSQ-RCO、Unsloth UD-Q4_K_XL、IQ2-XXS……同一模型多版本,文件小≠能用,连量化档位选择本身都成了实测课题。;知乎
AMD支持刚补上:7900XTX路线要靠Strata v0.2.2才顺;10月初的评论区还出现过"又不支持AMD"的抱怨。;小红书
DeepSeek 4.1之后本地更难:老玩家直言"deepseek到4.1之后本地部署就变得很难弄了,两台dgx-spark互连的上限就是GLM-5"(社区反馈,仅供参考)。;知乎
端点也有坑:GLM-5.3-flash与flashx两个端点的messages校验规则不一样,踩过400报错的人不少。知乎
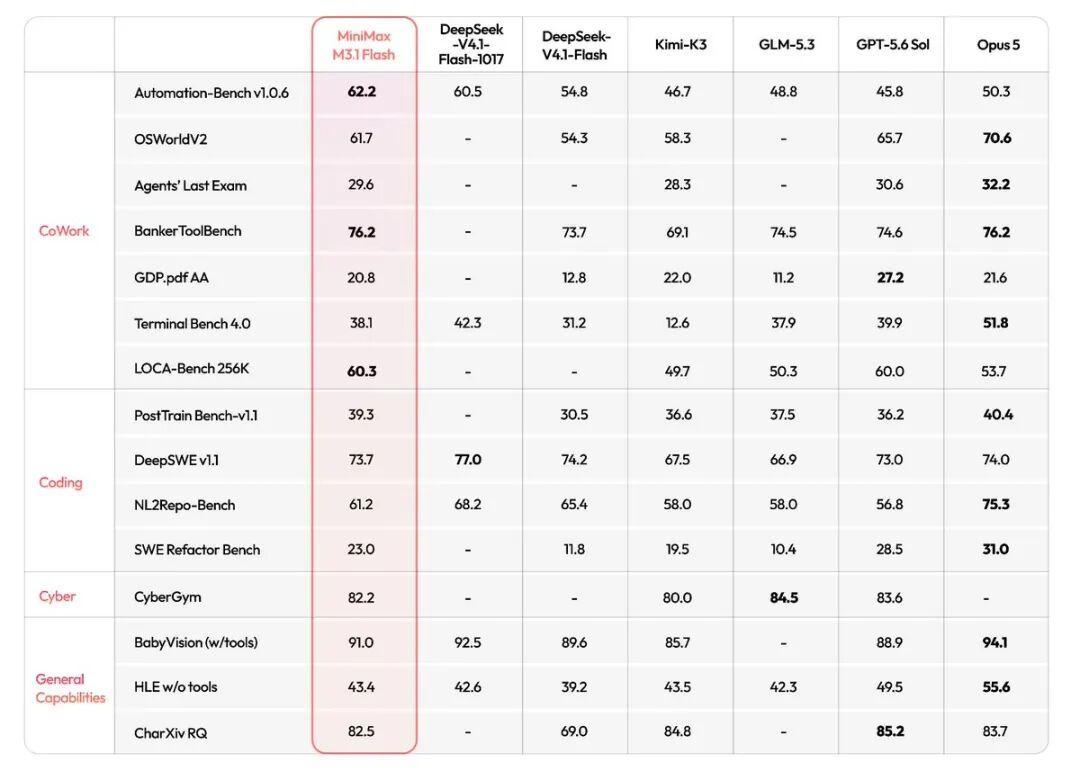 M3.1 Flash官方基准对比表
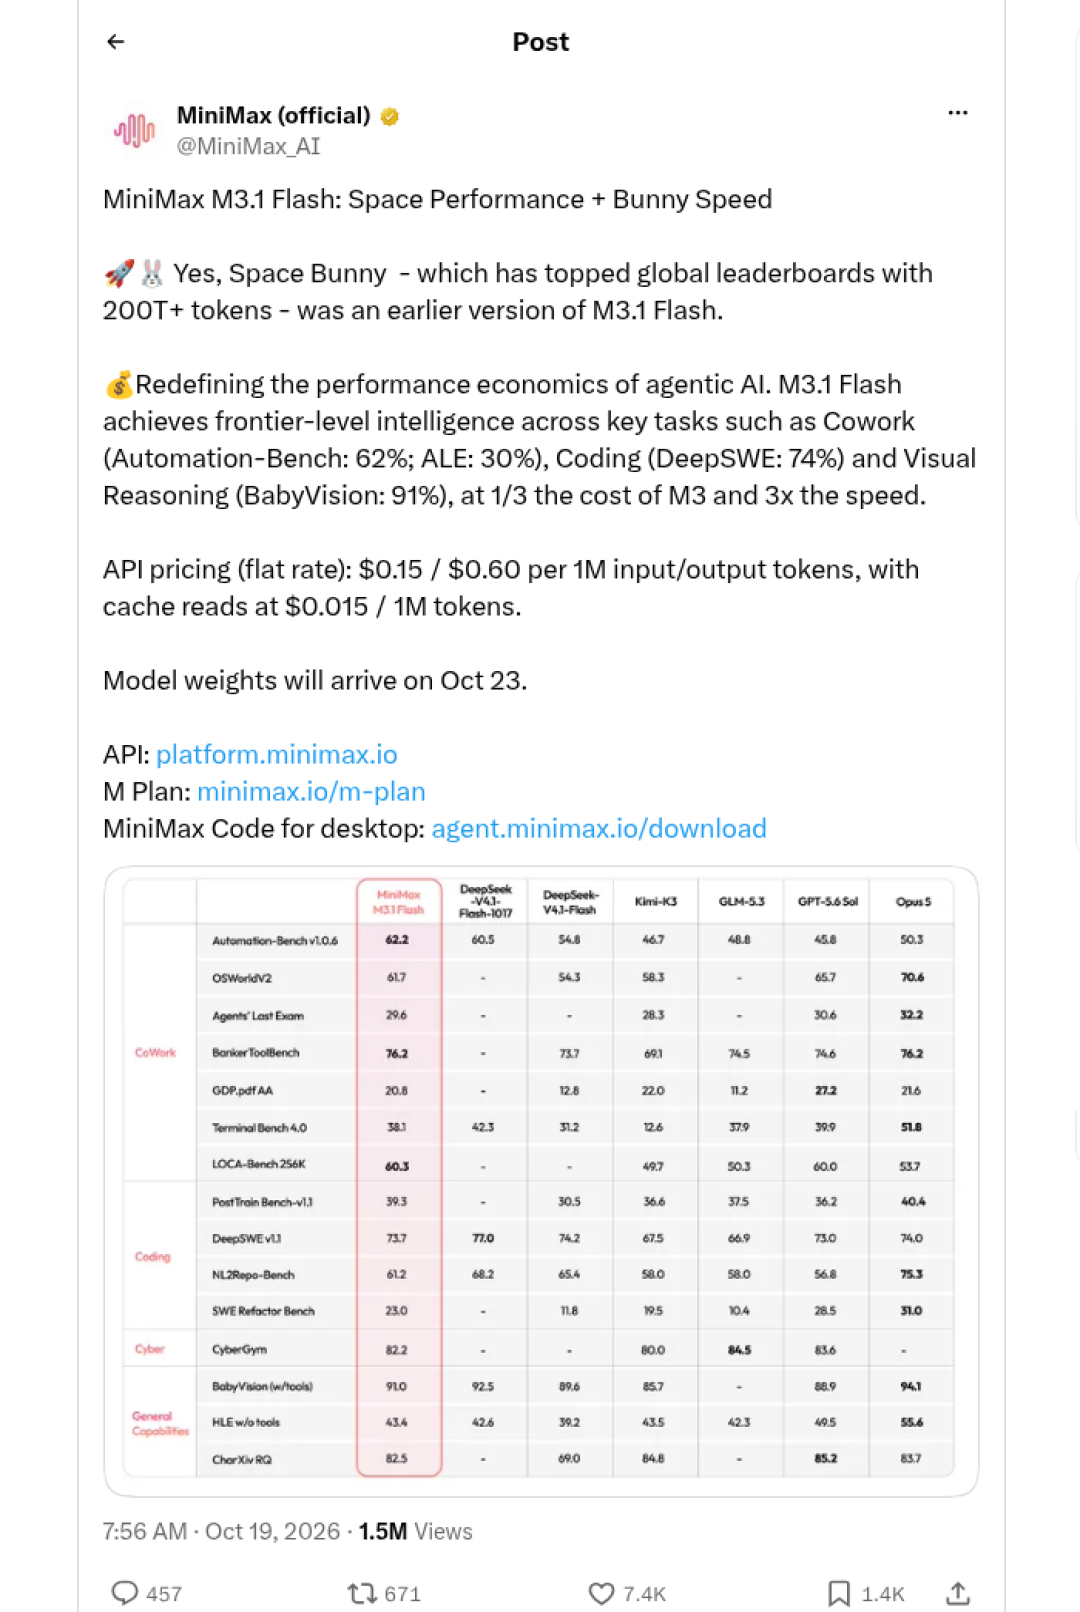 MiniMax官方开源公告帖实拍
小结
这个月的"Flash段位"开源潮,第一次把"家里跑旗舰级模型"从梗变成了说明书:12G显存+64G内存的老台式机确实能跑125B,但决定你体验的是内存带宽、量化版本和引擎进度,而不是显卡上的那个数字。建议的行动顺序:先口算自己的"参数÷2×1.5"够不够装,够就下unsloth的GGUF配Strata周末折腾一轮;8G显存以下从27B-Q4或A3B小模型起步;至于428B的M3.1 Flash,先放进观察清单,等官方量化和offload工具成熟——看热闹不花钱,抢跑才花钱。
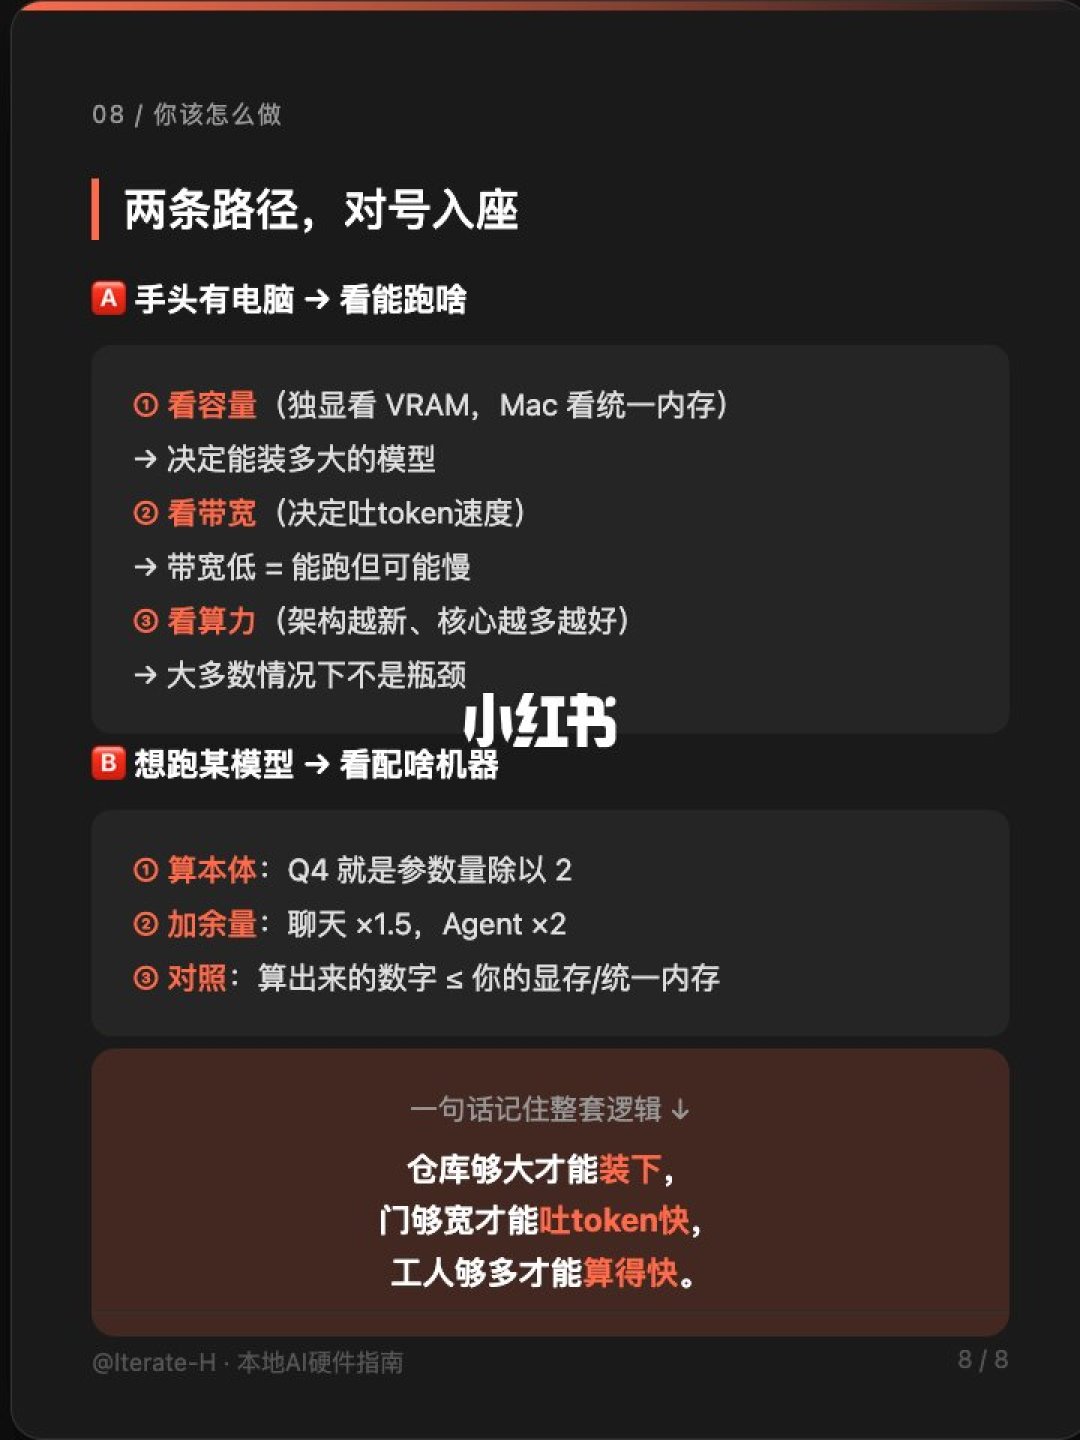 本地跑大模型从原理到实战科普卡片